Ce qu’est réellement une stratégie de citations en IA
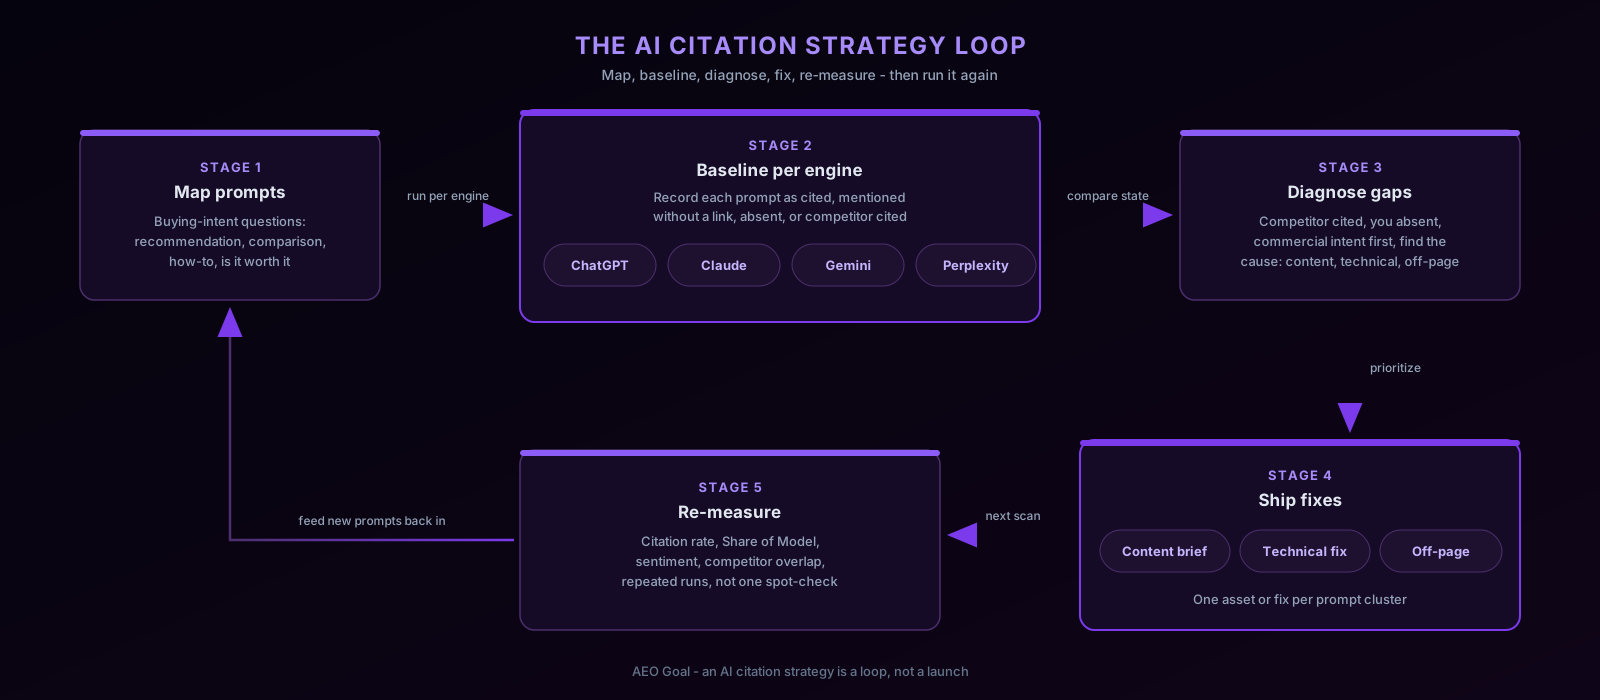
Une stratégie de citations en IA est une boucle reproductible, pas une liste de souhaits de contenu : cartographiez les prompts à intention d’achat que posent réellement vos acheteurs, établissez une base de référence de l’endroit où chaque moteur vous cite (vous, un concurrent ou personne), publiez un contenu citable par grappe de prompts, sécurisez l’accès des robots et des descriptions cohérentes chez les tiers, puis remesurez le taux de citations et le Share of Model selon une cadence fixe. L’unité que vous optimisez est la citation en IA : l’URL d’une source qu’un moteur de réponse affiche pour étayer une réponse générée. Une citation est plus forte qu’une mention en IA car elle porte un lien sur lequel l’acheteur peut cliquer et un signal que le moteur a suffisamment fait confiance à votre page pour la nommer. Tout ce qui suit existe pour faire de vos pages celles qui sont récupérées, extraites et liées, encore et encore.
Comment les moteurs de réponse choisissent ce qu’ils citent
Tout assistant majeur qui cite ses sources fonctionne en deux étapes : récupérer, puis générer. Il extrait d’abord des documents candidats pour la requête depuis un index de recherche ou une exploration en direct ; ensuite un modèle de langage compose la réponse et attache des citations à certains de ces documents. Ce mécanisme dicte toute la stratégie. Si votre page n’est pas dans l’ensemble de récupération, aucune qualité de rédaction ne la fera citer. Si elle est récupérée mais que le passage qui contient la réponse est enterré, tergiversant ou réparti entre plusieurs sections, le modèle cite quelqu’un d’autre. Vous devez gagner les deux étapes.
Les moteurs diffèrent quant à l’origine de la récupération et à la fréquence des citations, et ces différences changent ce que vous faites en premier :
| Moteur | Source de récupération | Quand il cite | Ce que cela signifie pour vous |
|---|---|---|---|
| Perplexity | Récupération web en direct sur presque toutes les requêtes | Cite dans presque toutes les réponses | La boucle de feedback la plus rapide ; les pages fraîches et extractibles peuvent apparaître vite |
| ChatGPT | Son moteur de recherche s’appuie sur l’index de Bing lorsqu’il navigue ou recherche | Surtout lorsque la navigation ou la recherche est déclenchée | L’indexation dans Bing est un prérequis ; vérifiez-la dans Bing Webmaster Tools |
| Gemini | L’index de Google ; le jeton Google-Extended contrôle l’accès à l’entraînement séparément de la recherche | Cite lorsqu’il fonde ses réponses sur des pages récupérées | L’indexation et l’explorabilité dans Google se répercutent ; ne bloquez pas Google-Extended par réflexe sans décider de ce que vous sacrifiez |
| Claude | La recherche web, lorsqu’elle est activée pour la conversation | Cite lorsque la recherche web est activée | L’explorabilité standard et une structure de réponse claire sont ce qu’il peut récompenser |
Deux conséquences pratiques. Premièrement, Bing Webmaster Tools n’est plus optionnel : si le moteur de recherche de ChatGPT s’appuie sur l’index de Bing, un site qui n’y a jamais été vérifié navigue à l’aveugle sur la couche de récupération qui se trouve derrière l’assistant le plus utilisé. L’intégration avec Bing Webmaster d’AEO Goal existe précisément pour cela. Deuxièmement, votre SEO Google actuel n’est pas gaspillé, car Gemini récupère depuis l’index que vous optimisez déjà depuis longtemps. Les moteurs n’ont pas remplacé les index de recherche ; ils s’appuient dessus.
Cartographiez un portefeuille de prompts avant d’écrire quoi que ce soit
Les citations ne comptent que pour les prompts que les acheteurs posent réellement, donc le premier livrable est un portefeuille de prompts, pas une page. Construisez-le à partir de quatre familles d’intention d’achat :
- Recommandation : « meilleure [catégorie] pour [segment] », « que devrait utiliser un [rôle] pour [tâche] »
- Comparaison : « [vous] vs [concurrent] », « alternatives à [concurrent] »
- Tutoriel : « comment faire [tâche que fait votre produit] », où la réponse nomme naturellement des outils
- Évaluation : « [produit] vaut-il le coup ? », « [produit] est-il bon pour [cas d’usage] ? »
Pour chaque prompt, enregistrez l’un des quatre états par moteur : cité (votre URL apparaît comme source), mentionné sans lien (nommé dans le texte, sans citation), absent ou concurrent cité. Cette grille d’états est votre base de référence, et elle est délibérément par moteur, car le même prompt produit régulièrement des gagnants différents sur Perplexity et sur ChatGPT.
Ensuite, priorisez avec une seule règle de décision : intention commerciale x concurrent cité x vous absent, en premier. Un prompt qui remplit les trois conditions est une réponse qui dirige activement les acheteurs vers un rival en ce moment même. Un prompt informationnel à fort volume où personne n’est cité peut attendre ; un prompt de niche « alternatives à [concurrent] » où la citation est la propre page de comparaison du concurrent ne le peut pas. Travaillez la grille de haut en bas selon cette règle et vous ne consacrerez jamais un sprint à un prompt qui ne peut pas générer de chiffre d’affaires.
Le guide de recherche de mots-clés explique comment assembler l’ensemble de questions de façon systématique, et le guide de la fonctionnalité prompts montre comment coder le portefeuille sous forme de prompts suivis plutôt qu’une feuille de calcul qui pourrit.
Créez des contenus qu’un moteur peut réellement extraire
Au moment de la génération, le modèle a besoin d’un fragment autonome qu’il puisse citer ou paraphraser avec attribution. Quatre formats survivent de façon fiable à cette extraction :
- Réponses directes. La question répondue dans les deux ou trois premières phrases, avec la nuance (« pour les équipes de moins de 50 », « pour les déploiements auto-hébergés ») déclarée, pas sous-entendue. Si un lecteur doit assembler la conclusion à partir de trois sections, le modèle aussi, et il ne le fera pas.
- Tableaux. Les tableaux de comparaison et de spécifications donnent au modèle des faits préstructurés : les lignes correspondent aux entités, les colonnes aux attributs. Une ligne de tableau est ce qu’un moteur peut extraire avec précision le plus facilement.
- Définitions. Une définition nette d’une phrase pour un terme que vous voulez vous approprier, suivie de la nuance. Les définitions circulaires (« une stratégie de citations en IA est une stratégie pour les citations en IA ») sont écartées.
- Tutoriels originaux. Des étapes numérotées avec les commandes, réglages ou seuils réels. Un tutoriel qui dit « configurez vos réglages de manière appropriée » est du remplissage ; celui qui nomme le réglage et la valeur est citable.
Publiez un contenu par grappe de prompts, pas une page par prompt. « Meilleure [catégorie] pour les startups » et « meilleurs outils de [catégorie] pour les petites équipes » forment une même grappe et méritent une seule page faisant autorité ; les séparer produit deux pages minces qui perdent face à l’unique page forte d’un concurrent. Balisez chaque contenu avec des données structurées pour que les entités et les paires question-réponse soient lisibles par les machines ; Google documente le vocabulaire dans son introduction aux données structurées. Le cadre d’optimisation de contenu couvre en profondeur la structure de page answer-first, et si vous rédigez à grande échelle, la génération de contenu AEO produit des brouillons en forme de citation plutôt qu’un texte de blog générique.
Gagnez la surface de tiers que vous ne contrôlez pas
Pour les prompts de recommandation et de comparaison, les moteurs récupèrent habituellement des pages qui comparent de nombreux fournisseurs : sites d’avis, listes des « meilleurs », fils de communauté et hubs de documentation. Si ces pages vous décrivent de façon inexacte, incohérente ou vous omettent, le moteur hérite de cette image quelle que soit la qualité de votre propre site. Le travail off-page pour les citations signifie :
- Être présent sur les pages déjà récupérées. Votre grille de référence montre quelles URL de tiers chaque moteur cite pour chaque prompt ; réussir à y figurer avec précision sur ces pages précises vaut mieux que démarcher au hasard une centaine d’autres. C’est du link building recentré : la liste cible provient des citations réelles, pas de feuilles de calcul d’autorité de domaine.
- Maintenir l’entité cohérente. Les moteurs résolvent les mentions en entités en faisant correspondre les noms, catégories et affirmations entre les sources. Si vous êtes « Acme Analytics » sur votre site, « Acme AI » sur un site d’avis et « Acme » dans votre documentation, vous fragmentez l’entité et affaiblissez chaque mention individuelle. Choisissez un nom de marque, une expression de catégorie et une affirmation centrale, et imposez-les partout où vous pouvez éditer ou demander une modification.
- Corriger les descriptions erronées. Un modèle de tarification obsolète ou une fonctionnalité abandonnée sur une page d’avis fréquemment récupérée sera répété mot pour mot dans les réponses. Corriger une page erronée à forte récupération pèse plus que publier trois nouveaux articles.
L’éligibilité technique est une barrière, pas un facteur de classement
Tout ce qui précède suppose que les moteurs peuvent récupérer et lire vos pages. Cette hypothèse échoue silencieusement et souvent :
- Accès des robots. Chaque moteur récupère le contenu avec des user agents nommés, et OpenAI documente ses bots séparément pour l’entraînement, les récupérations déclenchées par l’utilisateur et la recherche. Google, de même, documente ses robots, y compris Google-Extended, qui contrôle l’accès à l’entraînement de l’IA sans affecter la recherche. Auditez vos règles robots.txt par rapport à ces deux listes actuelles : une règle bien intentionnée de « bloquer tous les bots » datant de 2023 pourrait aujourd’hui vous exclure de tous les moteurs de réponse. Un fichier llms.txt ajoute par-dessus une carte lisible par les machines de vos pages les plus citables.
- Réponses rendues côté serveur. Si votre réponse directe n’existe qu’après l’exécution du JavaScript côté client, un récupérateur qui ne rend pas le JS voit une div vide là où devrait se trouver votre paragraphe digne d’une citation. Le contenu qui porte la réponse doit se trouver dans le HTML rendu côté serveur.
- Indexation. Ne pas être récupérable dans Bing signifie ne pas être récupérable par la recherche de ChatGPT ; ne pas être indexé dans Google signifie être invisible pour le grounding de Gemini.
Traitez ceci comme un « réussi ou échoué » par page, et franchissez cette barrière avant d’investir dans le contenu : un robot bloqué gâche chaque contenu qui se trouve derrière. La liste de vérification complète se trouve dans la liste de vérification du SEO technique.
Mesurez la boucle : taux de citations, Share of Model, sentiment
Les réponses générées sont stochastiques. Le même prompt, sur le même moteur, le même jour, peut renvoyer une réponse différente avec des sources différentes d’une exécution à l’autre, et les moteurs révisent leur comportement en continu. Une capture d’écran d’une citation est une anecdote ; une absence n’est pas un diagnostic. Quatre métriques, suivies sur des exécutions programmées répétées, remplacent les anecdotes par des preuves :
- Taux de citations : la proportion d’exécutions d’un prompt où votre URL apparaît comme source, par moteur au fil du temps. Consultez le guide de la fonctionnalité citations pour savoir comment il est calculé.
- Share of Model : le pourcentage de réponses de la catégorie qui vous nomment par rapport à chaque concurrent, pour savoir si vous gagnez ou perdez du terrain au sein des réponses elles-mêmes ; le guide de la fonctionnalité Share of Model couvre la mécanique, et l’analytique du Share of Model montre les rapports.
- Sentiment et cadrage : si la description que le moteur fait de vous est exacte et favorable, car être cité comme l’« option datée mais bon marché » est un problème différent de l’absence.
- Recouvrement avec les concurrents : dans quels prompts vous et un concurrent nommé apparaissez tous les deux, et lesquels ils possèdent entièrement, via la visibilité dans l’IA des concurrents.
Fixez la cadence selon l’intention : vérifications hebdomadaires pour les prompts commerciaux où vous publiez activement des correctifs, mensuelles pour la longue traîne stable. Jugez tout correctif sur plusieurs exécutions après le changement, jamais sur la première réponse que vous voyez par hasard.

Modes d’échec courants
- Optimiser des prompts que personne ne pose. Un portefeuille inventé lors d’un brainstorming plutôt que tiré de vraies questions d’acheteurs produit des citations que personne ne voit. Chaque prompt devrait pouvoir remonter à une question d’un appel commercial, un ticket de support ou une requête à demande de recherche démontrée.
- Poursuivre un moteur pendant que les acheteurs en utilisent un autre. Les équipes se surorientent vers ChatGPT parce qu’il est célèbre, tandis que leurs vrais acheteurs font leurs recherches sur Perplexity ou Gemini. La grille de référence par moteur existe pour éviter cela : investissez là où vos états sont les pires sur les moteurs qu’utilise votre marché.
- Traiter une citation heureuse comme une victoire durable. Les réponses stochastiques donnent et retirent des citations d’une exécution à l’autre. Ne déclarez la victoire que lorsque le taux de citations se maintient sur une cadence de scans, pas lorsqu’une capture d’écran a fière allure.
- Publier avant de franchir la barrière d’éligibilité. Un trimestre de travail de contenu derrière un blocage robots.txt ou une réponse rendue côté client produit exactement zéro citation. La barrière d’abord, l’écriture ensuite.
- Diviser une grappe en cinq pages minces. Les moteurs extraient l’unique source la plus forte pour une question ; cinq pages partielles perdent face à l’unique page complète d’un concurrent.
Comment AEO Goal referme la boucle
Exécuter ce playbook à la main signifie une feuille de calcul de prompts, quatre onglets de navigateur et un rituel de revérification que personne ne tient au-delà de la troisième semaine. Le suivi des citations en IA d’AEO Goal exécute la boucle sous forme de logiciel : il lance votre portefeuille de prompts contre ChatGPT, Claude, Gemini et Perplexity selon un calendrier et enregistre la grille d’états par prompt et par moteur, exactement comme le documente la méthodologie, rien que des réponses mesurées, rien de simulé.
La différence avec les outils de suivi seul, c’est ce qui se passe dans l’écart. Exemple illustratif : un scan montre que pour « meilleure [catégorie] pour les équipes mid-market », Perplexity cite la page de comparaison d’un concurrent tandis que vous êtes absent à chaque exécution. AEO Goal fait ressortir ce prompt précis, l’URL que le moteur a citée et la cause diagnostiquée : aucune de vos pages ne répond directement à la question, ou celle qui le devrait est bloquée pour un robot, ou votre réponse ne se rend que côté client. Il publie ensuite le correctif : un brief de contenu answer-first cadré sur cette grappe de prompts, ou le changement précis de schema ou d’accès des robots, priorisé selon la même règle d’intention commerciale d’abord qu’utilise ce guide. Au scan suivant, il vérifie si le correctif a déplacé le taux de citations et le Share of Model, de sorte que chaque action reçoit un verdict plutôt qu’un espoir. Le suivi de la visibilité dans l’IA agrège les résultats au niveau des prompts dans la tendance qu’un décideur lit réellement.
Les citations se conjuguent avec le SEO traditionnel
Le mécanisme récupérer-puis-générer rend ceci concret plutôt que motivant : les moteurs récupèrent depuis les index de recherche, donc le travail qui améliore les positions alimente la couche d’où proviennent les citations. L’indexation vous rend récupérable dans Bing pour la recherche de ChatGPT et dans Google pour Gemini. Les backlinks et l’autorité influencent quels candidats récupérés sont jugés fiables au moment de la génération, et les pages de tiers qui vous lient sont fréquemment les pages mêmes que les moteurs citent pour les prompts de recommandation. La recherche de mots-clés et la cartographie de prompts sont la même discipline pointée vers deux interfaces. Exécutez-les comme un seul programme avec un seul backlog, et chaque contenu rapporte deux fois : une position sur la page de résultats et une citation dans la réponse au-dessus. AEO face au SEO traditionnel cartographie où les deux disciplines divergent, qu’est-ce que l’AEO couvre les fondamentaux, et la liste de vérification AEO transforme ce playbook en une liste de tâches pour la première semaine.