Qué es realmente una estrategia de citas en IA
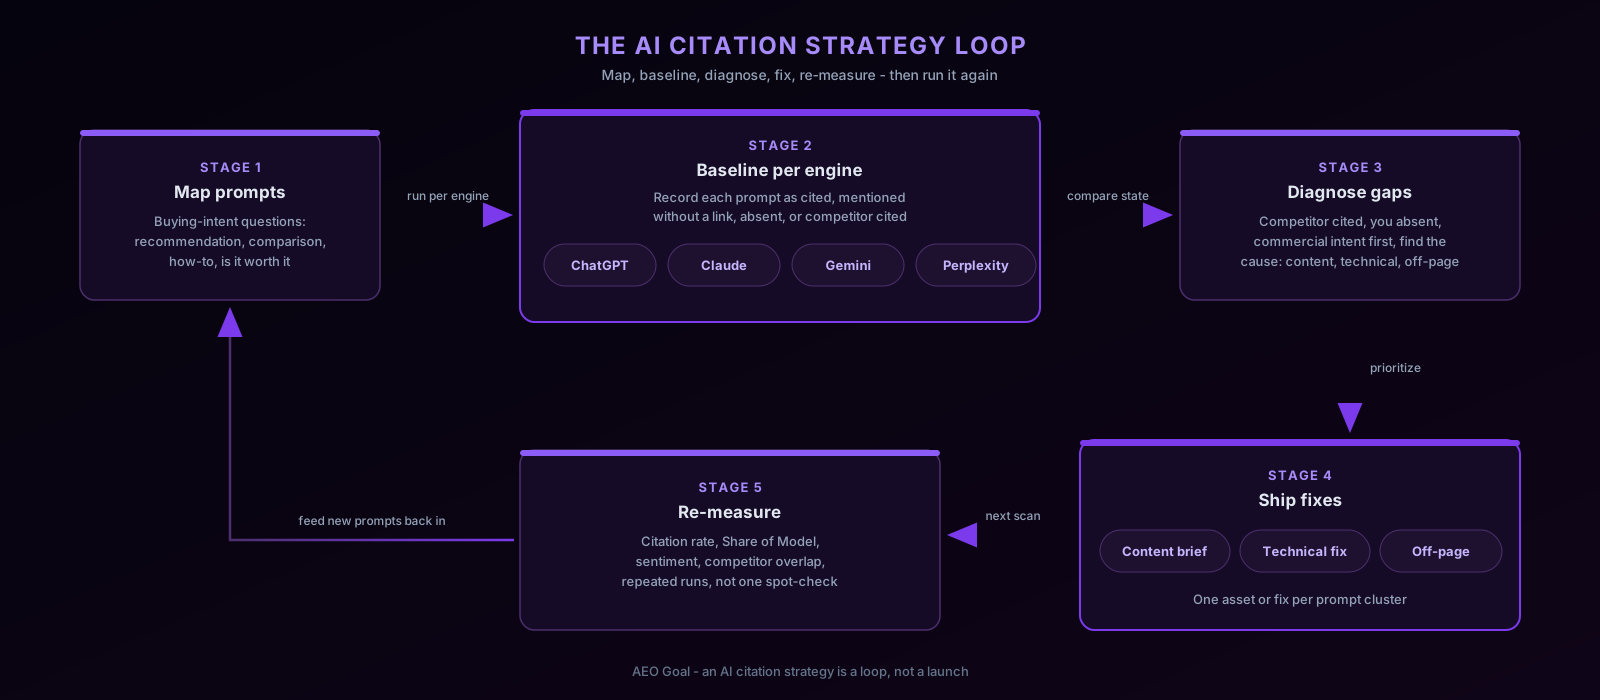
Una estrategia de citas en IA es un bucle repetible, no una lista de deseos de contenidos: mapea los prompts con intención de compra que hacen realmente tus compradores, establece una línea base de dónde te cita cada motor (a ti, a un competidor o a nadie), publica un activo citable por cada clúster de prompts, asegura el acceso de los rastreadores y descripciones de terceros coherentes, y vuelve a medir la tasa de citas y el Share of Model con una cadencia fija. La unidad que estás optimizando es la cita en IA: la URL de una fuente que un motor de respuestas muestra para respaldar una respuesta generada. Una cita es más fuerte que una mención en IA porque lleva un enlace en el que el comprador puede hacer clic y una señal de que el motor confió lo suficiente en tu página como para nombrarla. Todo lo que viene a continuación existe para lograr que tus páginas sean las que se recuperan, se extraen y se enlazan, una y otra vez.
Cómo eligen los motores de respuestas qué citar
Todo asistente relevante que cita fuentes funciona en dos pasos: recuperar y luego generar. Primero extrae documentos candidatos para la consulta de un índice de búsqueda o de un rastreo en directo; después un modelo de lenguaje compone la respuesta y adjunta citas a algunos de esos documentos. Ese mecanismo dicta toda la estrategia. Si tu página no está en el conjunto de recuperación, ninguna calidad de redacción conseguirá que la citen. Si se recupera pero el pasaje que contiene la respuesta está enterrado, lleno de rodeos o repartido entre secciones, el modelo cita a otro. Tienes que ganar los dos pasos.
Los motores difieren en de dónde procede la recuperación y con qué frecuencia citan, y esas diferencias cambian lo que haces primero:
| Motor | Fuente de recuperación | Cuándo cita | Qué significa para ti |
|---|---|---|---|
| Perplexity | Recuperación web en directo en casi todas las consultas | Cita en casi todas las respuestas | El ciclo de feedback más rápido; las páginas frescas y extraíbles pueden aparecer con rapidez |
| ChatGPT | Su motor de búsqueda se apoya en el índice de Bing cuando navega o busca | Sobre todo cuando se invoca la navegación o la búsqueda | La indexación en Bing es un requisito previo; verifícala en Bing Webmaster Tools |
| Gemini | El índice de Google; el token Google-Extended controla el acceso para entrenamiento por separado de la Búsqueda | Cita cuando fundamenta las respuestas en páginas recuperadas | La indexación y la rastreabilidad en Google se trasladan; no bloquees Google-Extended por reflejo sin decidir qué estás sacrificando |
| Claude | Búsqueda web, cuando está activada para la conversación | Cita cuando la búsqueda web está activada | La rastreabilidad estándar y una estructura de respuesta clara son lo que puede recompensar |
Dos consecuencias prácticas. Primera, Bing Webmaster Tools ya no es opcional: si el motor de búsqueda de ChatGPT se apoya en el índice de Bing, un sitio que nunca se verificó allí navega a ciegas en la capa de recuperación que está detrás del asistente más usado. La integración con Bing Webmaster de AEO Goal existe precisamente por esto. Segunda, tu SEO de Google actual no se desperdicia, porque Gemini recupera del índice que ya llevas tiempo optimizando. Los motores no reemplazaron a los índices de búsqueda; se apoyan encima de ellos.
Mapea una cartera de prompts antes de escribir nada
Las citas solo importan para prompts que los compradores realmente hacen, así que el primer entregable es una cartera de prompts, no una página. Constrúyela a partir de cuatro familias de intención de compra:
- Recomendación: “mejor [categoría] para [segmento]”, “qué debería usar un [rol] para [tarea]”
- Comparación: “[tú] vs [competidor]”, “alternativas a [competidor]”
- Tutorial: “cómo hago [tarea que hace tu producto]”, donde la respuesta nombra herramientas de forma natural
- Evaluación: “¿merece la pena [producto]?”, “¿es [producto] bueno para [caso de uso]?”
Para cada prompt, registra uno de cuatro estados por motor: citado (tu URL aparece como fuente), mencionado sin enlace (nombrado en el texto, sin cita), ausente o competidor citado. Esa cuadrícula de estados es tu línea base, y es deliberadamente por motor, porque el mismo prompt suele producir ganadores distintos en Perplexity que en ChatGPT.
Después prioriza con una única regla de decisión: intención comercial x competidor citado x tú ausente, primero. Un prompt que cumple las tres condiciones es una respuesta que está dirigiendo activamente a los compradores hacia un rival ahora mismo. Un prompt informativo de alto volumen donde no se cita a nadie puede esperar; un prompt de nicho de “alternativas a [competidor]” donde la cita es la propia página de comparación del competidor no puede. Trabaja la cuadrícula de arriba abajo con esa regla y nunca dedicarás un sprint a un prompt que no puede mover ingresos.
La guía de investigación de palabras clave cubre cómo ensamblar el conjunto de preguntas de forma sistemática, y la guía de la función de prompts muestra cómo codificar la cartera como prompts monitorizados en lugar de una hoja de cálculo que se pudre.
Crea activos que un motor pueda extraer de verdad
En el momento de la generación, el modelo necesita un fragmento autocontenido que pueda citar o parafrasear con atribución. Cuatro formatos sobreviven de forma fiable a esa extracción:
- Respuestas directas. La pregunta respondida en las dos o tres primeras frases, con el matiz (“para equipos de menos de 50”, “para despliegues autohospedados”) declarado, no implícito. Si un lector tiene que armar la conclusión a partir de tres secciones, el modelo también, y no lo hará.
- Tablas. Las tablas de comparación y de especificaciones dan al modelo hechos preestructurados: las filas se corresponden con entidades, las columnas con atributos. Una fila de tabla es lo más fácil de extraer con precisión para un motor.
- Definiciones. Una definición nítida de una frase de un término que quieres apropiarte, seguida del matiz. Las definiciones circulares (“una estrategia de citas en IA es una estrategia para las citas en IA”) se descartan.
- Tutoriales originales. Pasos numerados con los comandos, ajustes o umbrales reales. Un tutorial que dice “configura tus ajustes de forma apropiada” es relleno; uno que nombra el ajuste y el valor es citable.
Publica un activo por clúster de prompts, no una página por prompt. “Mejor [categoría] para startups” y “mejores herramientas de [categoría] para equipos pequeños” son un mismo clúster y merecen una única página con autoridad; dividirlos produce dos páginas endebles que pierden frente a la única página fuerte de un competidor. Marca cada activo con datos estructurados para que las entidades y los pares pregunta-respuesta sean legibles por máquinas; Google documenta el vocabulario en su introducción a los datos estructurados. El marco de optimización de contenidos cubre en profundidad la estructura de página answer-first, y si redactas a gran escala, la generación de contenidos AEO produce borradores con forma de cita en lugar de texto de blog genérico.
Gana la superficie de terceros que no controlas
Para los prompts de recomendación y comparación, los motores recuperan de forma habitual páginas que comparan muchos proveedores: sitios de reseñas, listas de “los mejores”, hilos de comunidad y hubs de documentación. Si esas páginas te describen de forma inexacta, incoherente o te omiten, el motor hereda esa imagen por muy buena que sea tu propia web. El trabajo off-page para las citas significa:
- Estar presente en las páginas que ya se están recuperando. Tu cuadrícula base muestra qué URLs de terceros cita cada motor para cada prompt; conseguir aparecer con precisión en esas páginas concretas es mejor que lanzar propuestas a cien al azar. Esto es link building reenfocado: la lista objetivo sale de las citas reales, no de hojas de cálculo de autoridad de dominio.
- Mantener la entidad coherente. Los motores resuelven las menciones en entidades emparejando nombres, categorías y afirmaciones entre fuentes. Si eres “Acme Analytics” en tu web, “Acme AI” en un sitio de reseñas y “Acme” en tu documentación, fragmentas la entidad y debilitas cada mención individual. Elige un nombre de marca, una frase de categoría y una afirmación central, e imponlos en todos los sitios donde puedas editar o solicitar una edición.
- Corregir descripciones erróneas. Un modelo de precios desactualizado o una función descontinuada en una página de reseñas que se recupera con frecuencia se repetirá literalmente en las respuestas. Corregir una página incorrecta de alta recuperación pesa más que publicar tres artículos nuevos.
La elegibilidad técnica es una barrera, no un factor de ranking
Todo lo anterior asume que los motores pueden obtener y leer tus páginas. Ese supuesto falla de forma silenciosa y a menudo:
- Acceso de los rastreadores. Cada motor obtiene contenido con user agents con nombre propio, y OpenAI documenta sus bots por separado para el entrenamiento, las obtenciones activadas por el usuario y la búsqueda. Google, igualmente, documenta sus rastreadores, incluido Google-Extended, que controla el acceso para entrenamiento de IA sin afectar a la Búsqueda. Audita tus reglas de robots.txt contra ambas listas actuales: una regla bienintencionada de “bloquear todos los bots” de 2023 podría estar excluyéndote hoy de todos los motores de respuestas. Un archivo llms.txt añade además un mapa legible por máquinas de tus páginas más citables.
- Respuestas renderizadas en el servidor. Si tu respuesta directa solo existe después de que se ejecute el JavaScript del lado del cliente, un fetcher que no renderiza JS ve un div vacío donde debería estar tu párrafo digno de cita. El contenido que contiene la respuesta debe estar en el HTML renderizado en el servidor.
- Indexación. No ser recuperable en Bing significa no ser recuperable por la búsqueda de ChatGPT; no estar indexado en Google significa ser invisible para el grounding de Gemini.
Trata esto como aprobado o suspenso por página, y supéralo antes de invertir en contenido: un rastreador bloqueado echa a perder cada activo que hay detrás. La lista de verificación completa está en la lista de verificación de SEO técnico.
Mide el bucle: tasa de citas, Share of Model, sentimiento
Las respuestas generadas son estocásticas. El mismo prompt, en el mismo motor, el mismo día, puede devolver una respuesta distinta con fuentes distintas entre una ejecución y otra, y los motores revisan su comportamiento de forma continua. Una captura de pantalla de una cita es una anécdota; una ausencia no es un diagnóstico. Cuatro métricas, medidas en ejecuciones programadas repetidas, sustituyen las anécdotas por evidencias:
- Tasa de citas: la proporción de ejecuciones de un prompt en las que tu URL aparece como fuente, por motor a lo largo del tiempo. Consulta la guía de la función de citas para saber cómo se calcula.
- Share of Model: el porcentaje de respuestas de la categoría que te nombran a ti frente a cada competidor, para que sepas si estás ganando o perdiendo terreno dentro de las propias respuestas; la guía de la función Share of Model cubre la mecánica, y la analítica de Share of Model muestra los informes.
- Sentimiento y encuadre: si la descripción que el motor hace de ti es precisa y favorable, porque ser citado como la “opción anticuada pero barata” es un problema distinto de la ausencia.
- Solapamiento con competidores: en qué prompts apareceis tú y un competidor concreto, y cuáles poseen ellos por completo, mediante la visibilidad en IA de competidores.
Fija la cadencia según la intención: comprobaciones semanales para los prompts comerciales donde estás publicando correcciones de forma activa, mensuales para la cola larga estable. Juzga cualquier corrección con varias ejecuciones después del cambio, nunca con la primera respuesta que veas por casualidad.

Modos de fallo habituales
- Optimizar prompts que nadie pregunta. Una cartera inventada en una lluvia de ideas en lugar de extraída de preguntas reales de compradores produce citas que nadie ve. Cada prompt debería poder rastrearse hasta una pregunta de una llamada de ventas, un ticket de soporte o una consulta con demanda de búsqueda demostrada.
- Perseguir un motor mientras los compradores usan otro. Los equipos se sobreorientan hacia ChatGPT porque es famoso, mientras sus compradores reales investigan en Perplexity o Gemini. La cuadrícula base por motor existe para evitarlo: invierte donde tus estados son peores en los motores que usa tu mercado.
- Tratar una cita afortunada como una victoria duradera. Las respuestas estocásticas dan y quitan citas entre ejecuciones. Declara la victoria solo cuando la tasa de citas se sostiene a lo largo de una cadencia de escaneos, no cuando una captura de pantalla se ve bien.
- Publicar antes de superar la barrera de elegibilidad. Un trimestre de trabajo de contenido detrás de un bloqueo de robots.txt o de una respuesta renderizada en el cliente produce exactamente cero citas. Primero la barrera, después la escritura.
- Dividir un clúster en cinco páginas endebles. Los motores extraen la única fuente más fuerte para una pregunta; cinco páginas parciales pierden frente a la única página completa de un competidor.
Cómo AEO Goal cierra el bucle
Ejecutar este playbook a mano significa una hoja de cálculo de prompts, cuatro pestañas del navegador y un ritual de recomprobación que nadie sostiene más allá de la tercera semana. El seguimiento de citas en IA de AEO Goal ejecuta el bucle como software: lanza tu cartera de prompts contra ChatGPT, Claude, Gemini y Perplexity según un calendario y registra la cuadrícula de estados por prompt y por motor, exactamente como documenta la metodología, solo respuestas medidas, nada simulado.
La diferencia frente a las herramientas de solo seguimiento es lo que ocurre en la brecha. Ejemplo ilustrativo: un escaneo muestra que para “mejor [categoría] para equipos de mid-market”, Perplexity cita la página de comparación de un competidor mientras tú estás ausente en cada ejecución. AEO Goal saca a la luz ese prompt exacto, la URL que citó el motor y la causa diagnosticada: ninguna página tuya responde la pregunta directamente, o la que debería está bloqueada para un rastreador, o tu respuesta solo se renderiza en el cliente. Después publica la corrección: un brief de contenido answer-first acotado a ese clúster de prompts, o el cambio concreto de schema o de acceso del rastreador, priorizado por la misma regla de intención comercial primero que usa esta guía. En el siguiente escaneo comprueba si la corrección movió la tasa de citas y el Share of Model, de modo que cada acción recibe un veredicto en lugar de una esperanza. El seguimiento de visibilidad en IA agrega los resultados a nivel de prompt en la tendencia que un stakeholder realmente lee.
Las citas se potencian con el SEO tradicional
El mecanismo de recuperar y luego generar hace esto concreto en lugar de motivacional: los motores recuperan de los índices de búsqueda, así que el trabajo que mejora los rankings alimenta la capa de la que salen las citas. La indexación te hace recuperable en Bing para la búsqueda de ChatGPT y en Google para Gemini. Los backlinks y la autoridad influyen en qué candidatos recuperados se consideran fiables en el momento de la generación, y las páginas de terceros que te enlazan son con frecuencia las mismas que los motores citan para los prompts de recomendación. La investigación de palabras clave y el mapeo de prompts son la misma disciplina apuntada a dos interfaces. Ejecútalas como un único programa con un único backlog, y cada activo rinde el doble: un ranking en la página de resultados y una cita en la respuesta que hay encima. AEO frente al SEO tradicional mapea dónde divergen las dos disciplinas, qué es AEO cubre los fundamentos, y la lista de verificación de AEO convierte este playbook en una lista de tareas para la primera semana.