Ce qu’est le SEO sémantique et pourquoi les moteurs sont passés des chaînes aux choses
Le SEO sémantique est la pratique consistant à optimiser les pages autour des entités (les personnes, produits, concepts et organisations réels dont parle une requête) et des relations entre elles, au lieu de chaînes de mots-clés exactes. L’unité d’optimisation passe de « cette page contient-elle l’expression » à « cette page couvre-t-elle clairement et complètement la chose », car c’est la question à laquelle les systèmes de récupération modernes répondent réellement.
Trois mécanismes ont provoqué le changement, et chacun modifie une décision concrète que vous prenez en planifiant une page :
- Résolution d’entité. Les moteurs associent les formes de surface à un seul nœud : « GA4 », « Google Analytics 4 » et « le nouveau Google Analytics » se résolvent tous en une entité. Conséquence : publier des pages distinctes pour des variantes de nom ne capture plus une demande distincte ; cela crée des quasi-doublons se disputant une seule place.
- Graphes de connaissances. Les moteurs stockent les entités avec des relations typées (un produit est fabriqué par une entreprise, une technique est un type de discipline). Conséquence : les pages qui énoncent explicitement les relations, en prose et en données structurées, sont plus faciles à placer dans le graphe que les pages qui les sous-entendent.
- Embeddings et similarité vectorielle. Le texte est encodé en vecteurs où un sens similaire atterrit près d’un sens similaire, et la récupération fonctionne par recherche du plus proche voisin sur les passages, pas par chevauchement exact de mots. Conséquence : un passage peut se positionner pour une formulation qu’il n’utilise jamais, et un passage bourré de l’expression cible peut perdre face à un plus clair. C’est le même substrat de récupération qui alimente les moteurs de réponse, c’est pourquoi la seconde moitié de ce guide relie le SEO sémantique aux citations en IA.
Pour un traitement plus approfondi de la mécanique de récupération elle-même, voyez NLP et recherche sémantique en SEO. Ce guide reste du côté exécutable : quoi construire, comment le structurer, et comment l’auditer.
Entités vs mots-clés : un contraste travaillé
Le moyen le plus rapide d’intérioriser la différence est de planifier le même sujet des deux façons.
Exemple illustratif. Une équipe vend un logiciel de planification et trouve quatre requêtes dans sa recherche de mots-clés : « logiciel de prise de rendez-vous », « logiciel de réservation de rendez-vous », « outil de planification en ligne » et « application de planification pour petites entreprises ».
- Plan de l’ère des mots-clés : quatre pages d’atterrissage, une par expression, chacune insérant le terme principal dans le H1 et le title, chacune mince parce que la substance a été répartie en quatre. Le moteur résout les quatre requêtes en la même entité et intention, choisit au plus une page, et traite le reste comme une couverture dupliquée.
- Plan de l’ère sémantique : une page entité-complète sur le logiciel de prise de rendez-vous en tant que catégorie (ce que c’est, à qui il s’adresse, comment fonctionnent les flux de réservation, les schémas d’intégration et de tarification, et comment choisir) plus une courte section reconnaissant la variante petites entreprises car cette audience a une contrainte réellement différente (la sensibilité au prix). Une page, quatre requêtes, aucune concurrence interne.
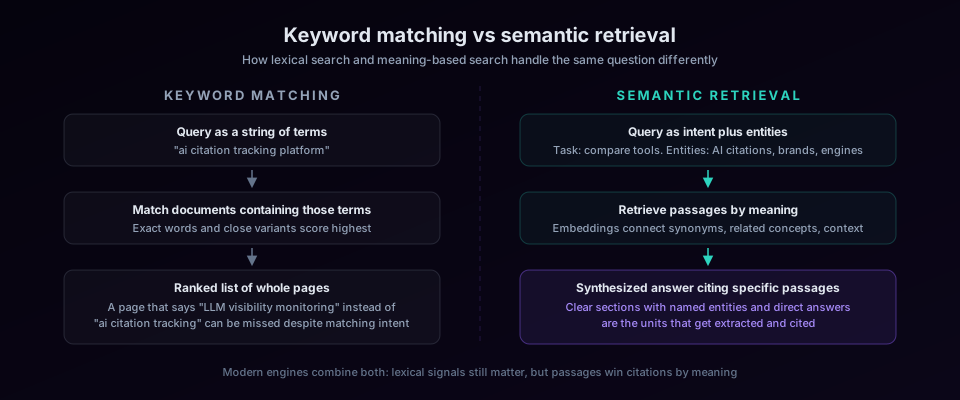
Les habitudes se transfèrent directement :
| Habitude de l’ère des mots-clés | Remplacement de l’ère sémantique |
|---|---|
| Une page par variante de mot-clé | Une page entité-complète par intention distincte |
| Répéter le terme principal exact partout | Un nom canonique, entouré d’entités associées coapparaissant |
| Ancre comme « cliquez ici » ou « en savoir plus » | Ancres qui nomment l’entité cible et la relation |
| Juger la couverture par la densité de mots-clés | Juger la couverture selon que chaque sous-question de l’intention est répondue |
| Créer des pages satellites pour les synonymes et les villes | Consolider les quasi-doublons ; rediriger les perdants |
| Traiter le balisage comme une décoration optionnelle | Énoncer about, mentions et sameAs pour que l’identité soit lisible par les machines |
Une entité, de nombreuses intentions
Les entités et les intentions sont des axes différents, et les confondre est l’erreur de planification la plus courante dans un sens comme dans l’autre. Une entité engendre plusieurs intentions, et chaque intention distincte est une page candidate.
Prenez l’entité « balisage schema ». Un lecteur peut arriver en voulant :
- La définir - « qu’est-ce que le balisage schema » (intention définitionnelle).
- L’implémenter - « comment ajouter du JSON-LD à une page produit » (intention instructionnelle).
- Comparer les options - « JSON-LD vs microdata » (intention comparative).
- Que ce soit fait pour lui - un générateur de balisage schema (intention transactionnelle).
- Le corriger - « erreurs du test des résultats enrichis » (intention de dépannage).
Même entité, cinq tâches différentes dans la tête du lecteur, et une page construite pour une tâche sert mal les autres : une page de définition qui bascule soudain dans des étapes d’implémentation ne satisfait pleinement aucun lecteur et embrouille la récupération de passages sur la finalité de la page. Cartographiez les intentions avant de cartographier les pages, et écrivez l’ouverture de chaque page pour déclarer quelle tâche elle sert.
Grappes thématiques : architecture et règles de décision
Une grappe thématique est l’expression au niveau du site du SEO sémantique : une page pilier qui définit l’entité centrale et répond directement à la question large, entourée de pages de grappe qui possèdent chacune une sous-intention, connectées par des liens internes qui énoncent les relations.
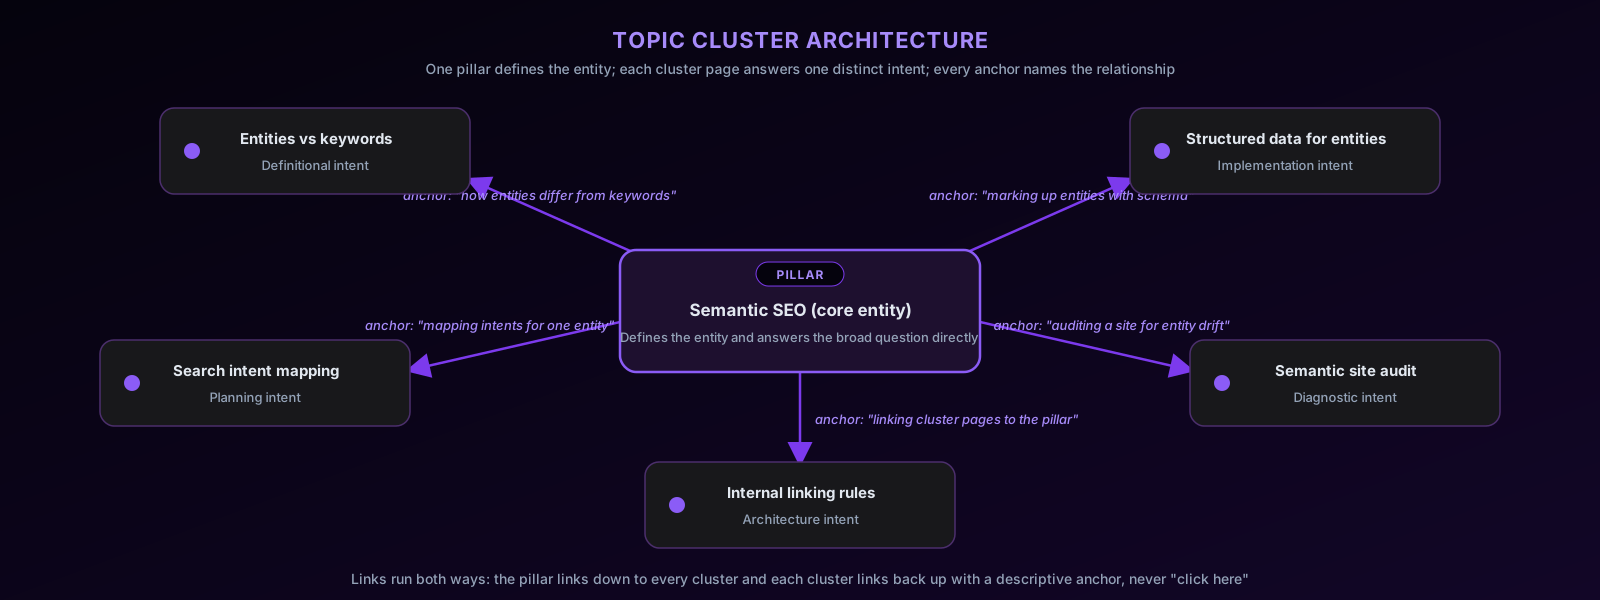
La règle de décision page-vs-section. Une sous-question gagne sa propre page uniquement quand les deux tests passent :
- Intention distincte - le lecteur qui la pose accomplit une tâche différente de celui sur le pilier (implémenter plutôt que définir, comparer plutôt qu’apprendre).
- Assez de profondeur - vous pouvez écrire un traitement autonome complet, pas deux paragraphes gonflés pour en avoir l’air.
Si l’un des tests échoue, la sous-question devient une section sur le pilier avec son propre titre, pour qu’elle puisse quand même être récupérée comme un passage et liée directement. Promouvoir une réponse de deux paragraphes vers sa propre URL crée une page mince ; enterrer une intention réellement distincte dans le pilier crée une section qui ne concurrence rien et ne gagne rien.
Règles d’ancrage des liens internes. Les ancres sont la façon dont vous dites à un moteur quelle relation une arête encode, alors nommez la relation, pas l’action :
- Écrivez « comment la résolution d’entité regroupe les variantes de nom », pas « en savoir plus ici ».
- Liez chaque page de grappe vers le pilier avec une ancre nommant l’entité centrale, et liez le pilier vers chaque grappe : une page de grappe sans lien entrant depuis son pilier est orpheline de son propre sujet.
- Liez les grappes sœurs uniquement quand une relation réelle existe entre leurs sujets ; les liens croisés décoratifs diluent ceux qui portent du sens.
C’est la même architecture qui bâtit l’autorité thématique dans les positions Google (les recommandations de contenu utile de Google récompensent une profondeur démontrable sur un sujet) et c’est simultanément ce qui rend un site récupérable dans les réponses d’IA, ce qui est le cœur de la comparaison AEO face au SEO traditionnel : même travail, deux gains.
Clarté d’entité on-page
L’architecture de site pose le cadre ; chaque page doit tout de même rendre son entité indubitable. Cinq règles couvrent l’essentiel :
- Définissez l’entité dans le premier paragraphe avec le schéma sujet, catégorie, différenciateur : « X est un [catégorie] qui [ce qui le distingue]. » C’est le passage que les moteurs citent pour les requêtes définitionnelles, et la documentation sur les featured snippets de Google montre la même logique d’extraction à l’œuvre dans la recherche classique.
- Un nom canonique par concept. Choisissez un nom pour votre produit, votre catégorie et chaque terme clé, et utilisez-le à chaque fois. Alterner entre trois noms pour une variation élégante se lit bien pour les humains et fragmente le signal d’entité pour les machines ; si un synonyme importe aux lecteurs, énoncez l’équivalence une fois (« aussi vendu sous le nom de X ») plutôt que d’alterner.
- Entités associées coapparaissant. Une page réellement sur un sujet nomme naturellement ses voisins : les outils, standards, personnes et concepts adjacents qui coapparaissent avec lui dans un texte faisant autorité. Leur présence aide un modèle à placer votre page dans le bon voisinage sémantique ; leur absence est un signal de minceur qu’aucune densité de mots-clés ne peut compenser.
- Désambiguïsez tout ce qui peut entrer en collision. Si votre marque, nom de produit ou terme clé partage un nom avec autre chose, dites lequel vous entendez dans le texte (« Mercury, le client de messagerie, pas la planète ») et dans le balisage.
- Énoncez-le dans les données structurées. Utilisez
aboutpour l’entité principale de la page,mentionspour les secondaires, etsameAspour pointer vers des profils externes faisant autorité qui fixent l’identité de votre entité. L’introduction aux données structurées de Google couvre les formats pris en charge ; la règle pratique est que le balisage devrait affirmer exactement ce que le texte visible dit déjà, jamais plus.
Comment auditer un site existant de façon sémantique
La plupart des équipes ne partent pas de zéro ; elles sont assises sur des années de pages écrites sous les règles de l’ère des mots-clés. L’audit est un exercice de cartographie : pour chaque URL indexée, dérivez la paire (entité principale, intention) de son contenu actuel, puis cherchez quatre modes d’échec.
- Dérive d’entité. Une page lancée sur une chose, et cinq ans de modifications ont ajouté des sections sur des choses adjacentes jusqu’à ce qu’aucune entité unique ne domine. Symptôme : vous ne pouvez pas énoncer le sujet de la page en une phrase sans « et aussi ». Correctif : scindez les sections dérivées en les pages de grappe qu’elles voulaient être, ou coupez-les, et restaurez une entité dominante.
- Quasi-doublons qui se cannibalisent. Deux pages ou plus se résolvent en la même paire entité-intention, généralement d’anciennes pages de variantes de mots-clés. Symptôme : elles échangent des impressions pour les mêmes requêtes et aucune ne bâtit d’autorité. Correctif : fusionnez la substance dans l’URL la plus forte et redirigez le reste.
- Pages de grappe orphelines. Une page couvre bien un sous-sujet mais ne reçoit aucun lien de son pilier, donc rien ne dit au moteur à quel sujet elle appartient. Correctif : ajoutez le lien pilier-vers-grappe avec une ancre nommant la relation, dans les deux sens.
- Pages définitionnelles manquantes. Votre site utilise un terme sur quarante pages et le définit sur aucune, donc les moteurs sourcent la définition, et la citation, chez quelqu’un d’autre. Correctif : publiez la page définitionnelle et faites-en la cible de lien interne canonique pour le terme.
Travaillez l’audit en commençant par les pages génératrices de revenus plutôt qu’alphabétiquement, et relancez-le selon une cadence : la dérive et la duplication sont des sous-produits de la publication normale, pas des péchés ponctuels. Le cadre d’optimisation de contenu couvre le processus de réécriture au niveau de la page une fois que l’audit vous a dit quelles pages corriger, et la liste de vérification du SEO technique couvre la couche d’explorabilité qui doit être saine avant que le moindre travail sémantique ne soit visible pour les moteurs.
Pourquoi le SEO sémantique est le substrat de l’AEO
Tout ce qui précède valait la peine quand le gain n’était que les positions. Cela compte davantage maintenant parce que les moteurs de réponse par IA sont bâtis directement sur la machinerie sémantique.
Quand ChatGPT, Claude, Gemini ou Perplexity répond à une question avec des sources, le pipeline est récupérer-puis-générer : les passages candidats sont extraits par similarité d’embeddings, puis le modèle compose une réponse et cite les passages sur lesquels il s’est appuyé. Cela a deux conséquences directes. Premièrement, la récupération opère au niveau des passages, donc une section claire sur l’entité avec une définition précoce et des entités associées nommées peut être récupérée même depuis une page qui ne se positionnerait jamais comme document entier. Deuxièmement, la génération favorise le texte citable : une définition nette de deux à trois phrases est réutilisée presque mot pour mot, tandis qu’une définition qui tourne en rond est paraphrasée sans attribution ou écartée. Voilà pourquoi l’optimisation pour les moteurs de réponse n’est pas une discipline distincte greffée sur le SEO : c’est du SEO sémantique mesuré à une surface différente. Qu’est-ce que l’AEO et l’optimisation pour les moteurs génératifs couvrent la surface elle-même ; le travail on-page est ce que vous venez de lire.
La mesure change aussi. Les positions ne peuvent pas vous dire si un moteur de réponse a utilisé votre page, donc le tableau de bord de l’ère sémantique est les citations en IA (quels moteurs citent lesquelles de vos pages, pour quels prompts) et le Share of Model, le pourcentage de réponses de catégorie qui vous mentionnent par rapport à chaque concurrent. Si votre grappe est sémantiquement solide, ces chiffres bougent ; s’ils ne bougent pas, la section d’audit ci-dessus est le premier endroit où regarder. Pour le programme plus large autour de ces métriques, voyez AI SEO et la ressource stratégie de citations en IA.
Où se situe AEO Goal : trouver l’écart et livrer le correctif
Vous pouvez exécuter tout ce qui est dans ce guide avec un robot d’exploration et une feuille de calcul. Ce qui est difficile à faire manuellement, c’est la vérification : l’entité cible est-elle réellement saillante sur la page que vous avez optimisée, et les moteurs citent-ils réellement la grappe que vous avez construite ?
AEO Goal, notre logiciel d’AI SEO, instrumente les deux bouts de cette boucle. Son analyseur de prominence d’entités lit une page comme un modèle le fait et indique si votre entité cible est réellement dominante ou perdue parmi des sujets concurrents, une vérification mécanique de la dérive d’entité décrite ci-dessus, page par page. Côté résultat, le suivi des citations en IA exécute vos prompts prioritaires contre ChatGPT, Claude, Gemini et Perplexity selon un calendrier et indique quelles pages chaque moteur cite, avec le Share of Model face aux concurrents nommés (la méthode exacte est documentée dans la méthodologie de suivi des citations, et comment les citations sont comptées se trouve dans le centre d’aide).
La différence avec les outils de suivi seul, c’est ce qui se passe ensuite : chaque écart est livré avec un correctif. Une page de grappe jamais citée devient un brief de contenu answer-first ; une page à faible prominence d’entité reçoit une cible de réécriture concrète ; un about ou sameAs manquant devient un changement de schema ; un robot d’IA bloqué devient un correctif d’accès. Le scan suivant revérifie si le correctif a déplacé le chiffre, pour que le travail sémantique reste une boucle mesurée plutôt qu’un nettoyage ponctuel.
Où aller ensuite
- Exécutez la liste de vérification AEO pour transformer ce guide en une liste de tâches séquencée.
- Utilisez le keyword research tool pour rassembler l’ensemble de requêtes, puis regroupez-le par entité et intention comme décrit ci-dessus (comment fonctionne la recherche de mots-clés dans AEO Goal).
- Définissez les prompts que vous voulez gagner dans les réponses d’IA et suivez-les (fonctionnalité prompts) ; la visibilité dans les LLM explique ce que cette surface inclut.
Le SEO sémantique n’est pas une tendance superposée au SEO ; c’est à quoi ressemble l’optimisation une fois que les moteurs résolvent les chaînes en choses. Construisez une page claire par entité et intention, connectez-les avec des ancres qui signifient quelque chose, et les deux tableaux de bord, les positions et les citations, se lisent à partir du même travail.