Le cadre en une ligne : réponse, entités, preuves
Le cadre d’optimisation de contenu comporte trois couches, appliquées dans l’ordre à chaque page : commencer chaque section par une réponse directe de 40 à 60 mots, nommer chaque entité explicitement et de façon cohérente, et attribuer chaque affirmation vérifiable à une source avec un auteur et une date. Les pages qui franchissent les trois couches sont celles que les moteurs de réponse récupèrent, extraient et citent ; les pages qui échouent à une seule couche ont tendance à être écartées quelle que soit la force des deux autres, car les couches sont des barrières séquentielles plutôt qu’un tableau de notes dont on ferait la moyenne.
Cette logique de barrière constitue tout le cadre. La structure décide si un passage peut être extrait de la page tout court. Les entités décident si le moteur sait de qui parle le passage extrait. Les preuves décident si le moteur fait suffisamment confiance au passage pour le répéter avec votre nom attaché. Si la mécanique de la récupération générative est nouvelle pour vous, commencez par l’explication sur l’optimisation pour les moteurs génératifs et la définition de l’optimisation pour les moteurs de réponse, puis revenez appliquer les couches ci-dessous.
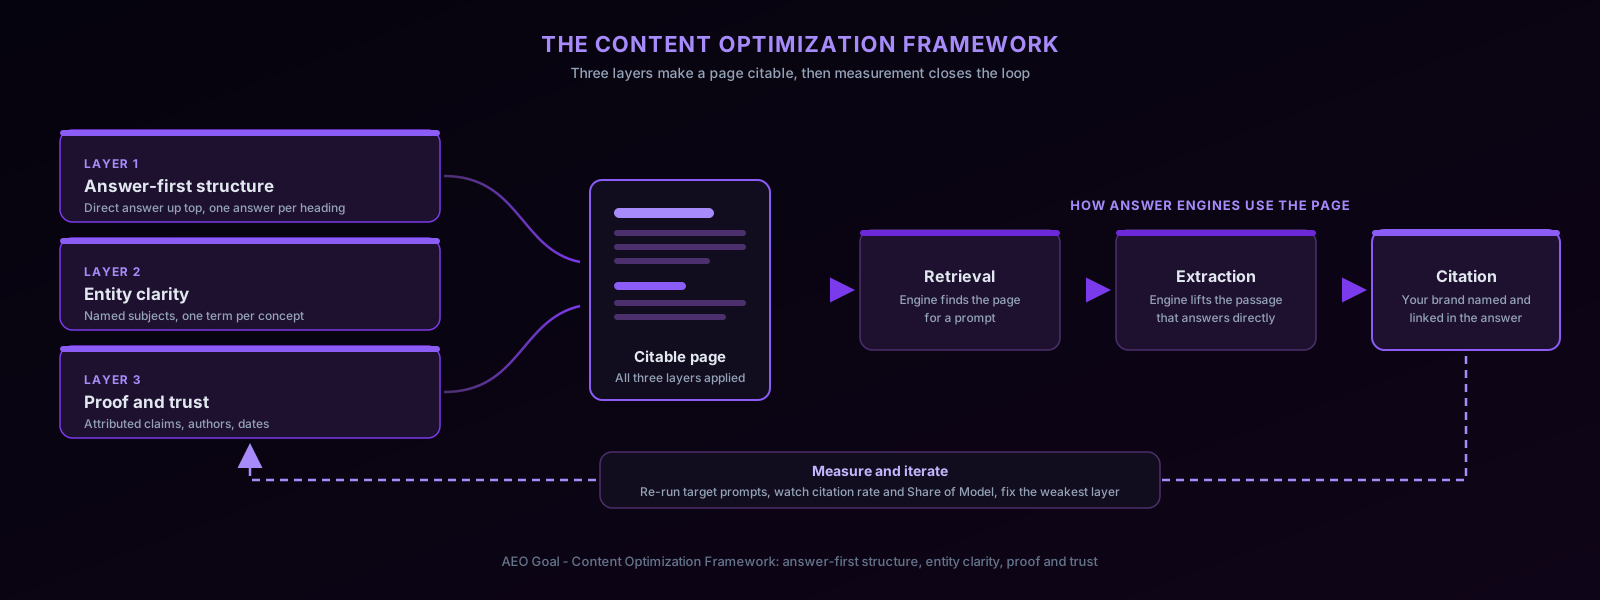
Couche 1 : structure answer-first
Placez la conclusion avant l’explication dans chaque section. Les moteurs de réponse extraient le passage qui résout le plus directement un prompt et écartent l’introduction autour, donc les premières phrases sous chaque titre doivent tenir seules comme une réponse complète même citées avec zéro contexte environnant.
L’unité de base est la réponse directe de 40 à 60 mots en haut de la page et sous chaque titre principal. Un passage dans cette plage est assez long pour être une affirmation complète et assez court pour survivre entier à l’extraction. Règle de décision : une réponse directe valable contient quatre choses. Premièrement, le sujet nommé, jamais un pronom. Deuxièmement, le verdict, la définition ou la recommandation eux-mêmes. Troisièmement, l’unique qualificatif qui en délimite la portée, comme à qui elle s’applique ou sous quelle condition elle tient. Quatrièmement, aucune référence en avant : « comme nous l’expliquons ci-dessous » tue l’extraction car le passage cité devient incomplet à lui seul.
Exemple illustratif, avant : « Il y a de nombreux facteurs à peser lors du choix d’un outil de monitoring, et le bon choix dépend de la situation unique de votre équipe. Dans ce guide, nous passerons en revue tout ce que vous devez savoir. » Après : « Choisissez un outil de monitoring qui vérifie chaque moteur que vos acheteurs utilisent réellement ; une équipe qui vend aux développeurs devrait vérifier la couverture de ChatGPT et de Claude avant de comparer les tableaux de bord, car un outil qui rate un moteur rate les citations qui s’y produisent. » La première version ne répond à rien ; la seconde peut être citée mot pour mot comme la réponse.
Modes d’échec courants pour cette couche :
- La réponse enterrée. Trois paragraphes de contexte de marché avant que la page ne dise quoi que ce soit d’engageant. Les moteurs extraient la page du concurrent qui a répondu dès la première phrase.
- La réponse cachée en accordéon. La vraie réponse se trouve dans une bascule ou un onglet de FAQ replié, rendu par JavaScript au clic. Si le texte n’est pas dans le HTML servi, de nombreux robots ne le voient jamais. Gardez les réponses dans le document visible et utilisez le balisage FAQ, en suivant la spécification FAQPage de schema.org, comme un ajout plutôt qu’un substitut.
- Des titres en question sans réponses. Un H2 qui demande « Comment fonctionne X ? » suivi d’un paragraphe sur pourquoi X importe. Le titre promet un passage que la section ne livre jamais, ce qui gaspille le signal d’extraction le plus fort d’une page.
Règles de mise en forme pratiques : formulez les titres comme les questions que les acheteurs posent réellement, gardez les paragraphes de deux à quatre phrases pour que les passages tiennent dans les limites de réponse, et donnez à chaque H2 son propre verdict d’une phrase avant toute élaboration. Le content optimizer vérifie un brouillon par rapport à ces règles, et les modèles de contenu SEO intègrent la forme dès le départ.
Couche 2 : clarté d’entité
Nommez les personnes, produits, organisations et concepts explicitement et de façon cohérente pour qu’un moteur puisse déterminer de qui et de quoi parle chaque passage sans lire le reste de la page. L’extraction sort les passages de leur contexte ; un passage qui dit « la plateforme prend en charge cela » n’identifie personne et ne cite donc personne.
L’arbitrage de cette couche, c’est la répétition. Règle de décision : répétez le nom complet de l’entité au début de chaque section, dans chaque définition, et dans toute phrase susceptible d’être citée seule, car ce sont les endroits où un passage se retrouve séparé de son contexte. Au sein d’un même paragraphe, une fois le sujet établi dans la première phrase, les pronoms conviennent et la répétition du nom complet devient robotique. Le test est l’extraction, pas le style : si cette phrase précise était extraite seule, un lecteur saurait-il de qui elle parle ? Si oui, un pronom est sûr. Si non, répétez le nom.
La seconde discipline est un terme par concept. Choisissez un nom canonique pour chaque produit, fonctionnalité et idée, et utilisez-le partout. Une page qui alterne entre « optimisation pour les moteurs de réponse », « optimisation de la recherche par IA » et « LLM SEO » pour la même idée scinde une entité en trois entités faibles. La même règle s’applique à vos propres métriques : ce site dit Share of Model, défini dans l’entrée de glossaire Share of Model, et jamais un synonyme.
Exemple illustratif, avant : « Notre solution s’intègre aux outils que votre équipe utilise déjà. Elle prend aussi en charge des flux de travail personnalisés, et l’approche évolue à mesure que vous grandissez. » Après : « Acme Monitor s’intègre à Slack et Jira, prend en charge les flux d’alerte personnalisés et évolue jusqu’à 500 prompts suivis par espace de travail. » Chaque nom de la réécriture est identifiable ; rien dans l’original ne l’est.
Le mode d’échec à traquer est la dérive d’entité : une page qui commence sur le « suivi des citations en IA », glisse vers le « monitoring de marque » à mi-parcours, et finit sur la « gestion de réputation ». Chaque section est cohérente seule, mais la page dans son ensemble raconte au moteur trois histoires différentes sur son sujet, et la récupération punit l’ambiguïté. Corrigez la dérive en écrivant le sujet unique de la page en haut du brouillon et en coupant toute section qui n’en parle pas. Renforcez techniquement la couche d’entité avec des données structurées qui déclarent le sujet de la page en JSON-LD ; l’introduction aux données structurées de Google couvre la mécanique, et le générateur de balisage schema produit le balisage. Pour vérifier avec quelle force une page signale son entité cible, passez-la par l’analyse de prominence des entités.
Couche 3 : preuves et confiance
Étayez chaque affirmation qu’un moteur pourrait contester avec une preuve qu’un lecteur peut vérifier : une source nommée, une date, un auteur ou un chiffre précis. Les systèmes génératifs sont entraînés à préférer un contenu responsable, et les recommandations de contenu utile de Google pointent dans la même direction, donc une assertion non étayée n’est pas un remplissage neutre ; c’est une raison de citer quelqu’un d’autre.
Règle de décision pour ce qui nécessite une attribution : tout nombre, tout comparatif (« plus rapide que », « le plus précis »), toute affirmation sensible au temps (« au 2026 ») et toute affirmation sur l’argent, la sécurité ou la santé. Les énoncés de sens commun et le comportement documenté de votre propre produit n’ont pas besoin de citations externes, mais les affirmations produit doivent tout de même correspondre à ce que la page produit et la documentation disent réellement, car les moteurs recoupent les sources les unes avec les autres.
Le mode d’échec déterminant de cette couche est une preuve qui n’est que des adjectifs. « Précision leader du secteur », « approuvé par des milliers » et « IA de pointe » n’affirment rien de vérifiable, et un système d’extraction n’a aucune raison de les répéter. Exemple illustratif, avant : « Notre plateforme est la solution la plus fiable du marché, offrant des résultats inégalés aux entreprises de toutes tailles. » Après : « Acme Monitor revérifie chaque prompt suivi selon un calendrier de scan fixe et enregistre chaque réponse, de sorte qu’une équipe peut montrer quelles réponses précises ont changé après la livraison d’un correctif de contenu. » La réécriture est citable parce qu’elle est falsifiable.
Deux règles de plus qui coûtent peu et se cumulent : affichez un auteur nommé et une date de dernière mise à jour visible sur chaque page substantielle, et étiquetez chaque cas hypothétique « Exemple illustratif » pour qu’il ne puisse jamais être pris pour une donnée. Fabriquer une statistique pour paraître crédible est le moyen le plus rapide d’échouer à cette couche définitivement, car une affirmation qu’un moteur ne peut corroborer nulle part ailleurs sape la page qui la porte.
Diagnostiquer par symptôme : couche, symptôme, correctif
Utilisez ce tableau lorsqu’une page sous-performe et que vous devez identifier quelle couche a échoué avant de réécrire quoi que ce soit.
| Couche | Symptôme sur la page | Correctif |
|---|---|---|
| 1 : Structure | La réponse arrive après des paragraphes de contexte | Déplacez un verdict de 40 à 60 mots en haut de la page et de chaque H2 |
| 1 : Structure | Réponses cachées dans des accordéons ou onglets JS | Mettez le texte de réponse dans le HTML servi ; gardez le balisage FAQPage en complément |
| 1 : Structure | Titres en question, aucune réponse directe en dessous | Écrivez une réponse d’une phrase comme première ligne de chaque section |
| 2 : Entités | Passages remplis de « il », « la plateforme », « cette approche » | Répétez le nom complet en début de section et dans les phrases citables |
| 2 : Entités | Plusieurs noms pour un concept à travers la page | Standardisez sur un terme canonique et appliquez-le partout |
| 2 : Entités | Le sujet dérive entre les sections | Énoncez un seul sujet en haut ; coupez les sections qui n’en parlent pas |
| 3 : Preuves | Affirmations posées à plat sans source ni date | Attribuez les nombres, comparatifs et affirmations sensibles au temps |
| 3 : Preuves | Des « preuves » qui sont des adjectifs, pas des faits | Remplacez les superlatifs par des énoncés précis et falsifiables |
| 3 : Preuves | Aucun auteur ni date de dernière mise à jour visible | Ajoutez les deux à chaque gabarit de page substantielle |
Exécutez-le comme un audit sur toute votre bibliothèque
Le cadre passe d’une page à toute une bibliothèque en devenant une passe de notation. Triez d’abord : ordonnez les pages par trafic actuel et par potentiel de citation, c’est-à-dire les pages qui visent des prompts où les concurrents sont cités et pas vous. Une page à fort trafic qui gagne déjà des citations est une priorité moindre qu’une page à trafic moyen assise sur un prompt que vous perdez complètement, car la seconde a de la marge.
Notez chaque page triée de 0 à 2 par couche. Zéro signifie que la couche est absente (aucune réponse directe nulle part, ou de la soupe de pronoms, ou zéro affirmation attribuée). Un signifie partiellement appliquée. Deux signifie qu’elle passerait les règles de décision ci-dessus. La note est délibérément grossière ; son rôle est de classer les correctifs, pas de noter les rédacteurs.
Ensuite, corrigez d’abord la couche la plus faible, une couche par page par passe. La raison est la logique de barrière du haut de cette page : les couches sont séquentielles, donc l’effort dépensé sur une couche plus forte est gaspillé tant qu’une plus faible échoue. Peaufiner les preuves d’une page dont les réponses sont enterrées améliore un passage qu’aucun moteur n’extraira jamais. Une page notée 2-1-0 reçoit du travail sur les preuves ; une page notée 0-2-2 reçoit une réécriture structurelle et rien d’autre jusqu’à la prochaine passe de notation. Renotez après chaque passe plutôt que d’essayer de corriger les trois couches en une seule édition héroïque, et intégrez l’audit dans votre liste de vérification AEO plus large pour que les éléments techniques comme l’accès des robots soient vérifiés dans le même cycle ; la liste de vérification du SEO technique couvre ce versant.
Un cadre, deux surfaces
Le cadre n’est pas une discipline réservée à l’IA, et c’est l’argument pratique pour l’adopter : la même réécriture sert les positions classiques et les citations en IA à la fois. Les featured snippets de Google extraient un passage autonome qui résout directement la requête, comme le décrit sa documentation sur les featured snippets, et le passage ranking note les sections d’une page indépendamment, ce qui récompense exactement la forme answer-first au niveau des sections de la couche 1. La cohérence d’entité de la couche 2 est le cœur opérationnel du SEO sémantique, et les signaux de responsabilité de la couche 3 sont ce qu’évalue l’E-E-A-T.
Une équipe n’a donc pas à choisir entre optimiser pour Google et optimiser pour les moteurs de réponse. Le travail structurel est partagé ; ce qui diffère, c’est la mesure et une part de plomberie technique, qui est le vrai sujet d’AEO face au SEO traditionnel. Si vous vous demandez encore si les réponses d’IA méritent un effort dédié, qu’est-ce que l’AEO présente l’argumentaire à partir des principes premiers.
Où se situe AEO Goal : de l’écart au correctif livré
Le cadre vous dit comment écrire une page citable. Il ne vous dit pas quelles pages corriger, et le découvrir à la main signifie exécuter des dizaines de prompts sur quatre moteurs et lire chaque réponse. AEO Goal automatise cette boucle. Son suivi des citations en IA exécute vos prompts cibles contre ChatGPT, Claude, Gemini et Perplexity selon un calendrier et fait ressortir les prompts précis où un concurrent est cité et où vous êtes absent, ce qui est précisément l’entrée de triage dont le flux de travail d’audit ci-dessus a besoin ; la méthodologie documente comment chaque citation en IA est détectée et notée, sans réponses simulées.
À partir de là, il diagnostique quelle couche a échoué : structure de réponse faible, signaux d’entité minces sur la page, preuves manquantes, ou un bloqueur technique comme un robot d’IA interdit qu’aucune réécriture ne peut corriger. Chaque écart est livré avec une action concrète plutôt qu’un graphique, et pour les écarts de contenu, la génération de contenu AEO transforme le prompt perdant en un brief answer-first avec la réponse directe, les entités et les preuves requises spécifiées dès le départ, de sorte qu’un rédacteur exécute le cadre au lieu de le redécouvrir. Au scan suivant, AEO Goal revérifie les mêmes prompts et montre si le correctif a déplacé les citations. Le guide ci-dessus fonctionne avec n’importe quelle chaîne d’outils ; le produit supprime le travail de relevé manuel entre ses étapes.
Mesurez-le : chaque page est une hypothèse
Une page structurellement correcte peut tout de même échouer à gagner des citations, et seule la mesure vous dit quelles pages y sont parvenues. Traitez chaque réécriture comme une hypothèse avec une base de référence enregistrée : les prompts cibles, les moteurs vérifiés et l’état de citation avant le changement.
La boucle opérationnelle a quatre étapes. Définissez les prompts que chaque page vise et gérez-les comme une liste de premier plan ; le guide de la fonctionnalité prompts montre comment AEO Goal gère cela. Relancez ces prompts par moteur une fois que la réécriture a eu le temps d’être réexplorée, car les moteurs rafraîchissent leurs sources selon leurs propres calendriers et les vérifications le jour même mesurent surtout du bruit. Observez deux chiffres : le taux de citations sur les prompts cibles, suivi via les citations, et le Share of Model face aux concurrents nommés, qui capte le cas où vous avez gagné des citations tandis qu’un concurrent en a gagné plus vite. Décidez ensuite : si les citations ont bougé, capitalisez le schéma et appliquez-le à la page suivante dans l’ordre de triage ; si rien n’a bougé après plusieurs cycles de scan, la page perd sur la récupération ou la confiance plutôt que sur l’extraction, alors escaladez vers le travail de liens et d’autorité en suivant la stratégie de citations en IA.
Gardez les résultats honnêtes en observant par moteur plutôt qu’en agrégé, car une page peut gagner sur Perplexity tout en restant invisible sur ChatGPT, et faire la moyenne des deux masque les deux faits. Le guide de recherche de mots-clés couvre la moitié recherche classique de la même discipline de mesure. Le cadre comporte trois couches, mais l’habitude qui se cumule est cette boucle : notez, corrigez la couche la plus faible, relancez les prompts, et laissez les données de citations choisir votre page suivante.