El marco en una línea: respuesta, entidades, prueba
El marco de optimización de contenidos tiene tres capas, que se aplican por orden a cada página: encabeza cada sección con una respuesta directa de 40 a 60 palabras, nombra cada entidad de forma explícita y coherente, y atribuye cada afirmación verificable a una fuente con autor y fecha. Las páginas que superan las tres capas son las que los motores de respuesta recuperan, extraen y citan; las que fallan en cualquiera de las capas tienden a quedarse fuera por muy sólidas que sean las otras dos, porque las capas son puertas secuenciales y no una tabla de puntuación cuyos valores puedas promediar.
Esa lógica de puertas es todo el marco. La estructura decide si un pasaje puede extraerse de la página siquiera. Las entidades deciden si el motor sabe de quién trata el pasaje extraído. La prueba decide si el motor confía lo suficiente en el pasaje como para repetirlo con tu nombre atribuido. Si la mecánica de la recuperación generativa te resulta nueva, empieza por la explicación sobre optimización para motores generativos y la definición de optimización para motores de respuesta, y luego vuelve y aplica las capas que verás a continuación.
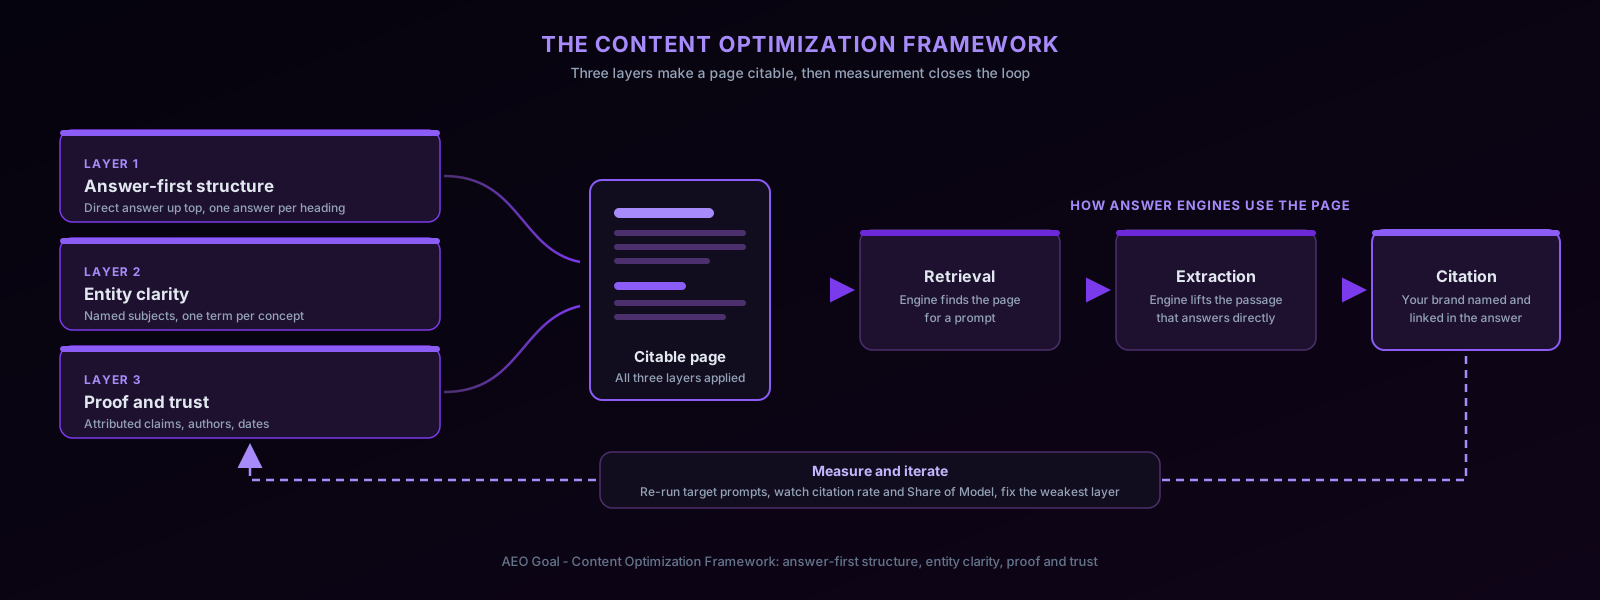
Capa 1: estructura orientada a la respuesta
Pon la conclusión antes de la explicación en cada sección. Los motores de respuesta extraen el pasaje que resuelve un prompt de forma más directa y descartan la introducción que lo rodea, así que las primeras frases bajo cada encabezado deben sostenerse por sí solas como una respuesta completa incluso cuando se citen sin ningún contexto alrededor.
La unidad básica es la respuesta directa de 40 a 60 palabras al principio de la página y bajo cada encabezado importante. Un pasaje dentro de ese rango es lo bastante largo para ser una afirmación completa y lo bastante corto para sobrevivir entero a la extracción. Regla de decisión: una respuesta directa válida contiene cuatro cosas. Primera, el sujeto nombrado, nunca un pronombre. Segunda, el veredicto, la definición o la recomendación en sí. Tercera, el único matiz que la acota, como a quién se aplica o bajo qué condición se cumple. Cuarta, ninguna referencia hacia delante: “como explicamos más abajo” arruina la extracción porque el pasaje citado queda incompleto por sí solo.
Ejemplo ilustrativo, antes: “Hay muchos factores que sopesar al elegir una herramienta de monitorización, y la decisión correcta depende de la situación particular de tu equipo. En esta guía repasaremos todo lo que necesitas saber.” Después: “Elige una herramienta de monitorización que verifique todos los motores que tus compradores usan de verdad; un equipo que vende a desarrolladores debería comprobar la cobertura de ChatGPT y Claude antes de comparar paneles, porque una herramienta que se salta un motor se salta las citas que ocurren allí.” La primera versión no responde nada; la segunda puede citarse literalmente como respuesta.
Modos de fallo habituales de esta capa:
- La respuesta enterrada. Tres párrafos de contexto de mercado antes de que la página diga algo con compromiso. Los motores extraen la página de la competencia que respondió en la primera frase.
- La respuesta escondida en un acordeón. La respuesta de verdad vive dentro de un desplegable de FAQ contraído o de una pestaña que se renderiza con JavaScript al hacer clic. Si el texto no está en el HTML servido, muchos rastreadores nunca lo ven. Mantén las respuestas en el documento visible y usa el marcado de FAQ, según la especificación FAQPage de schema.org, como complemento y no como sustituto.
- Encabezados en forma de pregunta sin respuestas. Un H2 que pregunta “¿Cómo funciona X?” seguido de un párrafo sobre por qué X importa. El encabezado promete un pasaje que la sección nunca entrega, lo que desperdicia la señal de extracción más fuerte que tiene una página.
Reglas prácticas de formato: redacta los encabezados como las preguntas que los compradores hacen de verdad, mantén los párrafos entre dos y cuatro frases para que los pasajes encajen en los límites de la respuesta, y da a cada H2 su propio veredicto de una frase antes de cualquier desarrollo. El optimizador de contenidos comprueba un borrador frente a estas reglas, y las plantillas de contenido SEO integran la forma desde el principio.
Capa 2: claridad de entidades
Nombra a las personas, los productos, las organizaciones y los conceptos de forma explícita y coherente para que un motor pueda resolver de quién y de qué trata cada pasaje sin leer el resto de la página. La extracción saca los pasajes fuera de su contexto; un pasaje que dice “la plataforma admite esto” no identifica a nadie y, por tanto, no cita a nadie.
La decisión clave de esta capa es la repetición. Regla de decisión: repite el nombre completo de la entidad al principio de cada sección, en cada definición y en cualquier frase que probablemente se cite por sí sola, porque esos son los sitios donde un pasaje se separa de su contexto. Dentro de un mismo párrafo, una vez establecido el sujeto en la primera frase, los pronombres están bien y repetir el nombre completo resulta robótico. La prueba es la extracción, no el estilo: si esta frase exacta se extrajera por sí sola, ¿sabría un lector de quién trata? Si la respuesta es sí, un pronombre es seguro. Si es no, repite el nombre.
La segunda disciplina es un término por concepto. Elige un nombre canónico para cada producto, función e idea, y úsalo en todas partes. Una página que alterna entre “optimización para motores de respuesta”, “optimización para búsqueda con IA” y “SEO para LLM” para la misma idea divide una entidad en tres débiles. La misma regla se aplica a tus propias métricas: este sitio dice Share of Model, definido en la entrada del glosario de Share of Model, y nunca un sinónimo.
Ejemplo ilustrativo, antes: “Nuestra solución se integra con las herramientas que tu equipo ya usa. También admite flujos de trabajo personalizados, y el enfoque escala a medida que creces.” Después: “Acme Monitor se integra con Slack y Jira, admite flujos de alerta personalizados y escala hasta 500 prompts monitorizados por espacio de trabajo.” Cada sustantivo de la reescritura es resoluble; nada en el original lo es.
El modo de fallo que hay que cazar es la deriva de entidades: una página que empieza hablando de “seguimiento de citas de IA”, pasa a “monitorización de marca” hacia la mitad y termina sobre “gestión de reputación”. Cada sección es coherente por sí sola, pero la página en su conjunto cuenta al motor tres historias distintas sobre su tema, y la recuperación castiga la ambigüedad. Corrige la deriva escribiendo el único sujeto de la página al principio del borrador y eliminando cualquier sección que no trate sobre él. Refuerza técnicamente la capa de entidades con datos estructurados que declaren el sujeto de la página en JSON-LD; la introducción a los datos estructurados de Google explica la mecánica, y el generador de marcado schema produce el marcado. Para comprobar con qué fuerza una página señala su entidad objetivo, pásala por saliencia de entidades.
Capa 3: prueba y confianza
Respalda cada afirmación que un motor pueda cuestionar con pruebas que un lector pueda verificar: una fuente nombrada, una fecha, un autor o una cifra concreta. Los sistemas generativos están entrenados para preferir el contenido que rinde cuentas, y la guía de contenido útil de Google apunta en la misma dirección, así que una afirmación sin respaldo no es relleno neutral; es un motivo para citar a otro.
Regla de decisión sobre qué necesita atribución: cualquier número, cualquier comparativo (“más rápido que”, “el más preciso”), cualquier afirmación sensible al tiempo (“a fecha de 2026”) y cualquier afirmación sobre dinero, seguridad o salud. Las afirmaciones de conocimiento común y el comportamiento documentado de tu propio producto no necesitan citas externas, pero las afirmaciones sobre el producto aún deben coincidir con lo que la página del producto y la documentación dicen de verdad, porque los motores contrastan unas fuentes con otras.
El modo de fallo que define esta capa es la prueba que no es más que adjetivos. “Precisión líder del sector”, “con la confianza de miles” y “IA de vanguardia” no afirman nada comprobable, y un sistema de extracción no tiene ningún motivo para repetirlos. Ejemplo ilustrativo, antes: “Nuestra plataforma es la solución más fiable del mercado, y ofrece resultados inigualables para empresas de todos los tamaños.” Después: “Acme Monitor vuelve a comprobar cada prompt monitorizado en un calendario de escaneo fijo y registra cada respuesta, de modo que un equipo puede mostrar qué respuestas concretas cambiaron después de publicar una corrección de contenido.” La reescritura es citable porque es refutable.
Dos reglas más que cuestan poco y se acumulan: muestra un autor nombrado y una fecha de última actualización visible en cada página de peso, y etiqueta cada supuesto como “Ejemplo ilustrativo” para que nunca pueda confundirse con datos. Fabricar una estadística para parecer autoritativo es la forma más rápida de fallar esta capa para siempre, porque una afirmación que un motor no puede corroborar en ningún otro sitio socava la página que la contiene.
Diagnostica por síntoma: capa, síntoma, corrección
Usa esta tabla cuando una página rinda por debajo de lo esperado y necesites identificar qué capa falló antes de reescribir nada.
| Capa | Síntoma en la página | Corrección |
|---|---|---|
| 1: Estructura | La respuesta llega tras párrafos de contexto | Mueve un veredicto de 40 a 60 palabras al principio de la página y de cada H2 |
| 1: Estructura | Respuestas ocultas en acordeones o pestañas JS | Pon el texto de la respuesta en el HTML servido; conserva el marcado FAQPage como complemento |
| 1: Estructura | Encabezados en forma de pregunta, sin respuestas directas debajo | Escribe una respuesta de una frase como primera línea de cada sección |
| 2: Entidades | Pasajes llenos de “esto”, “la plataforma”, “este enfoque” | Repite el nombre completo al inicio de las secciones y en las frases citables |
| 2: Entidades | Varios nombres para un mismo concepto a lo largo de la página | Estandariza en un término canónico y aplícalo en todas partes |
| 2: Entidades | El tema deriva entre secciones | Enuncia un solo sujeto al principio; elimina las secciones que no traten sobre él |
| 3: Prueba | Afirmaciones sueltas sin fuente ni fecha | Atribuye números, comparativos y afirmaciones sensibles al tiempo |
| 3: Prueba | “Prueba” que son adjetivos, no hechos | Sustituye los superlativos por afirmaciones concretas y refutables |
| 3: Prueba | No hay autor ni fecha de última actualización visible | Añade ambos a cada plantilla de página de peso |
Ejecútalo como una auditoría en toda tu biblioteca
El marco escala de una página a una biblioteca entera al convertirse en una pasada de puntuación. Prioriza primero: ordena las páginas por tráfico actual y por oportunidad de cita, es decir, páginas que buscan prompts en los que la competencia aparece citada y tú no. Una página de mucho tráfico que ya gana citas es de menor prioridad que una de tráfico medio situada sobre un prompt que estás perdiendo por completo, porque la segunda tiene margen de mejora.
Puntúa cada página priorizada de 0 a 2 por capa. Cero significa que la capa está ausente (ninguna respuesta directa en ningún sitio, o una sopa de pronombres, o cero afirmaciones atribuidas). Uno significa parcialmente aplicada. Dos significa que superaría las reglas de decisión anteriores. La puntuación es deliberadamente tosca; su función es ordenar las correcciones, no calificar a los redactores.
Después corrige primero la capa más débil, una capa por página y por pasada. La razón es la lógica de puertas del principio de esta página: las capas son secuenciales, así que el esfuerzo dedicado a una capa más fuerte se desperdicia mientras una más débil está fallando. Pulir la prueba en una página cuyas respuestas están enterradas mejora un pasaje que ningún motor extraerá jamás. Una página que puntúa 2-1-0 recibe trabajo de prueba; una página que puntúa 0-2-2 recibe una reescritura estructural y nada más hasta la siguiente pasada de puntuación. Vuelve a puntuar tras cada pasada en lugar de intentar corregir las tres capas en una sola edición heroica, e integra la auditoría en tu lista de comprobación AEO más amplia para que los aspectos técnicos, como el acceso de los rastreadores, se revisen en el mismo ciclo; la lista de comprobación de SEO técnico cubre esa parte.
Un marco, dos superficies
El marco no es una disciplina exclusiva de la IA, y ese es el argumento práctico para adoptarlo: la misma reescritura sirve al posicionamiento clásico y a las citas de IA a la vez. Los fragmentos destacados de Google extraen un pasaje autónomo que resuelve la consulta de forma directa, tal como describe su documentación sobre fragmentos destacados, y el passage ranking puntúa las secciones de una página de forma independiente, lo que premia exactamente la forma orientada a la respuesta a nivel de sección de la Capa 1. La coherencia de entidades de la Capa 2 es el núcleo operativo del SEO semántico, y las señales de rendición de cuentas de la Capa 3 son lo que evalúa el E-E-A-T.
Así que un equipo no necesita elegir entre optimizar para Google y optimizar para los motores de respuesta. El trabajo estructural es compartido; lo que difiere es la medición y algo de fontanería técnica, que es el verdadero tema de AEO frente al SEO tradicional. Si todavía estás valorando si las respuestas de IA merecen algún esfuerzo dedicado, qué es el AEO lo argumenta desde los primeros principios.
Dónde encaja AEO Goal: de la brecha a la corrección publicada
El marco te dice cómo escribir una página citable. No te dice qué páginas corregir, y averiguarlo a mano significa lanzar decenas de prompts en cuatro motores y leer cada respuesta. AEO Goal automatiza ese bucle. Su seguimiento de citas de IA lanza tus prompts objetivo contra ChatGPT, Claude, Gemini y Perplexity de forma programada y saca a la luz los prompts exactos en los que un competidor aparece citado y tú estás ausente, que es precisamente la entrada de priorización que necesita el flujo de auditoría anterior; la metodología documenta cómo se detecta y puntúa cada cita de IA, sin respuestas simuladas.
A partir de ahí diagnostica qué capa falló: estructura de respuesta débil, señales de entidad pobres en la página, prueba ausente o un bloqueo técnico como un rastreador de IA no permitido que ninguna reescritura puede arreglar. Cada brecha llega con una acción concreta en lugar de un gráfico, y para las brechas de contenido, la generación de contenido AEO convierte el prompt perdido en un brief orientado a la respuesta con la respuesta directa, las entidades y la prueba requerida especificadas de antemano, de modo que un redactor ejecuta el marco en lugar de redescubrirlo. En el siguiente escaneo, AEO Goal vuelve a comprobar los mismos prompts y muestra si la corrección movió las citas. La guía anterior funciona con cualquier conjunto de herramientas; el producto elimina el trabajo manual de sondeo entre sus pasos.
Mídelo: cada página es una hipótesis
Una página estructuralmente correcta puede aun así no ganar citas, y solo la medición te dice qué páginas lo lograron. Trata cada reescritura como una hipótesis con una referencia registrada: los prompts objetivo, los motores comprobados y el estado de citas antes del cambio.
El bucle de trabajo tiene cuatro pasos. Define los prompts que busca cada página y gestiónalos como una lista de primer orden; la guía de la función de prompts muestra cómo lo maneja AEO Goal. Vuelve a lanzar esos prompts por motor después de que la reescritura haya tenido tiempo de volver a rastrearse, ya que los motores refrescan sus fuentes según sus propios calendarios y las comprobaciones del mismo día miden sobre todo ruido. Observa dos números: la tasa de citas en los prompts objetivo, seguida a través de citas, y el Share of Model frente a competidores nombrados, que detecta el caso en el que ganaste citas mientras un competidor las ganó más rápido. Luego decide: si las citas se movieron, guarda el patrón y aplícalo a la siguiente página en el orden de prioridad; si nada se movió tras varios ciclos de escaneo, la página pierde en recuperación o en confianza en lugar de en extracción, así que escala a trabajo de enlaces y autoridad siguiendo la estrategia de citas de IA.
Mantén los resultados honestos observando por motor en lugar de en conjunto, porque una página puede ganar en Perplexity mientras permanece invisible en ChatGPT, y promediar ambos oculta las dos realidades. La guía de investigación de palabras clave cubre la mitad de búsqueda clásica de esa misma disciplina de medición. El marco son tres capas, pero el hábito que se acumula es este bucle: puntúa, corrige la capa más débil, vuelve a lanzar los prompts y deja que los datos de citas elijan tu siguiente página.