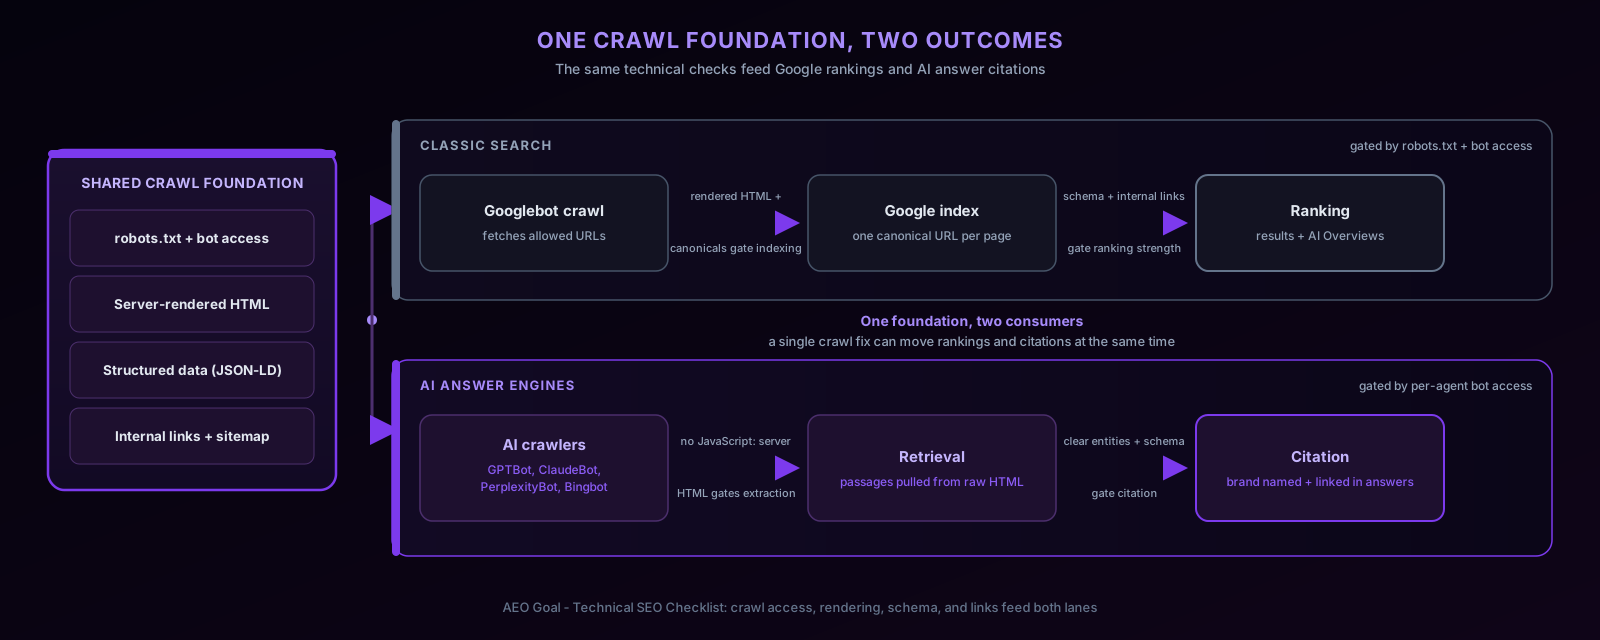
Travaillez cette liste de vérification dans l’ordre des dépendances : l’accès d’exploration d’abord, puis le rendu, puis les contrôles d’indexation, les données structurées, l’architecture, la performance, et enfin la vérification. Chaque étape conditionne la suivante : un bloc de schema parfait sur une page qui renvoie un 403 à ClaudeBot est un travail gaspillé. La raison pour laquelle l’ordre compte plus aujourd’hui qu’il y a cinq ans est que la même fondation d’exploration nourrit deux consommateurs : l’index de Google, qui produit les positions, et les récupérations des robots d’IA, qui produisent la récupération que les moteurs de réponse citent. Un seul correctif de robots.txt ou de rendu fait régulièrement bouger les deux chiffres à la fois.
Étape 1 : accès d’exploration - qui peut récupérer vos pages, et l’avez-vous décidé ?
Tout commence par une récupération. Auditez l’accès par user agent, pas globalement, car votre robots.txt s’adresse désormais à au moins deux populations distinctes aux conséquences différentes.
D’abord, connaissez les robots et ce que chacun alimente :
| User agent | Opérateur | Ce qu’il alimente | Le bloquer signifie |
|---|---|---|---|
| Googlebot | Index de recherche, positions, AI Overviews | Disparu de Google Search | |
| Google-Extended | Entraînement et grounding de Gemini | Aucun usage Gemini ; recherche non affectée | |
| Bingbot | Microsoft | Index Bing, Copilot, sources de recherche ChatGPT | Invisible pour Copilot et une grande part de la recherche ChatGPT |
| GPTBot | OpenAI | Corpus d’entraînement du modèle | Exclu du futur entraînement OpenAI |
| OAI-SearchBot | OpenAI | Récupération de la recherche ChatGPT | Non récupérable dans la recherche ChatGPT |
| ClaudeBot | Anthropic | Entraînement et récupération de Claude | Exclu du corpus de Claude |
| PerplexityBot | Perplexity | Index de recherche de Perplexity | Non citable dans les réponses Perplexity |
La distinction Googlebot versus Google-Extended est le modèle de chaque décision ici : Google a délibérément séparé « indexe-moi pour la recherche » de « utilise-moi pour Gemini » pour que les sites puissent s’inscrire à l’un sans l’autre. Lisez la documentation robots.txt de Google et sa liste complète de robots une fois, puis écrivez un Allow ou Disallow explicite par agent au lieu de vous fier à la règle joker. OpenAI documente ses agents et leurs plages d’IP publiées sur platform.openai.com/docs/bots ; notez que GPTBot (entraînement) et OAI-SearchBot (récupération de la recherche ChatGPT) sont des décisions distinctes, exactement comme la paire de Google.
Puis auditez la couche que robots.txt ne peut pas voir : votre WAF, CDN et règles de gestion de bots. Celles-ci arrivent fréquemment avec des réglages par défaut qui défient ou renvoient un 403 à tout ce qui a un user agent en forme de bot. Testez chaque page critique avec curl en utilisant la chaîne de user agent de chaque robot et confirmez un 200 avec le HTML complet dans le corps. Un 403, une page de défi JavaScript ou un CAPTCHA intercalaire se lisent tous comme « aucun contenu ici » pour un robot.
La règle de décision : un blocage est une politique légitime quand vous pouvez nommer le user agent, nommer le compromis et pointer la ligne de robots.txt qui l’implémente. Un blocage est un accident quand il vit dans un réglage par défaut d’infrastructure que personne n’a configuré. La version la plus coûteuse de l’accident est le blocage de Bingbot : vos positions Google ne bougent pas, donc aucun tableau de bord n’alerte, mais Copilot et la recherche ChatGPT perdent discrètement la capacité de vous récupérer. Des sites ont porté ce blocage pendant des mois parce que rien de ce qu’ils surveillaient ne le mesurait. Utilisez un générateur de robots.txt pour écrire délibérément les règles par agent, et envisagez de publier un fichier llms.txt pour orienter les systèmes d’IA vers votre contenu canonique.
Étape 2 : rendu - la réponse est-elle dans le HTML que vous servez réellement ?
Google exécute le JavaScript, mais dans une seconde vague de rendu différée ; sa propre documentation SEO JavaScript décrit le pipeline explorer-rendre-indexer et ses délais. La plupart des robots d’IA sautent entièrement ce pipeline : ils récupèrent la réponse HTTP brute et analysent ce qui s’y trouve. Aucune hydratation, aucun routage côté client, aucune section chargée en différé. Si votre page est une div vide plus un bundle JavaScript, un robot d’IA voit une div vide.
Testez-le en deux minutes : récupérez la page avec curl et cherchez dans la réponse votre phrase de réponse clé. Séparément, chargez la page dans un navigateur avec le JavaScript désactivé. Si la réponse n’apparaît dans aucun, elle n’existe pas pour la récupération par IA, et elle n’atteint Google que via la file de rendu plus lente.
La règle de décision pour le prérendu : si votre framework prend déjà en charge le rendu côté serveur ou la génération statique, activez-le pour les routes de contenu : cela corrige les deux consommateurs à la fois. Ne recourez à un service de prérendu séparé que lorsque l’application ne peut réellement pas rendre côté serveur, car une couche de prérendu est un cache de plus à invalider et un endroit de plus où le contenu peut se périmer. Les surfaces d’application interactives (tableaux de bord, configurateurs) peuvent rester rendues côté client ; les pages que vous voulez faire citer ne le peuvent pas.
Deux pièges adjacents : le contenu qui existe dans le HTML mais uniquement à l’intérieur d’onglets ou d’accordéons repliés pilotés par JavaScript peut être extrait de façon incohérente, alors gardez la réponse principale dans le flux visible par défaut. Et le contenu qui n’existe qu’à l’intérieur d’images est un texte qu’un analyseur ne voit jamais : les graphiques ont besoin de légendes, les captures d’écran ont besoin d’une prose environnante.
Étape 3 : contrôles d’indexation - une URL par réponse
Les robots qui peuvent récupérer et lire vos pages ont encore besoin de savoir quelle URL est la page. Des signaux dupliqués et contradictoires divisent votre autorité entre les variantes et gaspillent le budget d’exploration sur des URL que vous n’avez jamais voulu indexer.
- Définissez exactement un canonical auto-référentiel par URL indexable, et rendez les canonicals absolus. Un canonical pointant vers une URL redirigée ou en noindex est une contradiction que les moteurs résolvent de façon imprévisible.
- Cherchez dans vos gabarits les directives noindex égarées : une balise meta de préproduction partie en production est un tueur silencieux classique, et elle vous retire de Google et de chaque index d’IA qui la respecte.
- Réduisez les chaînes de redirection à un seul saut. Chaque saut supplémentaire est de la latence, et certains robots abandonnent les longues chaînes.
- Choisissez une forme de barre oblique finale, un protocole, un hôte (www ou nu), et redirigez en 301 les autres variantes. Chaque variante non résolue est une URL dupliquée qui se concurrence elle-même.
- Gardez le sitemap XML honnête : uniquement des URL à statut 200, canoniques et indexables. Un sitemap plein de redirections dit aux robots que votre carte du site n’est pas fiable, et ils la dépriorisent en conséquence. Régénérez-le au déploiement, pas à la main.
Étape 4 : données structurées - des affirmations qu’une machine peut vérifier
Les données structurées sont la façon dont vous énoncez, dans un contrat lisible par les machines, ce qu’est une page. Google documente les types et règles pris en charge dans son introduction aux données structurées ; le même JSON-LD est une preuve analysable pour tout système d’IA qui décide si votre page répond à une question.
Associez les types aux schémas de page plutôt que de tout décorer : Article pour les pages éditoriales, Product avec des offres pour les pages produit, HowTo pour les instructions étape par étape, FAQPage pour du contenu question-réponse authentique, Organization et WebSite une fois, sur tout le site, pour ancrer l’identité d’entité. Générez un JSON-LD correct avec un générateur de balisage schema au lieu de l’écrire à la main.
Deux règles d’airain. Premièrement, validez : un JSON-LD mal formé n’est pas partiellement crédité, il est ignoré, donc une accolade manquante supprime silencieusement votre balisage. Deuxièmement, le balisage doit correspondre au contenu visible. Un schema FAQ décrivant des questions qui ne s’affichent qu’après un clic, ou qui ne s’affichent jamais, est le motif le plus susceptible d’être traité comme du spam, et il échoue de toute façon au test de rendu de l’étape 2. Si la réponse vaut la peine d’être balisée, elle vaut la peine d’être montrée.
Étape 5 : architecture - les liens internes sont votre graphe de pertinence
Les moteurs infèrent en partie de quoi parle une page à partir de la façon dont votre propre site pointe vers elle. Trois vérifications :
- Pages orphelines. Explorez votre site et comparez l’ensemble d’URL découvertes à votre sitemap. Les pages du sitemap qu’aucun lien interne n’atteint sont explorées à contrecœur et classées faiblement ; soit liez-les depuis un hub pertinent, soit demandez pourquoi elles existent.
- Texte d’ancrage. Les ancres descriptives (« liste de vérification du SEO technique pour les robots d’IA ») transfèrent du sens ; « cliquez ici » et « en savoir plus » ne transfèrent rien. Auditez d’abord les ancres pointant vers vos pages les plus importantes.
- Grappes thématiques. Regroupez les pages associées sous un hub et maillez les sœurs, pour que les robots classiques comme les systèmes de récupération voient un corps de preuves cohérent sur le sujet plutôt que des isolats dispersés. Le guide du SEO sémantique explique comment structurer les grappes autour des entités plutôt que des chaînes de mots-clés.
Cette étape est là où le SEO classique et l’AEO convergent le plus visiblement : une grappe bien maillée augmente la confiance de Google dans la page hub et donne simultanément à la récupération par IA davantage de passages connectés et corroborants dans lesquels puiser.
Étape 6 : performance - la version honnête
Les Core Web Vitals (LCP, INP, CLS) mesurent le chargement, l’interactivité et la stabilité visuelle pour les utilisateurs réels. Corrigez-les parce qu’ils sont un signal d’expérience de page Google et parce que les pages lentes perdent des utilisateurs. Ne les corrigez pas en espérant que les citations en IA bougent : aucun moteur de réponse n’a publié de critères de citation liés au décalage de mise en page ou à la latence d’entrée.
Ce qui se reporte sur les robots d’IA, c’est le comportement brut du serveur. Une origine lente, une limitation de débit agressive ou un serveur instable font échouer les récupérations pour Googlebot et GPTBot pareillement, et un robot qui tombe en time-out n’enregistre rien. Donc l’élément de la liste est en deux parties : rendez le time-to-first-byte et les taux d’erreur serveur sains pour chaque user agent (cela conditionne tous les robots), puis parcourez les constats des Core Web Vitals pour les gains côté utilisateur et côté Google. Gardez les deux motivations séparées dans votre reporting pour que personne ne promette des gains de citations à partir d’un correctif de CLS.
Étape 7 : vérification - prouvez-le dans les outils, puis dans les réponses
Refermez la boucle avec les systèmes qui observent votre site de l’extérieur :
- Google Search Console. Confirmez que le nombre de pages indexées correspond aux attentes, inspectez les URL clés pour le statut de canonical et de rendu, et surveillez les erreurs de couverture. Connectez-la via l’intégration Search Console pour garder les données à côté du reste de votre audit.
- Bing Webmaster Tools. Chroniquement sauté, et précisément une erreur à sauter maintenant : l’index de Bing est ce dont Copilot et la recherche ChatGPT s’inspirent, alors vérifiez aussi le statut d’exploration et d’indexation là-bas via l’intégration Bing Webmaster.
- Mesure des citations en IA. Search Console ne peut pas vous dire si ChatGPT vous cite. Suivez vos prompts prioritaires à travers ChatGPT, Claude, Gemini et Perplexity avant et après chaque correctif technique, pour qu’un Bingbot débloqué ou une page nouvellement rendue côté serveur apparaisse comme un changement de citation mesuré, pas une intuition. La méthodologie de suivi des citations en IA explique exactement ce qui est mesuré et comment, ce qui compte avant d’attribuer un gain à un correctif.
Comment AEO Goal exécute cette liste de vérification pour vous
La plupart des échecs ci-dessus partagent une propriété : rien de ce que vous surveillez normalement n’alerte à leur sujet. Le scan gratuit d’AEO Goal exécute le haut de cette liste de vérification côté serveur contre votre domaine en direct : robots.txt évalué par user agent à travers les robots d’IA du tableau ci-dessus, présence de llms.txt, validité du JSON-LD, santé du sitemap, métadonnées et prominence des entités, sans inscription. L’explorateur de site et l’audit technique étendent cela à tout votre ensemble d’URL.
La différence avec un auditeur qui ne fait que rapporter, c’est ce qui se passe ensuite. AEO Goal est un agent AEO : chaque constat correspond à une remédiation concrète (les lignes de robots.txt à changer, le bloc de schema à ajouter, la page qui a besoin de sa réponse dans le HTML serveur) et le scan suivant revérifie si vous l’avez livrée et si elle a fonctionné. Côté mesure, le suivi des citations en IA enregistre comment ChatGPT, Claude, Gemini et Perplexity vous citent par prompt, et le suivi de la visibilité dans l’IA suit la tendance de votre taux de citations et de votre Share of Model face aux concurrents, de sorte qu’un correctif d’accès d’exploration fait cette semaine est visible comme un changement de citation lors des scans suivants. Le même espace de travail couvre le suivi de positions quotidien et les backlinks, ce qui est tout l’enjeu de cette page : c’est une seule fondation, donc ce devrait être un seul backlog.
Le pont : un correctif, deux résultats
L’ancien modèle mental traitait le SEO technique comme de la plomberie pour Google. La réalité actuelle, argumentée en détail dans AEO face au SEO traditionnel, est que la plomberie identique alimente les réponses d’IA : débloquer un robot, rendre une réponse côté serveur ou corriger un canonical change ce que Google comme les moteurs de réponse peuvent récupérer. Exécutez les étapes dans l’ordre, vérifiez à l’étape 7, et associez cette page à la liste de vérification AEO côté contenu : l’accès technique vous rend récupérable, et le contenu answer-first vous fait citer. Pour la discipline plus large, commencez par qu’est-ce que l’AEO.