Trabaja este checklist en orden de dependencia: primero el acceso de rastreo, luego el renderizado, después los controles de indexación, los datos estructurados, la arquitectura, el rendimiento y, por último, la verificación. Cada etapa condiciona la siguiente: un bloque de schema perfecto en una página que devuelve un 403 a ClaudeBot es trabajo desperdiciado. La razón por la que el orden importa más ahora que hace cinco años es que la misma base de rastreo alimenta a dos consumidores: el índice de Google, que produce rankings, y las peticiones de los rastreadores de IA, que producen la recuperación que citan los motores de respuesta. Una sola corrección de robots.txt o una sola corrección de renderizado mueve de forma habitual ambos números a la vez.
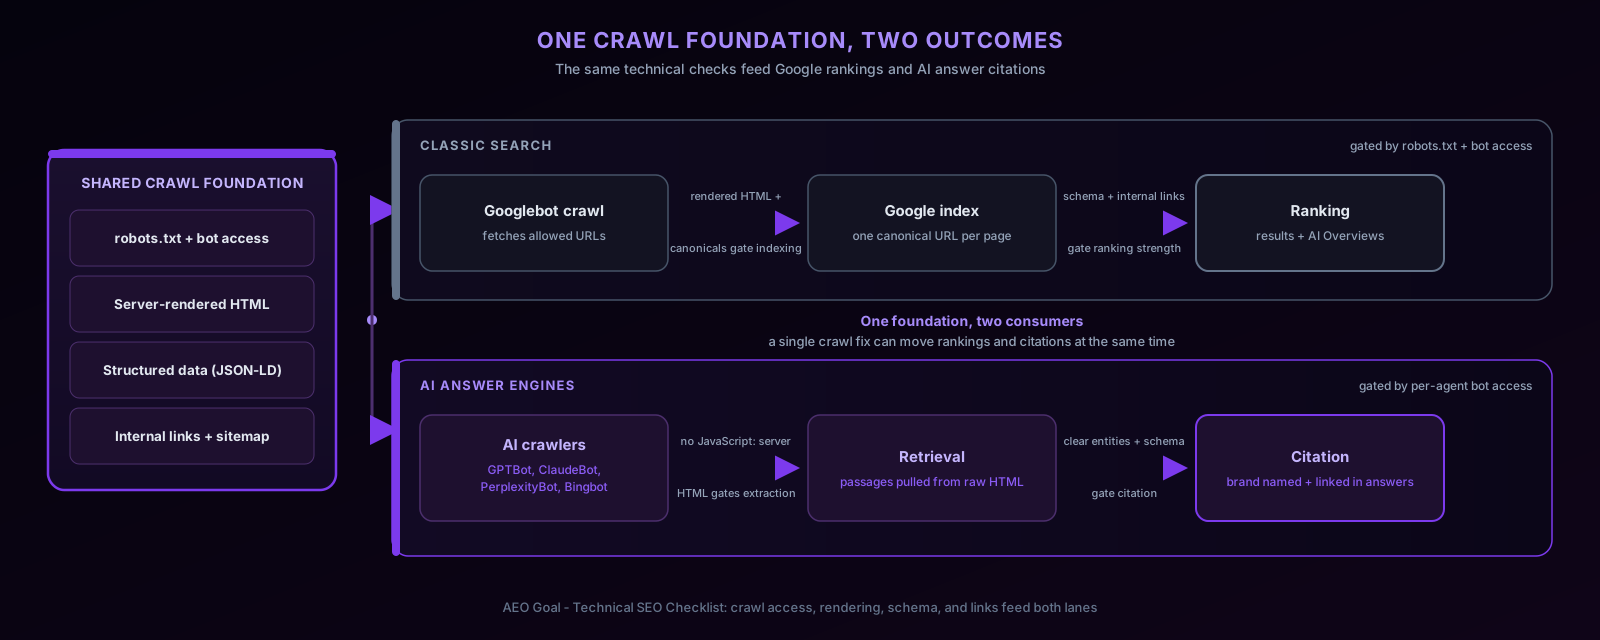
Etapa 1: Acceso de rastreo, ¿quién puede obtener tus páginas y lo decidiste tú?
Todo empieza con una petición. Audita el acceso por user agent, no de forma global, porque tu robots.txt ahora habla al menos a dos poblaciones distintas con consecuencias diferentes.
Primero, conoce los rastreadores y lo que alimenta cada uno:
| User agent | Operador | Qué alimenta | Qué significa bloquearlo |
|---|---|---|---|
| Googlebot | Índice de búsqueda, rankings, AI Overviews | Desaparecido de Google Search | |
| Google-Extended | Entrenamiento y grounding de Gemini | Sin uso en Gemini; Búsqueda no afectada | |
| Bingbot | Microsoft | Índice de Bing, Copilot, fuentes de la búsqueda de ChatGPT | Invisible para Copilot y para buena parte de la búsqueda de ChatGPT |
| GPTBot | OpenAI | Corpus de entrenamiento del modelo | Excluido del futuro entrenamiento de OpenAI |
| OAI-SearchBot | OpenAI | Recuperación de la búsqueda de ChatGPT | No recuperable en la búsqueda de ChatGPT |
| ClaudeBot | Anthropic | Entrenamiento y recuperación de Claude | Excluido del corpus de Claude |
| PerplexityBot | Perplexity | Índice de búsqueda de Perplexity | No citable en las respuestas de Perplexity |
La separación entre Googlebot y Google-Extended es el modelo para cada decisión aquí: Google separó deliberadamente “indexarme para Búsqueda” de “usarme para Gemini”, de modo que los sitios puedan suscribirse a uno sin el otro. Lee una vez la documentación de robots.txt de Google y su lista completa de rastreadores, y luego escribe un Allow o Disallow explícito por agente en lugar de depender de la regla comodín. OpenAI documenta sus agentes y sus rangos de IP publicados en platform.openai.com/docs/bots; ten en cuenta que GPTBot (entrenamiento) y OAI-SearchBot (recuperación de la búsqueda de ChatGPT) son decisiones separadas, exactamente igual que el par de Google.
Después, audita la capa que robots.txt no puede ver: tus reglas de WAF, CDN y gestión de bots. Con frecuencia vienen con ajustes por defecto que desafían o devuelven un 403 a cualquier cosa con un user agent con forma de bot. Prueba cada página crítica con curl usando la cadena de user agent de cada rastreador y confirma un 200 con el HTML completo en el cuerpo. Un 403, una página de desafío de JavaScript o un intersticial de CAPTCHA se leen todos como “aquí no hay contenido” para un rastreador.
La regla de decisión: un bloqueo es una política legítima cuando puedes nombrar el user agent, nombrar la contrapartida y señalar la línea de robots.txt que la implementa. Un bloqueo es un accidente cuando vive en un ajuste por defecto de infraestructura que nadie configuró. La versión más cara del accidente es bloquear Bingbot: tus rankings de Google no se mueven, así que ningún panel dispara alarmas, pero Copilot y la búsqueda de ChatGPT pierden en silencio la capacidad de recuperarte. Hay sitios que han arrastrado ese bloqueo durante meses porque nada de lo que monitorizaban lo medía. Usa un generador de robots.txt para escribir las reglas por agente de forma deliberada, y considera publicar un archivo llms.txt para apuntar a los sistemas de IA a tu contenido canónico.
Etapa 2: Renderizado, ¿está la respuesta en el HTML que realmente sirves?
Google ejecuta JavaScript, pero en una segunda oleada de renderizado diferida; su propia documentación de SEO para JavaScript describe el pipeline de rastreo-renderizado-indexación y sus retrasos. La mayoría de los rastreadores de IA se saltan ese pipeline por completo: obtienen la respuesta HTTP en bruto y analizan lo que hay en ella. Sin hidratación, sin enrutado en cliente, sin secciones cargadas de forma diferida. Si tu página es un div vacío más un bundle de JavaScript, un rastreador de IA ve un div vacío.
Pruébalo en dos minutos: obtén la página con curl y busca con grep en la respuesta la frase clave de tu respuesta. Por separado, carga la página en un navegador con JavaScript desactivado. Si la respuesta no aparece en ninguno de los dos, no existe para la recuperación de IA, y a Google solo le llega a través de la cola de renderizado más lenta.
La regla de decisión para el prerenderizado: si tu framework ya admite renderizado en servidor o generación estática, actívalo para las rutas de contenido, porque arregla ambos consumidores a la vez. Recurre a un servicio de prerenderizado independiente solo cuando la aplicación realmente no pueda renderizar en servidor, porque una capa de prerenderizado es una caché más que invalidar y un lugar más donde el contenido puede quedarse obsoleto. Las superficies de aplicación interactivas (paneles, configuradores) pueden seguir renderizándose en cliente; las páginas que quieres que se citen, no.
Dos trampas adyacentes: el contenido que existe en HTML pero solo dentro de pestañas o acordeones colapsados y controlados por JavaScript puede extraerse de forma inconsistente, así que mantén la respuesta principal en el flujo visible por defecto. Y el contenido que existe solo dentro de imágenes es texto que un analizador nunca ve: los gráficos necesitan pies de foto, las capturas necesitan prosa alrededor.
Etapa 3: Controles de indexación, una URL por respuesta
Los rastreadores que pueden obtener y leer tus páginas aún necesitan saber cuál es la URL de la página. Las señales duplicadas y contradictorias dividen tu autoridad entre variantes y desperdician el presupuesto de rastreo en URLs que nunca quisiste indexar.
- Establece exactamente un canónico autorreferencial por URL indexable, y haz que los canónicos sean absolutos. Un canónico que apunta a una URL que redirige o tiene noindex es una contradicción que los motores resuelven de forma impredecible.
- Rastrea con grep tus plantillas en busca de directivas noindex extraviadas: una metaetiqueta de staging que se envió a producción es un asesino silencioso clásico, y te elimina de Google y de cualquier índice de IA que la respete.
- Colapsa las cadenas de redirección a un solo salto. Cada salto extra es latencia, y algunos rastreadores abandonan las cadenas largas.
- Elige una única forma de barra final, un único protocolo, un único host (www o sin él) y redirige con 301 las otras variantes. Cada variante sin resolver es una URL duplicada compitiendo consigo misma.
- Mantén el sitemap XML veraz: solo URLs con estado 200, canónicas e indexables. Un sitemap lleno de redirecciones le dice a los rastreadores que no pueden fiarse de tu mapa del sitio, y lo despriorizan en consecuencia. Regenéralo en cada despliegue, no a mano.
Etapa 4: Datos estructurados, afirmaciones que una máquina puede verificar
Los datos estructurados son la forma de declarar, en un contrato legible por máquina, qué es una página. Google documenta los tipos y reglas admitidos en su introducción a los datos estructurados; el mismo JSON-LD es evidencia analizable para cualquier sistema de IA que decida si tu página responde a una pregunta.
Asocia los tipos a patrones de página en lugar de decorarlo todo: Article para páginas editoriales, Product con ofertas para páginas de producto, HowTo para instrucciones paso a paso, FAQPage para contenido genuino de preguntas y respuestas, Organization y WebSite una sola vez, en todo el sitio, para anclar la identidad de la entidad. Genera JSON-LD correcto con un generador de marcado schema en lugar de escribirlo a mano.
Dos reglas estrictas. Primera, valida: el JSON-LD mal formado no recibe crédito parcial, se ignora, así que una llave que falta borra tu marcado en silencio. Segunda, el marcado debe coincidir con el contenido visible. Un schema de FAQ que describe preguntas que solo se renderizan tras un clic, o que nunca se renderizan, es el patrón que más probabilidades tiene de tratarse como spam, y además falla la prueba de renderizado de la Etapa 2. Si la respuesta merece marcarse, merece mostrarse.
Etapa 5: Arquitectura, los enlaces internos son tu grafo de relevancia
Los motores infieren de qué trata una página en parte por cómo tu propio sitio apunta a ella. Tres comprobaciones:
- Páginas huérfanas. Rastrea tu sitio y compara el conjunto de URLs descubiertas con tu sitemap. Las páginas del sitemap a las que no llega ningún enlace interno se rastrean con reticencia y se posicionan con debilidad; o las enlazas desde un hub relevante o te preguntas por qué existen.
- Texto de anclaje. Los anclajes descriptivos (“checklist de SEO técnico para rastreadores de IA”) transfieren significado; “haz clic aquí” y “más información” no transfieren nada. Audita primero los anclajes que apuntan a tus páginas más importantes.
- Clústeres temáticos. Agrupa las páginas relacionadas bajo un hub y enlaza entre sí las hermanas, para que tanto los rastreadores clásicos como los sistemas de recuperación vean un cuerpo de evidencia coherente sobre el tema en lugar de piezas sueltas y dispersas. La guía de SEO semántico explica cómo estructurar los clústeres en torno a entidades y no a cadenas de palabras clave.
Esta etapa es donde el SEO clásico y la AEO convergen de forma más visible: un clúster bien enlazado eleva la confianza de Google en la página hub y, a la vez, da a la recuperación de IA más pasajes conectados y corroborantes de los que nutrirse.
Etapa 6: Rendimiento, la versión honesta
Los Core Web Vitals (LCP, INP, CLS) miden la carga, la interactividad y la estabilidad visual de los usuarios reales. Arréglalos porque son una señal de experiencia de página de Google y porque las páginas lentas pierden usuarios. No los arregles esperando que las citas de IA se muevan: ningún motor de respuesta ha publicado criterios de citación ligados al desplazamiento de diseño o a la latencia de entrada.
Lo que sí se traslada a los rastreadores de IA es el comportamiento bruto del servidor. Un origen lento, una limitación de tasa agresiva o un servidor inestable falla las peticiones tanto de Googlebot como de GPTBot, y un rastreador que agota el tiempo de espera no registra nada. Así que el ítem del checklist tiene dos partes: consigue que el tiempo hasta el primer byte y las tasas de error del servidor estén sanos para cada user agent (esto condiciona a todos los rastreadores), y luego trabaja los hallazgos de Core Web Vitals para las ganancias de cara al usuario y a Google. Mantén las dos motivaciones separadas en tus informes para que nadie prometa ganancias de citación a partir de una corrección de CLS.
Etapa 7: Verificación, demuéstralo en las herramientas y luego en las respuestas
Cierra el círculo con los sistemas que observan tu sitio desde fuera:
- Google Search Console. Confirma que los recuentos de páginas indexadas coinciden con lo esperado, inspecciona URLs clave para ver el estado de canónico y renderizado, y vigila los errores de cobertura. Conéctalo mediante la integración con Search Console para mantener los datos junto al resto de tu auditoría.
- Bing Webmaster Tools. Se salta de forma crónica, y saltárselo es precisamente un error ahora: el índice de Bing es de donde beben Copilot y la búsqueda de ChatGPT, así que verifica también ahí el estado de rastreo e indexación mediante la integración con Bing Webmaster.
- Medición de citas de IA. Search Console no puede decirte si ChatGPT te cita. Haz seguimiento de tus prompts prioritarios en ChatGPT, Claude, Gemini y Perplexity antes y después de cada corrección técnica, para que un Bingbot desbloqueado o una página recién renderizada en servidor aparezcan como un cambio de citación medido, no como una corazonada. La metodología de seguimiento de citas de IA explica exactamente qué se mide y cómo, lo cual importa antes de atribuir cualquier ganancia a una corrección.
Cómo AEO Goal ejecuta este checklist por ti
La mayoría de los fallos anteriores comparten una propiedad: nada de lo que normalmente monitorizas alerta sobre ellos. El escaneo gratuito de AEO Goal ejecuta la parte inicial de este checklist en el servidor contra tu dominio en vivo (robots.txt evaluado por user agent para los rastreadores de IA de la tabla anterior, presencia de llms.txt, validez de JSON-LD, salud del sitemap, metadatos y prominencia de entidad) sin registro. El rastreador del sitio y la auditoría técnica lo extienden a todo tu conjunto de URLs.
La diferencia con un auditor que solo informa es lo que ocurre después. AEO Goal es un agente de AEO: cada hallazgo se asocia a una remediación concreta (las líneas de robots.txt que cambiar, el bloque de schema que añadir, la página que necesita su respuesta en el HTML del servidor) y el siguiente escaneo vuelve a comprobar si lo desplegaste y si funcionó. En el lado de la medición, el seguimiento de citas de IA registra cómo te citan ChatGPT, Claude, Gemini y Perplexity por prompt, y el seguimiento de visibilidad en IA muestra la tendencia de tu tasa de citación y tu Share of Model frente a la competencia, de modo que una corrección de acceso de rastreo hecha esta semana es visible como un cambio de citación en los escaneos posteriores. El mismo espacio de trabajo cubre el seguimiento diario de rankings y los backlinks, que es la clave de toda esta página: es una sola base, así que debería ser un solo backlog.
El puente: una corrección, dos resultados
El viejo modelo mental trataba el SEO técnico como la fontanería para Google. La realidad actual, argumentada en detalle en AEO frente al SEO tradicional, es que la fontanería idéntica abastece a las respuestas de IA: desbloquear un rastreador, renderizar una respuesta en servidor o corregir un canónico cambia lo que tanto Google como los motores de respuesta pueden recuperar. Ejecuta las etapas en orden, verifica en la Etapa 7 y combina esta página con el checklist de AEO del lado del contenido: el acceso técnico te hace recuperable, y el contenido centrado en la respuesta te hace citable. Para la disciplina en su conjunto, empieza por qué es la AEO.