Qué es realmente una estimación de tráfico orgánico
Una estimación de tráfico orgánico responde a una sola pregunta: si mejoramos nuestra posición para estas palabras clave, ¿cuántos clics adicionales al mes vale eso de forma plausible? Existe para priorizar oportunidades antes de invertir esfuerzo, y eso es todo lo que puede hacer. Tratada como una previsión de lo que ocurrirá, todas las calculadoras de tráfico jamás construidas están equivocadas; tratada como una forma coherente de comparar apuestas, el modelo sencillo de más abajo es genuinamente útil.
Total transparencia sobre esta página: el modelo está documentado aquí por completo en lugar de ocultarse tras un formulario de entrada, porque el cálculo son cuatro columnas de hoja de cálculo y el valor está en entender las asunciones, no en la multiplicación. Cada cifra que necesita el modelo procede de fuentes que tú controlas, principalmente Google Search Console, y las dos entradas genuinamente inciertas, el porcentaje de clics y el efecto de las respuestas de IA, tienen su propia sección porque son donde las estimaciones van a morir.
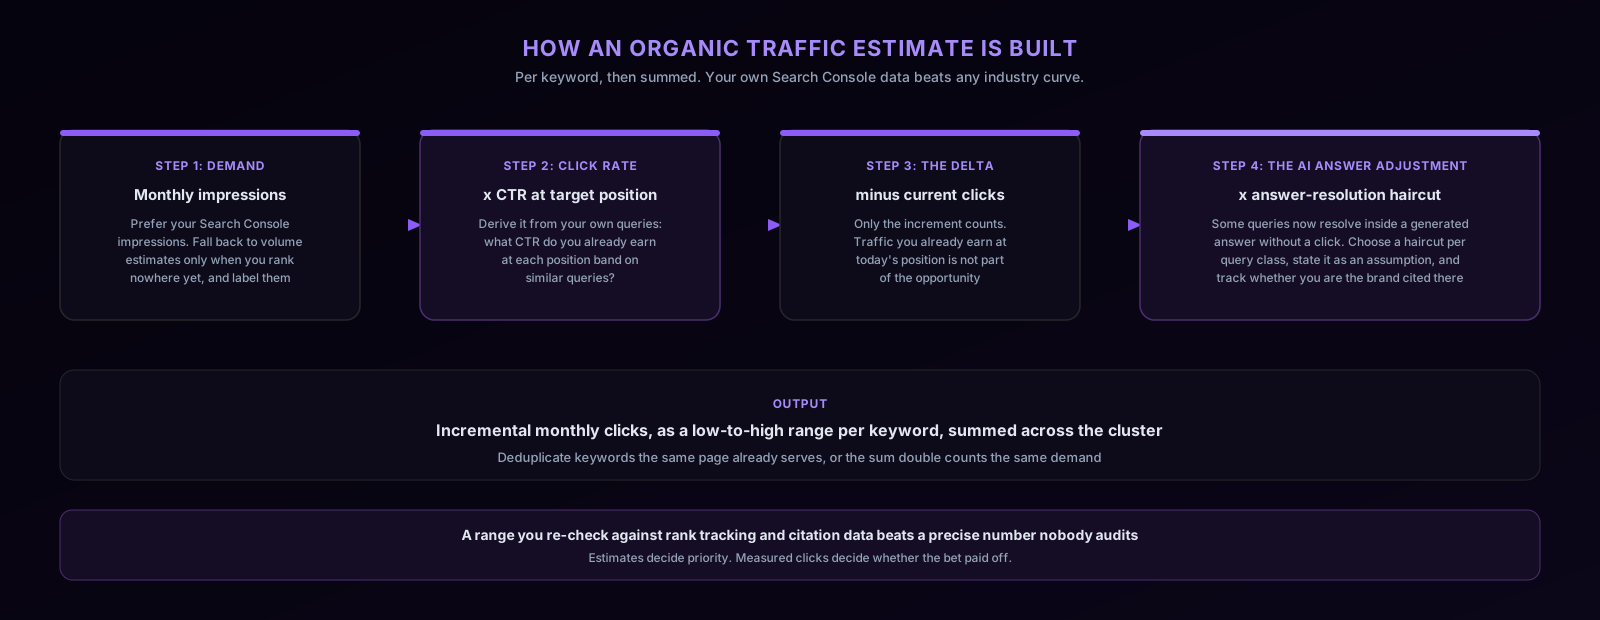
El modelo, paso a paso
Por palabra clave:
expected clicks    = monthly impressions x CTR at target position
incremental clicks = expected clicks - current monthly clicks
cluster total      = sum of incremental clicks across deduplicated keywords
adjusted total     = cluster total x (1 - AI answer haircut)
Paso 1: demanda. Prioriza tus propias impresiones de Search Console frente al volumen de búsqueda de terceros siempre que tengas algo de presencia, porque las impresiones se miden sobre tu mercado real, tu mezcla de dispositivos y tu estacionalidad. Recurre a las estimaciones de volumen solo para las palabras clave donde no posicionas en ningún sitio, y etiqueta esas filas como estimaciones, ya que las cifras de volumen son a su vez números modelados que varían entre proveedores de datos.
Paso 2: tasa de clics en la posición objetivo. Se trata en profundidad más abajo; esta es la entrada que la mayoría de las calculadoras falsean.
Paso 3: resta lo que ya consigues. Solo el incremento es la oportunidad. Una página que pasa de la posición cuatro a la dos conserva sus clics existentes; contarlos de nuevo infla la justificación de trabajar en páginas que ya están bien.
Paso 4: el recorte por respuestas de IA. Cierta fracción de las consultas ahora se resuelve dentro de una respuesta generada sin ningún clic para nadie. Esa fracción varía según la clase de consulta y no se puede consultar en ninguna fuente fiable, así que entra en el modelo como tu asunción declarada, visible y ajustable, en lugar de como optimismo silencioso.
Ejecuta toda la cadena dos veces, con valores pesimistas y optimistas para las dos entradas blandas, y arrastra el rango resultante hacia adelante. Un rango sobrevive al contacto con la realidad; una estimación puntual simplemente queda desmentida.
Construye tu curva de CTR con tus propios datos
El atajo habitual es coger una curva de CTR por posición del sector publicada y multiplicar. El problema: esas curvas promedian marcas, países, intenciones y estructuras de SERP. Tu CTR en la posición tres depende de si la SERP muestra una respuesta de IA, unidades de shopping o tres anuncios, de si la consulta es de marca y de si tu título consigue el clic, nada de lo cual conoce una curva agregada.
La mejor fuente está sentada en tu Search Console: exporta los datos a nivel de consulta, agrupa las consultas por banda de posición media (1 a 3, 4 a 10, 11 a 20) y calcula el CTR que consigues realmente en cada banda, idealmente dividido por tipo de consulta, ya que las consultas informativas y comerciales se comportan de forma distinta. Eso te da una curva calibrada a tus propios fragmentos y a tus propias SERP. Cuando no tengas ninguna presencia, toma prestada la curva de la clase de consulta más parecida para la que sí tengas datos, y recurre a una curva del sector publicada solo como último recurso, etiquetada como tal en el modelo.
Esta es también la respuesta honesta a “¿qué CTR asume esta calculadora?”: no asume nada. El CTR es una entrada que tú derivas, y la calidad de la estimación depende de la calidad de esa derivación.
Un ejemplo resuelto
Solo marcadores ilustrativos, para mostrar la mecánica; cada cifra de más abajo debería sustituirse por tus propios datos.
Supongamos que una página de producto tiene una posición media de ocho para una palabra clave comercial con 12.000 impresiones mensuales y actualmente consigue 240 clics. Tu propia curva de Search Console dice que las consultas comerciales similares consiguen alrededor de un 2 % de CTR en la banda de 4 a 10 y alrededor de un 12 % en la banda de 1 a 3. Apuntando a la posición tres: clics esperados = 12.000 x 12 % = 1.440; incremental = 1.440 - 240 = 1.200 clics al mes antes de ajustar. Si consideras que una cuarta parte de esta clase de consulta ahora se resuelve dentro de respuestas de IA, el incremento ajustado es 1.200 x 0,75 = 900, y el rango honesto, una vez que varías el CTR y el recorte de forma pesimista, podría ir de aproximadamente 500 a 1.200.
La cifra que importa en ese ejemplo no es 900; es el rango, y el hecho de que cada asunción que lo produce esté por escrito y sea discutible. Para convertir el rango de clics en una decisión de financiación, pásaselo a la calculadora de ROI de SEO, que lo encadena a través de la tasa de conversión, el valor del acuerdo y el margen.
Agregar a lo largo de un clúster sin contar dos veces
Las sumas a nivel de palabra clave sobreestiman la oportunidad del clúster de dos formas habituales. Primero, la duplicación: “calculadora de tráfico orgánico” y “calcular tráfico orgánico” son un mismo flujo de demanda servido por una sola página, y sumar sus volúmenes cuenta dos veces a los mismos usuarios que buscan. Deduplica a nivel de página: la unidad de estimación es la URL y su clúster de consultas, no la fila de la palabra clave. Segundo, la canibalización: si dos de tus páginas intercambian posiciones para la misma consulta, una estimación de mejora para una es en parte una transferencia desde la otra, no tráfico neto nuevo.
Search Console vuelve a resolver ambas, ya que informa de impresiones y clics por página además de por consulta. Construye el modelo a nivel de página, usa las consultas solo para entender qué podría servir adicionalmente la página y comprueba qué URL posiciona realmente para cada consulta objetivo con el seguimiento de posiciones antes de atribuir una ganancia a nadie. Para descubrir el clúster en primer lugar, la investigación de palabras clave aporta volumen, dificultad y variantes de preguntas por término semilla.
Dónde encaja la visibilidad en IA en la estimación
El recorte del paso 4 trata las respuestas de IA puramente como pérdida de tráfico, lo cual es solo la mitad de la verdad. Cuando una consulta se resuelve dentro de una respuesta generada, normalmente se nombra la marca de alguien y se cita la URL de alguien, y ser esa marca tiene un valor que el modelo de clics no puede ver: el comprador llega más tarde como búsqueda de marca o directa, o te incluye en su lista de opciones sin visitarte en absoluto.
Por eso, combina el modelo con la medición en la capa de respuestas. La investigación de palabras clave de AEO Goal informa de la frecuencia de respuestas de IA por palabra clave, lo que te indica qué filas de tu modelo merecen un recorte fuerte, y el seguimiento de citas de IA muestra si eres tú o un competidor la fuente que citan esas respuestas. Una palabra clave con un recorte grande y un competidor que se lleva la cita no es una oportunidad muerta; es una oportunidad diferente, perseguida mediante contenido pensado primero para las respuestas en lugar de ganancias de posición, y medida a través del Share of Model en lugar de las sesiones. Este es el bucle de AEO Goal de principio a fin: la estimación señala la brecha, se despliega la mejora y el siguiente análisis muestra si se movieron las citas o los clics. Puedes comprobar ahora tu preparación técnica para cualquiera de estas cosas con el análisis gratuito de visibilidad en IA, sin registro.
Errores habituales
Sumar volúmenes de búsqueda y llamarlo oportunidad. El volumen son impresiones como mucho; la oportunidad son clics incrementales tras el CTR, el tráfico actual y la deduplicación. Los dos difieren de forma rutinaria en un orden de magnitud.
Asumir la posición uno. Modelar cada objetivo en la primera posición produce totales de fantasía. Modela la posición que puedes defender dada la competencia, algo que el análisis SEO de la competencia hace concreto.
Curvas de CTR prestadas presentadas como un hecho. La corrupción más común de todas. Tu propia curva de Search Console está medida; cualquier otra cosa es un respaldo etiquetado.
Ignorar la capa de respuestas de IA. Las estimaciones construidas sobre el comportamiento de clics previo a la IA sobreestiman silenciosamente la oportunidad de las consultas informativas. Declara el recorte, aunque sea una suposición; una suposición visible se puede discutir y mejorar.
No reconciliar nunca. Seis meses después, compara los clics incrementales reales con el rango que escribiste. La habilidad de estimar solo mejora a través de ese bucle, y los modelos sin reconciliar repiten su optimismo para siempre.
Preguntas frecuentes
¿Esta calculadora es gratuita? El modelo está totalmente documentado en esta página y funciona en cualquier hoja de cálculo con tu propia exportación de Search Console. El análisis gratuito de AEO Goal comprueba la preparación técnica en IA de cualquier dominio sin registro; los datos de volumen, dificultad y frecuencia de respuestas de IA, además del seguimiento continuo de posiciones y citas, son funciones de la aplicación.
¿Qué precisión tienen las estimaciones de tráfico orgánico? Lo bastante precisas como para ordenar oportunidades entre sí sobre asunciones coherentes, y no lo bastante precisas como para prometer una cifra a un responsable. Presenta rangos, reconcilia con los datos reales y el modelo se gana la confianza que merezca.
¿Puedo estimar el tráfico orgánico de un competidor con esto? No de forma creíble a nivel absoluto: no tienes acceso a su Search Console, y las estimaciones de terceros arrastran grandes márgenes de error en sitios individuales. Sus posiciones observables en las palabras clave que compartís, mediante el seguimiento de posiciones y el análisis de la competencia, son más útiles para decidir que una cifra de sesiones modelada.