Une liste de vérification AEO qui fonctionne se déroule en sept étapes, dans l’ordre : ouvrir l’accès aux robots d’IA que vous voulez réellement (GPTBot, ClaudeBot, PerplexityBot se comportent chacun différemment), structurer chaque page pour qu’une réponse de 40 à 60 mots soit extractible au chargement, livrer un schema qui correspond au contenu visible, rendre votre entité sans ambiguïté, ajouter des preuves qu’un moteur peut attribuer, garder les faits off-page cohérents, puis relancer les prompts d’acheteurs par moteur et mesurer le taux de citations et le Share of Model pour décider quoi corriger ensuite. L’ordre compte : un robot bloqué rend chaque étape en aval sans objet, et sauter la mesure signifie que vous n’apprenez jamais quels correctifs ont fonctionné.
Si vous débutez dans la discipline, ce qu’est l’optimisation pour les moteurs de réponse couvre le pourquoi ; cette page est le comment. Parcourez-la de haut en bas la première fois, puis traitez les étapes 1 à 6 comme des barrières que vous revérifiez et l’étape 7 comme une boucle que vous n’arrêtez jamais.
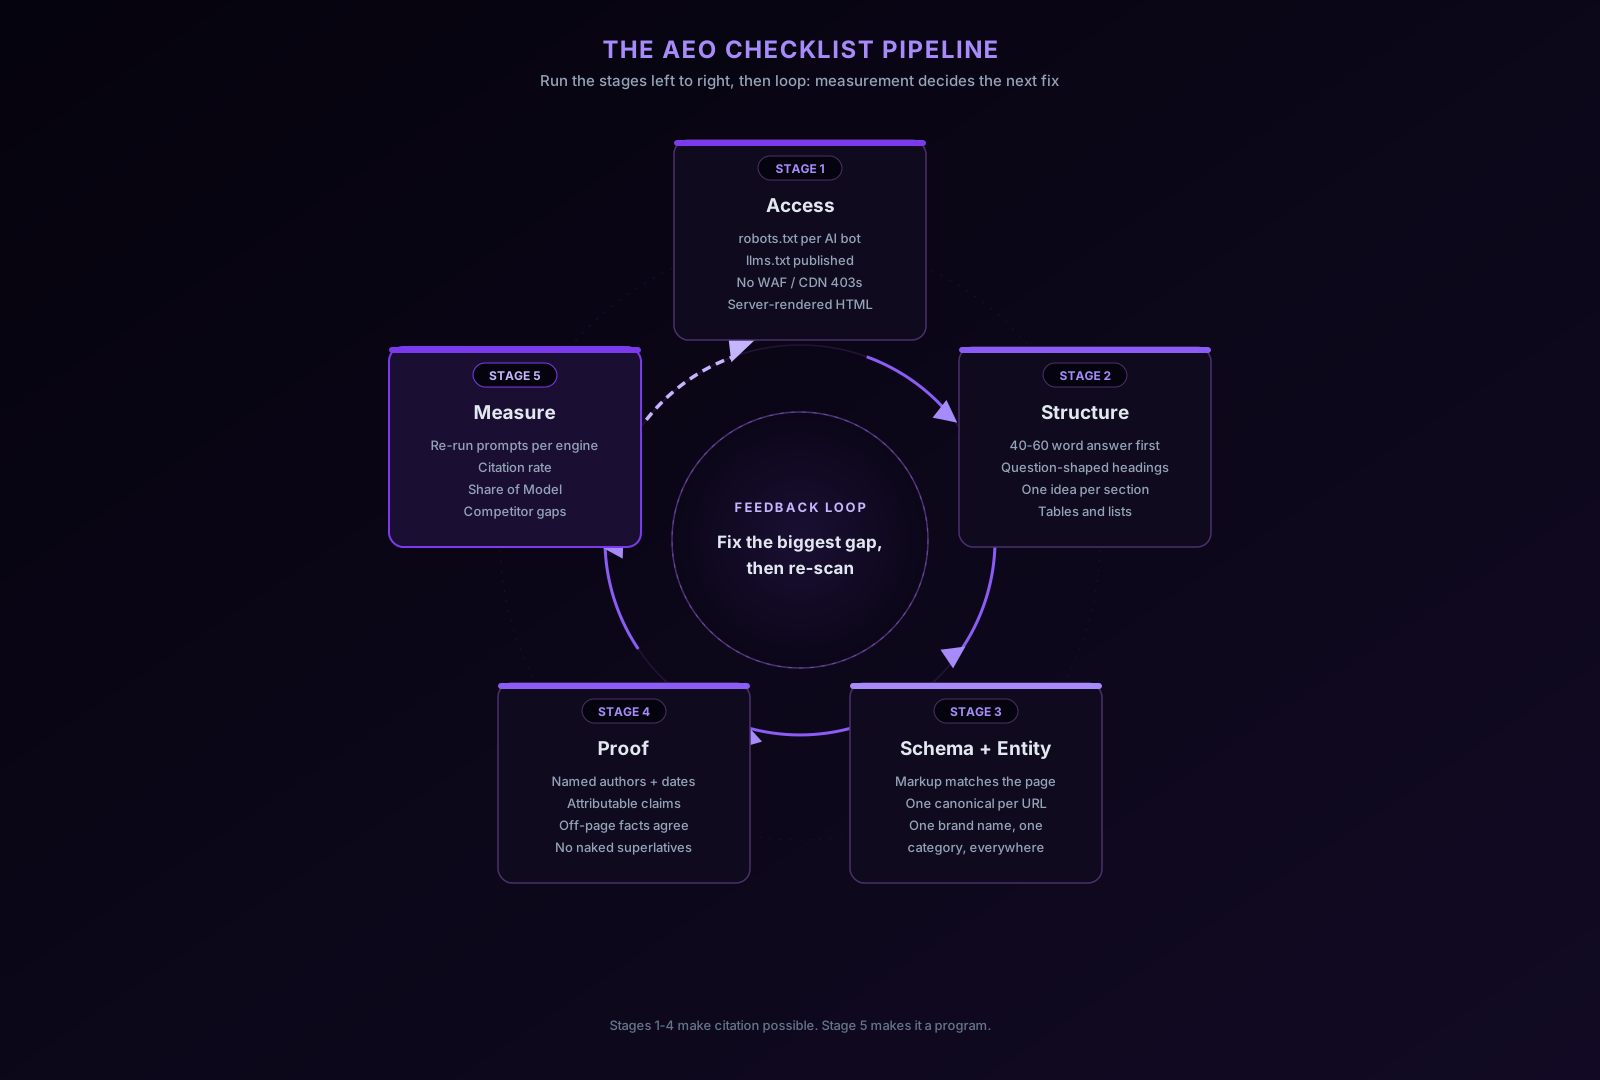
Étape 1 : les robots d’IA peuvent-ils atteindre et lire vos pages ?
Tout en AEO dépend de la récupération. Si le robot d’un moteur ne peut pas récupérer votre page, ou récupère une coquille JavaScript vide, rien de ce que vous écrivez ne sera jamais cité. Vérifiez cette couche en premier, et revérifiez-la après chaque changement de CDN, de WAF ou d’hébergement.
Commencez par le robots.txt, et traitez chaque bot comme une décision distincte, car ils servent des objectifs différents. La distinction clé est récupération versus entraînement : les bots de récupération récupèrent les pages pour construire des réponses en direct (les bloquer vous coûte directement des citations), tandis que les jetons réservés à l’entraînement déterminent si votre contenu entraîne les futurs modèles (les bloquer est un choix de politique sans coût immédiat en citations). OpenAI documente ses bots séparément pour exactement cette raison, et l’introduction à robots.txt de Google couvre la syntaxe si vous avez besoin d’un rappel.
| Jeton du bot | Opérateur | Ce qu’il alimente | Règle de décision |
|---|---|---|---|
| OAI-SearchBot | OpenAI | Index de recherche de ChatGPT | Autoriser si vous voulez des citations ChatGPT |
| ChatGPT-User | OpenAI | Récupérations en direct quand un utilisateur demande | Autoriser ; le bloquer casse la récupération dans la réponse |
| GPTBot | OpenAI | Entraînement du modèle | Choix de politique ; aucun coût direct en citations |
| ClaudeBot | Anthropic | Exploration et récupération de Claude | Autoriser si vous voulez de la visibilité Claude |
| PerplexityBot / Perplexity-User | Perplexity | Index de Perplexity et récupérations en direct | Autoriser ; Perplexity cite ses sources de façon agressive |
| Google-Extended | Entraînement et grounding de Gemini | Choix de politique ; n’affecte pas les positions dans la recherche | |
| Googlebot | Index de recherche, qui alimente AI Overviews | Toujours autoriser ; le bloquer est une décision SEO, pas AEO | |
| CCBot | Common Crawl | Jeux de données publics sur lesquels de nombreux modèles s’entraînent | Choix de politique ; le bloquer vous retire de ces corpus |
Vérifications concrètes pour cette étape :
- Récupérez
https://yourdomain.com/robots.txtet lisez-le ligne par ligne. UnUser-agent: * / Disallow: /global hérité d’une configuration de préproduction est la blessure AEO auto-infligée la plus courante. - Testez ce que les bots reçoivent réellement, pas ce que votre navigateur voit.
curl -A "PerplexityBot" https://yourdomain.com/pagedepuis un hôte externe expose les règles de WAF et de CDN qui renvoient un 403 aux user agents de bots alors que robots.txt indique autoriser. Les réglages par défaut de gestion des bots sur les CDN populaires défient ou bloquent fréquemment les robots d’IA en silence ; robots.txt ne peut pas corriger une règle de pare-feu. - Confirmez que le contenu de réponse principal se trouve dans le HTML rendu côté serveur. La plupart des robots d’IA n’exécutent pas le JavaScript, donc une page qui hydrate son contenu côté client leur apparaît vide. Affichez la source (pas l’inspecteur d’éléments des DevTools, qui montre le DOM rendu) et cherchez votre paragraphe d’ouverture.
- Publiez un fichier
llms.txtlistant vos pages les plus citables avec des descriptions d’une ligne. C’est une convention émergente, pas un standard à consommation garantie, mais elle coûte un fichier statique et donne aux agents une carte organisée de votre site. Voyez comment fonctionne llms.txt pour le format. - Gardez les sitemaps à jour et les URL canoniques stables ; les bots de récupération découvrent via la même infrastructure d’exploration que la recherche classique, ce qui explique pourquoi cette étape recoupe presque entièrement la liste de vérification du SEO technique.
Si vous voulez générer le bloc d’autorisation/refus plutôt que de l’écrire à la main, le générateur de robots.txt couvre les jetons des bots d’IA ci-dessus.
Étape 2 : la réponse est-elle extractible dès le premier écran ?
Les moteurs de réponse ne citent pas des pages ; ils citent des passages. La récupération extrait une poignée de blocs qui correspondent au prompt, et le modèle cite ou paraphrase le plus clair. Votre travail est de vous assurer que le bloc gagnant existe, se situe tôt dans le document et survit à une lecture hors contexte.
- Ouvrez chaque page génératrice de revenus par une réponse directe de 40 à 60 mots à la question que vise la page. La conclusion d’abord, le raisonnement ensuite. Cette longueur correspond à la façon dont les moteurs résument une source sans la tronquer au milieu d’une affirmation.
- Utilisez des titres en forme de question qui reflètent la façon dont les acheteurs formulent réellement le prompt (« Comment autoriser GPTBot à explorer mon site ? » l’emporte sur « Configuration du robot »). La récupération se fait par similarité sémantique, et un titre qui reformule la question ancre le bloc à celle-ci.
- Une idée par section H2 ou H3, des paragraphes de 2 à 4 phrases. Une section qui n’a de sens qu’après avoir lu les trois sections précédentes ne peut pas être extraite seule, et la récupération par blocs l’extraira seule.
- Préférez les tableaux et les listes pour tout ce qui est comparatif ou énumérable. Les lignes structurées sont le contenu le plus facile à reproduire fidèlement pour un modèle ; le tableau des bots à l’étape 1 fait exactement ce travail sur cette page.
- Éliminez les modes d’échec : les réponses cachées derrière des accordéons, des onglets ou des bascules « lire plus » qui exigent un clic pour s’afficher ; les textes truffés de pronoms où « il » et « la plateforme » remplacent le nom du sujet (répétez l’entité, car le bloc peut être le seul texte que le modèle voit) ; et le contenu uniquement en JS, qui échoue à l’étape 1 avant même d’échouer ici.
Le cadre d’optimisation de contenu va plus loin sur la réécriture des pages existantes vers cette forme sans les vider de leur substance.
Étape 3 : votre schema raconte-t-il la même histoire que la page ?
Les données structurées ne garantissent pas les citations, mais elles lèvent l’ambiguïté sur ce qu’est une page, qui l’a écrite et quand elle a changé, exactement les métadonnées que les moteurs utilisent pour décider si une source peut être citée en toute sécurité. La règle de l’étape 3 est une cohérence stricte : le balisage doit décrire un contenu qu’un lecteur peut voir.
- Livrez
Article(ou le type plus spécifique qui convient) avecauthor,datePublishedetdateModifiedsur chaque page éditoriale. L’introduction aux données structurées de Google explique comment le balisage est consommé ; la mécanique se généralise au-delà de Google. - Appliquez la règle de décision FAQ : ajoutez le balisage FAQPage uniquement lorsque la page visible répond réellement à plusieurs questions distinctes qu’un acheteur poserait. Si vous devez inventer des questions pour justifier le balisage, la page n’en avait pas besoin. Et ne balisez jamais une réponse qui n’apparaît pas dans le HTML rendu : un schema qui ne correspond pas au contenu visible est le mode d’échec classique qui érode la confiance, car il apparaît comme une manipulation à tout système qui recoupe.
- Un seul canonical auto-référentiel par page. Des canonicals dupliqués ou contradictoires divisent votre capital de citation entre les URL de la même façon qu’ils divisent le capital de liens.
- Ajoutez le balisage
OrganizationetProductsur les pages qui définissent votre marque, avec des lienssameAsvers les profils que vous contrôlez. Cela alimente directement l’étape 4.
Le générateur de balisage schema produit du JSON-LD valide pour les types courants si vous préférez ne pas l’écrire à la main.
Étape 4 : votre entité est-elle sans ambiguïté ?
Les moteurs répondent à des questions sur des entités, pas sur des URL. Si un modèle ne peut pas déterminer à quelle entreprise « Acme » fait référence, ou associe le nom de votre marque à une autre catégorie de produit, aucun peaufinage au niveau de la page n’y remédie.
- Utilisez un seul nom de marque canonique, un seul nom de produit et un seul descripteur de catégorie, orthographiés à l’identique partout : texte de page, schema, pied de page, profils sociaux, annuaires. Les variantes orthographiques fragmentent l’entité.
- Rédigez une phrase de définition sur vos pages principales qui indique ce qu’est la marque sous une forme sujet-verbe-objet claire (« Acme est une plateforme de paie pour les restaurants »). Les modèles réutilisent mot pour mot les définitions nettes dans les réponses de type « qu’est-ce que ».
- Indiquez votre catégorie à côté de votre différenciateur, car les moteurs classent avant de recommander. Une marque sans catégorie claire est entièrement omise des réponses de type liste.
- Vérifiez à quel point votre entité cible est réellement saillante sur la page plutôt que de le deviner ; l’analyse de prominence des entités évalue si la page porte bien sur ce que vous pensez.
Étape 5 : un moteur peut-il attribuer et faire confiance à vos affirmations ?
Les moteurs de réponse sont optimisés pour éviter de citer des sources qui semblent fabriquées ou non responsables, ce qui rend les signaux E-E-A-T mécaniquement utiles plutôt que simplement réputationnels.
- Des auteurs nommés avec de vraies bios sur le contenu éditorial, balisés dans le schema et visibles sur la page.
- Une date de dernière mise à jour visible et honnête. Les moteurs comme les utilisateurs dévaluent les pages obsolètes, et une fausse date qui contredit les versions archivées est pire qu’une ancienne.
- Des affirmations attribuables : chaque statistique et comparaison pointe vers une source qu’un lecteur peut vérifier. Remplacez « la plupart des équipes obtiennent des résultats » par une affirmation précise et sourcée, ou supprimez-la.
- Aucun superlatif non étayé. « Le meilleur » et « le plus rapide » sans comparaison citée sont exactement les expressions que les modèles sont entraînés à traiter comme du marketing plutôt que comme des preuves.
Étape 6 : les sources off-page sont-elles d’accord avec vous ?
Les modèles synthétisent à partir de nombreuses sources, donc les pages de tiers qui vous décrivent mal concurrencent activement les vôtres. Auditez les profils et fiches que vous contrôlez (annuaires, plateformes d’avis, bios sociales, pages partenaires) et alignez les noms, catégories et affirmations factuelles avec votre site. Là où des avis et des articles de comparaison que vous ne contrôlez pas vous décrivent de façon inexacte, publier une page claire, structurée et faisant autorité sur la même question donne aux moteurs un meilleur bloc à préférer. C’est aussi là que le travail d’autorité classique rapporte double : les mêmes domaines référents qui construisent l’autorité de classement sont, de façon disproportionnée, les domaines depuis lesquels les moteurs récupèrent, ce qui explique pourquoi le link building et les relations presse numériques alimentent l’AEO sans effort supplémentaire.
Étape 7 : mesurer, prioriser, répéter
La liste de vérification sans mesure est une supposition. Les moteurs révisent constamment leurs réponses, donc la vérification doit être une boucle, pas une tâche de lancement.
- Relancez vos prompts d’acheteurs suivis contre chaque moteur séparément : ChatGPT, Claude, Gemini et Perplexity récupèrent différemment et citent des sources différentes, donc une vue par moteur est la seule honnête.
- Suivez le taux de citations par moteur : sur quelle part de vos prompts êtes-vous cité ou mentionné, tout court ?
- Suivez le Share of Model : de toutes les mentions de marque sur votre ensemble de prompts, quelle part est la vôtre par rapport à chaque concurrent ? Le taux de citations dit si vous existez ; le Share of Model dit si vous gagnez.
- Priorisez par écart concurrentiel. Les prompts où un concurrent est systématiquement cité et où vous êtes absent sont vos cibles à plus fort effet de levier, car le moteur a déjà prouvé qu’il veut citer quelqu’un pour cette question. Le guide de la stratégie de citations en IA explique comment transformer ces écarts en une file d’attente de contenu.
Cette boucle est le jumeau AEO du suivi de positions. Le SEO classique mesure les positions par mot-clé chaque jour ; l’AEO mesure les citations par prompt par moteur selon une cadence. Même discipline, surface différente, et comme le soutient AEO face au SEO traditionnel, les équipes qui exécutent les deux boucles depuis un seul backlog cessent de rediscuter à quel canal appartient un correctif.
Exécuter cette liste de vérification avec AEO Goal
Vous pouvez exécuter chaque étape ci-dessus à la main avec curl, un validateur de schema et une feuille de calcul de prompts. AEO Goal existe parce que la boucle est fastidieuse à exécuter manuellement et brutale à maintenir chaque mois. Son scanner couvre automatiquement les étapes 1 à 4 : il vérifie robots.txt sur les jetons des bots d’IA du tableau de l’étape 1, vérifie llms.txt, valide les données structurées et évalue la prominence des entités, l’explorateur de site faisant ressortir les échecs uniquement en JS et les 403 qui se cachent aux vérifications de navigateur. Pour l’étape 7, le suivi des citations en IA relance vos prompts contre ChatGPT, Claude, Gemini et Perplexity selon un calendrier et rapporte le taux de citations, le Share of Model et le sentiment par moteur (la méthodologie documente exactement comment les réponses sont collectées et analysées, sans réponses simulées).
La différence avec les outils de suivi seul, c’est ce qui se passe entre la mesure et le scan suivant : chaque écart est livré avec un correctif concret (un brief answer-first via la génération de contenu AEO, un changement de schema ou une correction d’accès des robots) et le suivi de la visibilité dans l’IA montre si le correctif a déplacé le chiffre lors de l’exécution suivante. La liste de vérification reste la vôtre ; l’outil ne fait que refermer la boucle plus vite.
La liste de vérification, condensée
- Accès : robots.txt par bot, test 403 WAF/CDN avec les user agents de bots, HTML rendu côté serveur, llms.txt, sitemap à jour.
- Structure : réponse de 40 à 60 mots en haut, titres en forme de question, une idée par section, tableaux pour les comparaisons, pas de réponses cachées en accordéon, pas de soupe de pronoms.
- Schema : Article plus auteur et dates partout ; FAQPage uniquement là où de vraies questions existent ; le balisage correspond au contenu visible ; un seul canonical.
- Entité : un nom, une catégorie, une définition nette, cohérente partout.
- Preuves : auteurs nommés, dates honnêtes, affirmations attribuables, pas de superlatifs nus.
- Off-page : les profils et fiches sont d’accord avec votre site ; le travail d’autorité alimente les deux surfaces.
- Mesure : prompts relancés par moteur, taux de citations et Share of Model suivis, écarts concurrentiels priorisés, boucle répétée.
Les étapes 1 à 6 rendent la citation possible. L’étape 7 en fait un programme.