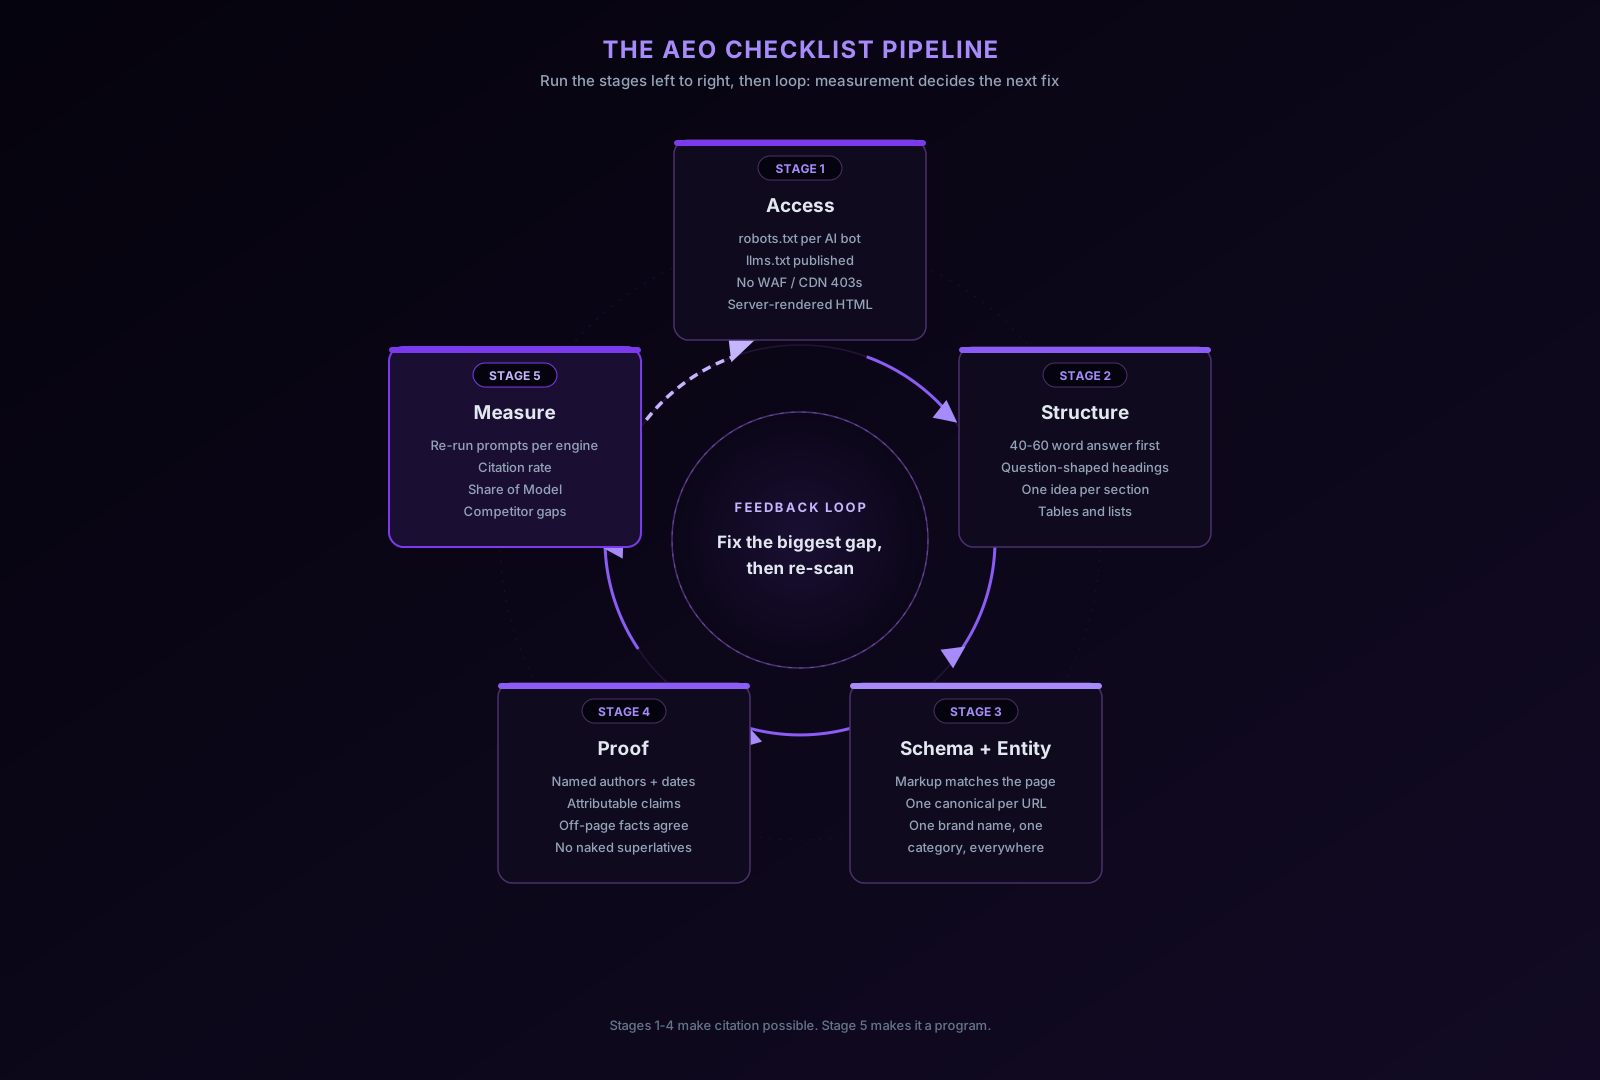
Un checklist de AEO que funciona se ejecuta en siete etapas, en orden: abre el acceso de rastreo a los bots de IA que realmente quieres (GPTBot, ClaudeBot y PerplexityBot se comportan de forma distinta cada uno), estructura cada página para que una respuesta de 40 a 60 palabras sea extractable en la carga, publica schema que coincida con el contenido visible, haz que tu entidad sea inequívoca, añade pruebas que un motor pueda atribuir, mantén coherentes los datos fuera de página y, después, vuelve a lanzar los prompts de compra por motor y mide la tasa de citación y el Share of Model para decidir qué arreglar a continuación. El orden importa: un crawler bloqueado hace irrelevante cada etapa posterior, y saltarse la medición significa que nunca aprendes qué arreglos funcionaron.
Si eres nuevo en la disciplina, qué es la optimización para motores de respuesta cubre el porqué; esta página es el cómo. Recórrela de arriba abajo la primera vez y luego trata las etapas 1 a 6 como puertas que vuelves a revisar y la etapa 7 como un ciclo que nunca dejas de ejecutar.
Etapa 1: ¿Pueden los crawlers de IA alcanzar y leer tus páginas?
Todo en AEO depende de la recuperación. Si el crawler de un motor no puede obtener tu página, u obtiene un cascarón vacío de JavaScript, nada de lo que escribas se citará jamás. Comprueba esta capa primero, y vuelve a comprobarla después de cada cambio de CDN, WAF u hosting.
Empieza por robots.txt y trata cada bot como una decisión separada, porque sirven para propósitos distintos. La división clave es recuperación frente a entrenamiento: los bots de recuperación obtienen páginas para construir respuestas en vivo (bloquearlos te cuesta citas directamente), mientras que los tokens solo de entrenamiento determinan si tu contenido entrena futuros modelos (bloquearlos es una decisión de política sin coste inmediato de citación). OpenAI documenta sus bots por separado exactamente por esta razón, y la introducción a robots.txt de Google cubre la sintaxis si necesitas un repaso.
| Token del bot | Operador | Qué alimenta | Regla de decisión |
|---|---|---|---|
| OAI-SearchBot | OpenAI | Índice de búsqueda de ChatGPT | Permítelo si quieres citas en ChatGPT |
| ChatGPT-User | OpenAI | Peticiones en vivo cuando un usuario pregunta | Permítelo; bloquearlo rompe la recuperación dentro de la respuesta |
| GPTBot | OpenAI | Entrenamiento del modelo | Decisión de política; sin coste directo de citación |
| ClaudeBot | Anthropic | Rastreo y recuperación de Claude | Permítelo si quieres visibilidad en Claude |
| PerplexityBot / Perplexity-User | Perplexity | Índice de Perplexity y peticiones en vivo | Permítelo; Perplexity cita fuentes de forma agresiva |
| Google-Extended | Entrenamiento y grounding de Gemini | Decisión de política; no afecta al posicionamiento en Search | |
| Googlebot | Índice de Search, que alimenta AI Overviews | Permítelo siempre; bloquearlo es una decisión de SEO, no de AEO | |
| CCBot | Common Crawl | Datasets públicos con los que se entrenan muchos modelos | Decisión de política; bloquearlo te elimina de esos corpus |
Comprobaciones concretas para esta etapa:
- Obtén
https://tudominio.com/robots.txty léelo línea por línea. UnUser-agent: * / Disallow: /general heredado de una configuración de staging es la herida de AEO autoinfligida más común. - Prueba qué reciben realmente los bots, no lo que ve tu navegador.
curl -A "PerplexityBot" https://tudominio.com/paginadesde un host externo expone reglas de WAF y CDN que devuelven un 403 a los user agents de bots mientras robots.txt dice que se permite. Los valores por defecto de gestión de bots en las CDN populares con frecuencia desafían o bloquean a los crawlers de IA en silencio; robots.txt no puede arreglar una regla de firewall. - Confirma que el contenido de la respuesta principal está en HTML renderizado en servidor. La mayoría de crawlers de IA no ejecutan JavaScript, así que una página que hidrata su contenido en el cliente les parece vacía. Consulta el código fuente (no el inspector de elementos de DevTools, que muestra el DOM renderizado) y busca tu párrafo inicial.
- Publica un archivo
llms.txtque liste tus páginas más citables con descripciones de una línea. Es una convención emergente, no un estándar con consumo garantizado, pero cuesta un archivo estático y ofrece a los agentes un mapa curado de tu sitio. Consulta cómo funciona llms.txt para el formato. - Mantén los sitemaps actualizados y las URL canónicas estables; los bots de recuperación descubren a través de la misma infraestructura de rastreo que usa la búsqueda clásica, y por eso esta etapa se solapa casi por completo con el checklist de SEO técnico.
Si prefieres generar el bloque de permitir o denegar en lugar de escribirlo a mano, el generador de robots.txt cubre los tokens de bots de IA anteriores.
Etapa 2: ¿Es la respuesta extractable en la primera pantalla?
Los motores de respuesta no citan páginas; citan pasajes. La recuperación extrae un puñado de fragmentos que coinciden con el prompt, y el modelo cita o parafrasea el más claro. Tu tarea es asegurarte de que el fragmento ganador exista, aparezca pronto en el documento y sobreviva a ser leído fuera de contexto.
- Abre cada página de conversión con una respuesta directa de 40 a 60 palabras a la pregunta que la página busca resolver. La conclusión primero, el razonamiento después. Esa longitud encaja con cómo los motores resumen una fuente sin truncarla a mitad de una afirmación.
- Usa encabezados con forma de pregunta que reflejen cómo formulan realmente el prompt los compradores (“¿Cómo dejo que GPTBot rastree mi sitio?” es mejor que “Configuración del crawler”). La recuperación empareja por similitud semántica, y un encabezado que reformula la pregunta ancla el fragmento a ella.
- Una idea por sección H2 o H3, párrafos de 2 a 4 frases. Una sección que solo tiene sentido después de leer las tres secciones anteriores no puede extraerse por sí sola, y la recuperación por fragmentos la extraerá por sí sola.
- Prefiere tablas y listas para cualquier cosa comparable o enumerable. Las filas estructuradas son el contenido más fácil de reproducir con fidelidad para un modelo; la tabla de bots de la etapa 1 hace exactamente ese trabajo en esta página.
- Elimina los modos de fallo: respuestas ocultas tras acordeones, pestañas o botones de “leer más” que requieren un clic para renderizarse; textos cargados de pronombres donde “eso” y “la plataforma” reemplazan el nombre del sujeto (reafirma la entidad, porque el fragmento puede ser el único texto que ve el modelo); y contenido solo en JS, que falla en la etapa 1 antes de llegar a fallar aquí.
El framework de optimización de contenido profundiza en cómo reescribir páginas existentes con esta forma sin vaciarlas de contenido.
Etapa 3: ¿Cuenta tu schema la misma historia que la página?
Los datos estructurados no garantizan citas, pero desambiguan qué es una página, quién la escribió y cuándo cambió, exactamente los metadatos que los motores usan para decidir si una fuente es segura para citar. La regla de la etapa 3 es la coherencia estricta: el marcado debe describir contenido que un lector pueda ver.
- Publica
Article(o el tipo más específico que encaje) conauthor,datePublishedydateModifieden cada página editorial. La introducción a los datos estructurados de Google explica cómo se consume el marcado; la mecánica se generaliza más allá de Google. - Aplica la regla de decisión de FAQ: añade marcado FAQPage solo cuando la página visible responda de verdad a varias preguntas distintas que un comprador se plantearía. Si tienes que inventarte preguntas para justificar el marcado, la página no lo necesitaba. Y nunca marques una respuesta que no aparece en el HTML renderizado: un schema que no coincide con el contenido visible es el modo de fallo clásico que erosiona la confianza, porque cualquier sistema que haga comprobaciones cruzadas lo interpreta como manipulación.
- Un canónico autorreferencial por página. Los canónicos duplicados o contradictorios reparten tu capital de citación entre URL igual que reparten el capital de enlaces.
- Añade marcado
OrganizationyProducten las páginas que definen tu marca, con enlacessameAsa los perfiles que controlas. Esto alimenta directamente la etapa 4.
El generador de marcado de schema produce JSON-LD válido para los tipos comunes si prefieres no escribirlo a mano.
Etapa 4: ¿Es tu entidad inequívoca?
Los motores responden preguntas sobre entidades, no sobre URL. Si un modelo no puede resolver a qué empresa se refiere “Acme”, o asocia el nombre de tu marca con una categoría de producto distinta, ningún pulido a nivel de página lo arregla.
- Usa un único nombre de marca canónico, un único nombre de producto y un único descriptor de categoría, escritos de forma idéntica en todas partes: texto de la página, schema, pie de página, perfiles sociales, directorios. Las grafías variantes fragmentan la entidad.
- Escribe una frase definitoria en tus páginas principales que enuncie qué es la marca en una forma clara de sujeto-verbo-objeto (“Acme es una plataforma de nóminas para restaurantes”). Los modelos reutilizan las definiciones limpias palabra por palabra en las respuestas de tipo “qué es”.
- Enuncia tu categoría junto a tu diferenciador, porque los motores clasifican antes de recomendar. Una marca sin una categoría clara queda omitida por completo de las respuestas en forma de lista.
- Comprueba cuán prominente es realmente tu entidad objetivo en la página en lugar de adivinar; el análisis de saliencia de entidad puntúa si la página trata sobre lo que crees que trata.
Etapa 5: ¿Puede un motor atribuir y confiar en tus afirmaciones?
Los motores de respuesta están optimizados para evitar citar fuentes que parezcan fabricadas o poco fiables, lo que hace que las señales de E-E-A-T sean mecánicamente útiles y no solo reputacionales.
- Autores identificados con biografías reales en el contenido editorial, marcados en el schema y visibles en la página.
- Una fecha de última actualización visible y honesta. Tanto los motores como los usuarios penalizan las páginas obsoletas, y una fecha falsa que contradice las versiones archivadas es peor que una fecha antigua.
- Afirmaciones atribuibles: cada estadística y cada comparación apunta a una fuente que el lector pueda verificar. Sustituye “la mayoría de los equipos ven resultados” por una afirmación específica y con fuente, o bórrala.
- Sin superlativos sin respaldo. “El mejor” y “el más rápido” sin una comparación citada son exactamente las expresiones que los modelos están entrenados para tratar como marketing y no como evidencia.
Etapa 6: ¿Coinciden las fuentes externas contigo?
Los modelos sintetizan a partir de muchas fuentes, así que las páginas de terceros que te describen de forma incorrecta compiten activamente con las tuyas. Audita los perfiles y las fichas que controlas (directorios, plataformas de reseñas, biografías sociales, páginas de partners) y alinea los nombres, las categorías y las afirmaciones fácticas con tu sitio. Donde las reseñas y las comparativas que no controlas te describen de forma inexacta, publicar una página bien estructurada y con autoridad sobre la misma pregunta da a los motores un mejor fragmento que preferir. Aquí también el trabajo de autoridad clásico rinde el doble: los mismos dominios de referencia que construyen autoridad de posicionamiento son, de forma desproporcionada, los dominios de los que recuperan los motores, y por eso el link building y la PR digital alimentan el AEO sin ningún esfuerzo adicional.
Etapa 7: Mide, prioriza, repite
El checklist sin medición es una conjetura. Los motores revisan sus respuestas constantemente, así que la verificación tiene que ser un ciclo, no una tarea de lanzamiento.
- Vuelve a lanzar tus prompts de compra monitorizados contra cada motor por separado: ChatGPT, Claude, Gemini y Perplexity recuperan de forma distinta y citan fuentes distintas, así que una vista por motor es la única honesta.
- Monitoriza la tasa de citación por motor: ¿en qué proporción de tus prompts se te cita o menciona siquiera?
- Monitoriza el Share of Model: de todas las menciones de marca en tu conjunto de prompts, ¿qué parte es tuya frente a cada competidor? La tasa de citación dice si existes; el Share of Model dice si estás ganando.
- Prioriza por el hueco frente al competidor. Los prompts donde un competidor se cita de forma constante y tú estás ausente son tus objetivos de mayor palanca, porque el motor ya ha demostrado que quiere citar a alguien para esa pregunta. La guía de estrategia de citación en IA explica cómo convertir esos huecos en una cola de contenido.
Este ciclo es el gemelo del seguimiento de posiciones en AEO. El SEO clásico mide posiciones por palabra clave a diario; el AEO mide citas por prompt y por motor con una cadencia. La misma disciplina, distinta superficie, y como argumenta AEO frente al SEO tradicional, los equipos que ejecutan ambos ciclos desde un solo backlog dejan de discutir a qué canal pertenece un arreglo.
Ejecutar este checklist con AEO Goal
Puedes ejecutar cada etapa anterior a mano con curl, un validador de schema y una hoja de cálculo de prompts. AEO Goal existe porque el ciclo es tedioso de ejecutar a mano y brutal de mantener cada mes. Su escáner cubre las etapas 1 a 4 de forma automática: comprueba robots.txt en los tokens de bots de IA de la tabla de la etapa 1, verifica llms.txt, valida los datos estructurados y puntúa la saliencia de entidad, con el crawler del sitio sacando a la luz los fallos de contenido solo en JS y de 403 que se ocultan de las comprobaciones del navegador. Para la etapa 7, el seguimiento de citaciones en IA vuelve a lanzar tus prompts contra ChatGPT, Claude, Gemini y Perplexity de forma programada e informa de la tasa de citación, el Share of Model y el sentimiento por motor (la metodología documenta exactamente cómo se recogen y analizan las respuestas, sin respuestas simuladas).
La diferencia frente a las herramientas de solo seguimiento es lo que ocurre entre la medición y el siguiente escaneo: cada hueco se entrega con un arreglo concreto (un brief con la respuesta primero mediante la generación de contenido con AEO, un cambio de schema o una corrección del acceso de rastreo) y el seguimiento de visibilidad en IA muestra si el arreglo movió el número en la siguiente ejecución. El checklist sigue siendo tuyo; la herramienta solo cierra el ciclo más rápido.
El checklist, en resumen
- Acceso: robots.txt por bot, prueba de 403 de WAF/CDN con user agents de bots, HTML renderizado en servidor, llms.txt, sitemap actualizado.
- Estructura: respuesta de 40 a 60 palabras arriba, encabezados con forma de pregunta, una idea por sección, tablas para comparaciones, sin respuestas ocultas tras acordeones, sin sopa de pronombres.
- Schema: Article más autor y fechas en todas partes; FAQPage solo donde existan preguntas reales; el marcado coincide con el contenido visible; un canónico.
- Entidad: un nombre, una categoría, una definición limpia, coherente en todas partes.
- Pruebas: autores identificados, fechas honestas, afirmaciones atribuibles, sin superlativos desnudos.
- Fuera de página: los perfiles y las fichas coinciden con tu sitio; el trabajo de autoridad alimenta ambas superficies.
- Medición: prompts relanzados por motor, tasa de citación y Share of Model monitorizadas, huecos frente a competidores priorizados, ciclo repetido.
Las etapas 1 a 6 hacen posible la citación. La etapa 7 la convierte en un programa.