Réponse rapide
AEO Goal assure le suivi des citations dans l’IA en exécutant un jeu de prompts stable et défini par le client sur les moteurs de réponse d’IA configurés, selon une cadence par prompt, en enregistrant chaque réponse avec ses URL sources, en détectant de façon déterministe les mentions de la marque et des concurrents, en filtrant les lignes de fournisseur d’espace réservé et synthétiques, et en vérifiant les URL citées en deux étapes avant qu’elles n’influencent les métriques visibles par le client. Les citations vérifiées comme fausses sont exclues du calcul du Share of Model.
Cette page existe pour qu’un analyste sceptique puisse auditer les chiffres. Elle décrit ce que le produit fait réellement, dans l’ordre où le pipeline le fait, y compris les parties qui limitent la précision. La page complémentaire, la méthodologie de suivi de la visibilité dans l’IA, couvre les métriques au niveau des mentions ; cette page couvre la couche des citations et des URL sources.

Ce qui compte comme donnée de citation
Une citation d’IA est un cas enregistré où un moteur de réponse fait apparaître une URL source, une mention de marque ou une mention de concurrent en réponse à un prompt suivi. Une réponse suivie produit une ligne, et chaque ligne stocke des champs délimités au locataire : le texte du prompt, l’étiquette de moteur et de modèle qui a produit la réponse, le contexte de marché sous lequel le prompt a été exécuté, le texte complet de la réponse, si la marque a été mentionnée et combien de fois, le sentiment, la position, les signaux de qualité et toute URL source que le moteur a exposée ou qui a pu être extraite de la réponse.
Deux distinctions comptent pour lire les données avec honnêteté :
- Mentionné n’est pas cité. Un moteur peut nommer la marque tout en construisant sa réponse à partir d’une page tierce, et il peut utiliser la page d’une marque comme preuve sans nommer la marque. Les lignes enregistrent les deux signaux séparément, de sorte que le produit de suivi des citations dans l’IA puisse les présenter côte à côte.
- Exposé n’est pas universel. Certains moteurs, comme Perplexity, exposent directement les liens de citations. D’autres fournissent un texte de réponse où l’influence des sources doit être lue à travers les URL et les schémas de mention. L’étiquette de moteur sur chaque ligne indique quel type de preuve vous observez.
Les lignes sont des données de mesure, pas une garantie qu’une plateforme tierce continuera de citer la même source. Les moteurs révisent constamment leurs réponses.
Comment le jeu de prompts est construit
Les métriques de citation n’ont de sens que dans la mesure du jeu de prompts qui les sous-tend, c’est pourquoi le jeu de prompts est contrôlé par le client et versionné par un historique d’édition ordinaire plutôt qu’échantillonné de façon opaque :
- Les prompts sont définis par marque. Chaque prompt suivi est une question de style acheteur rattachée à une marque précise, avec les noms et alias de la marque et ses concurrents nommés attachés à la même configuration de suivi. Les outils de recherche de prompts peuvent suggérer des prompts candidats à partir de la catégorie et du contenu de la marque, mais les suggestions ne deviennent des prompts suivis que lorsqu’un utilisateur les ajoute.
- Les prompts portent un contexte de marché. Un prompt peut s’exécuter avec un contexte de pays, de langue et de localité, et ces champs de marché sont conservés sur chaque ligne résultante, de sorte que les rapports de citation puissent être segmentés par paramètre régional. Les limites de plan contrôlent le nombre de marchés qu’un compte peut configurer.
- Les prompts sont stables entre les modifications. Le système réexécute le même texte de prompt à chaque cycle. Si une équipe modifie un prompt, les lignes suivantes reflètent le nouveau texte ; les lignes capturées avec l’ancien texte restent dans l’historique. Les analystes qui comparent des périodes devraient confirmer que le jeu de prompts n’a pas changé en milieu de fenêtre, car un jeu de prompts modifié est la cause non liée au moteur la plus fréquente d’un saut de métrique.
Exécution par moteur
AEO Goal inclut des adaptateurs de crawl pour ChatGPT, Claude, Perplexity, Gemini, Google AI Overview, Microsoft Copilot, Grok, Meta AI et DeepSeek. La couverture implémentée est plus large que la couverture active : une plateforme ne produit des lignes que lorsque ses identifiants de fournisseur sont configurés et que son chemin de crawl est activé. Lorsqu’une clé est absente ou qu’un fournisseur échoue, l’adaptateur renvoie une ligne de remplissage qui est écartée avant la persistance, de sorte que les fournisseurs indisponibles ne produisent aucune ligne plutôt que des lignes vides.
L’exécution est planifiée, pas en temps réel. Chaque prompt a sa propre fréquence de vérification configurée, avec des cadences prises en charge de l’heure au mois. À chaque cycle, chaque prompt dû s’exécute sur chaque moteur configuré, et les échecs sont isolés au niveau du prompt : un prompt en échec est réessayé lors d’un cycle ultérieur sans bloquer le reste de la file. C’est important pour l’audit, car cela signifie que le nombre de lignes par moteur peut légitimement différer dans une fenêtre lorsqu’un fournisseur a subi une panne ou qu’un prompt a été ajouté en milieu de fenêtre.
Comment les mentions et les citations sont détectées
La détection est déterministe et auditable par conception. Chaque réponse est comparée aux noms et alias de la marque et aux noms des concurrents configurés dans la configuration de suivi. Le détecteur enregistre si la marque est apparue, combien de mentions ont été trouvées, quels concurrents sont apparus et où la marque est apparue : la position dans la liste lorsque la réponse est structurée en liste, la position dans la phrase lorsqu’il s’agit de prose. La détection exige une correspondance littérale authentique dans le texte de la réponse ; une réponse qui se contente de reprendre le prompt ou qui indique que la marque est absente ne compte pas comme une mention favorable.
Ce n’est intentionnellement pas une résolution complète d’entités par TAL. Elle ne détectera pas une marque mal orthographiée ni un alias que personne n’a configuré, et elle le dit ici plutôt que de prétendre le contraire, car une règle déterministe qu’une équipe peut inspecter vaut mieux qu’une règle floue qu’elle ne peut pas inspecter. Fournir des alias complets dans la configuration de suivi est la moitié de la qualité de détection qui revient au client.
Filtrage des réponses d’espace réservé et synthétiques
Deux catégories de lignes sont tenues à l’écart du calcul visible par le client :
- Les lignes de remplissage provenant d’identifiants absents ou d’appels à des fournisseurs en échec, écartées avant la persistance.
- Les lignes synthétiques de repli, comme les replis synthétiques de Google AI Overview utilisés dans des chemins non productifs, exclues du Share of Model visible par le client et de l’agrégation des performances de citation.
L’objectif est l’honnêteté en cas d’échec : un fournisseur indisponible devrait réduire la taille de l’échantillon, pas fabriquer des zéros ni remplir la fenêtre de réponses vides.
Vérification des citations en deux étapes
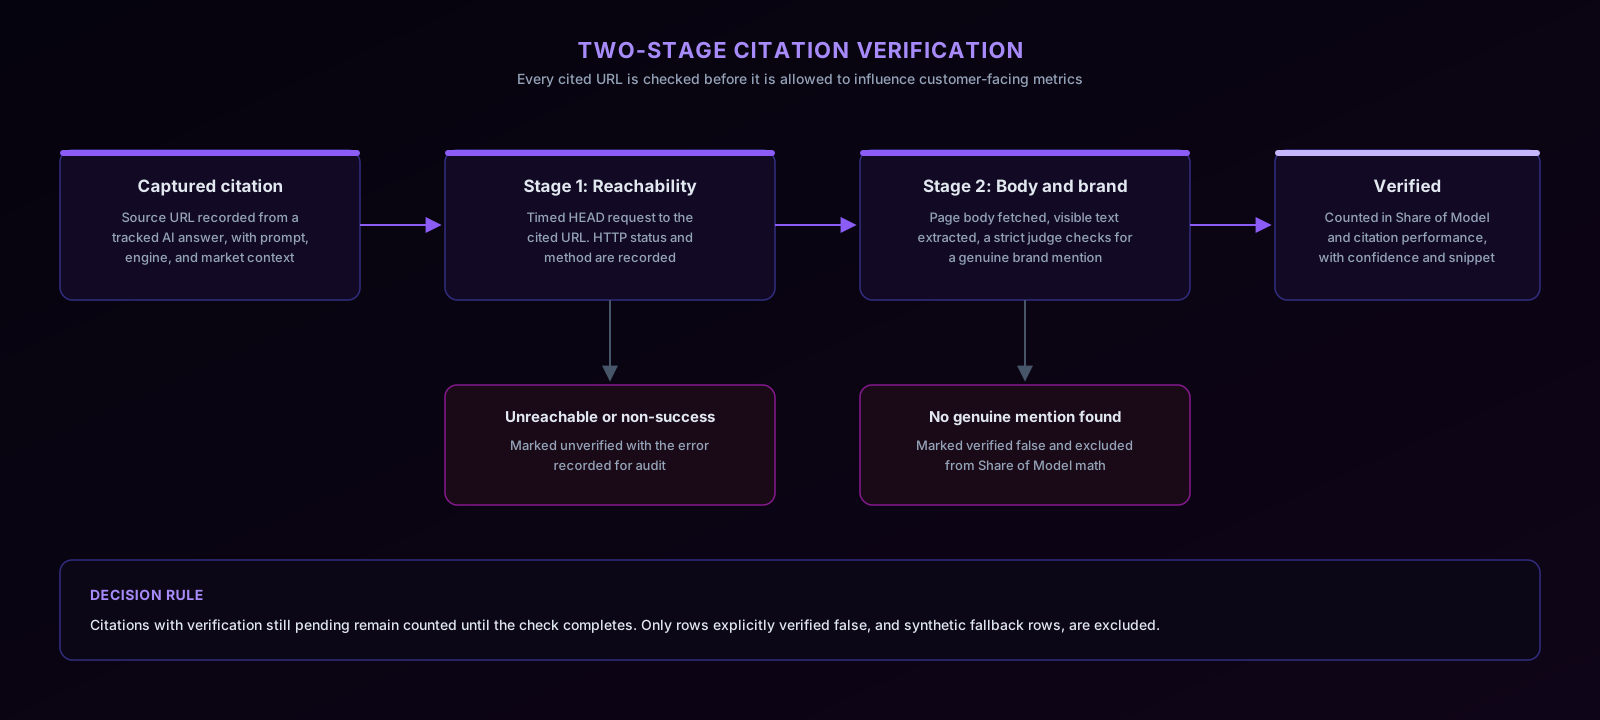
Les moteurs de réponse citent parfois des URL qui ne se résolvent pas ou des pages qui ne mentionnent jamais la marque. La vérification confirme qu’une URL citée est une preuve réelle avant qu’elle n’influence les métriques visibles par le client :
| Étape | Ce qui se passe | Résultat en cas d’échec |
|---|---|---|
| Accessibilité | Une requête HEAD avec délai vérifie l’URL citée. | Les URL sans succès ou inaccessibles sont marquées comme non vérifiées, avec l’erreur enregistrée. |
| Contrôle du corps et de la marque | Le corps de la page est récupéré, le texte visible est extrait, et un juge strict vérifie si la page mentionne réellement la marque. | Les lignes qui échouent sont marquées comme vérifiées fausses et exclues du calcul du Share of Model. |
Le vérificateur enregistre sa méthode, le statut HTTP, si la page mentionne la marque, un signal de confiance, un extrait à l’appui lorsqu’il est disponible, et un champ d’erreur lorsque la vérification échoue, de sorte que chaque verdict puisse être inspecté ultérieurement.
Règles d’inclusion du Share of Model
Le Share of Model visible par le client comptabilise les citations de la fenêtre de dates sélectionnée uniquement lorsque la ligne n’est pas un repli synthétique et n’est pas explicitement vérifiée fausse. Les lignes dont la vérification est encore en attente restent dans le calcul jusqu’à la fin du contrôle. Cette règle de décision est délibérée : ramener à zéro les citations récentes pendant que le vérificateur rattrape son retard sous-estimerait la visibilité réelle, alors que compter des citations confirmées fausses la surestimerait. La fenêtre d’attente est le compromis accepté, et c’est la raison pour laquelle un chiffre peut baisser légèrement après un scan, à mesure que se résolvent les vérifications tardives.
Signaux de qualité et de position
La qualité de la citation est un signal pondéré construit à partir du statut de la mention, du sentiment et de la position. Une marque mentionnée tôt et de façon positive contribue davantage qu’une mention tardive ou neutre, et les non-mentions contribuent pour zéro au Share of Model pondéré. La position est enregistrée de façon transparente comme rang dans la liste ou position dans la phrase, de sorte qu’une équipe puisse auditer exactement pourquoi un chiffre pondéré a bougé. Ces signaux alimentent le tableau de bord de suivi des citations dans l’IA et les comparaisons de visibilité dans l’IA des concurrents.
Rétention des données
La suppression du compte utilise une période de grâce de suppression réversible de 30 jours avant que la suppression définitive ne se propage en cascade aux données utilisateur associées. Cette page de méthodologie n’affirme pas que les lignes de prompts ou de réponses expirent automatiquement selon un TTL plus court ; la rétention au-delà du comportement de suppression est une affaire contractuelle, pas marketing. Les pratiques de sécurité et de traitement des données sont documentées sur la page de sécurité.
Versionnage de la méthode
La date lastUpdated sur cette page est le marqueur de version de la méthode. Lorsqu’une règle d’inclusion, une règle de détection ou une étape de vérification change d’une manière susceptible de modifier les chiffres visibles par le client, cette page est mise à jour pour décrire le nouveau comportement, et les équipes qui comparent de longues plages de temps devraient lire les règles actuelles au regard de la fenêtre qu’elles analysent. Les formules décrites ici sont calculées à partir des lignes stockées au moment de la lecture, de sorte que les changements de règle s’appliquent à la façon dont les lignes sont agrégées, et non en réécrivant l’historique.
Limites
Une page de méthodologie qui cache ses sources d’erreur n’est pas une page de méthodologie. Limites connues :
- Les moteurs de réponse ne sont pas déterministes. Le même prompt sur le même moteur peut produire des réponses différentes à quelques minutes d’intervalle. Les lignes individuelles sont des anecdotes ; les tendances sur un jeu de prompts stable sont le signal.
- L’échantillonnage est borné par le jeu de prompts. Les métriques décrivent les prompts suivis, pas l’ensemble des questions que posent les acheteurs. Un jeu de prompts qui passe à côté d’une question clé de l’acheteur passe aussi à côté de ses citations.
- La vérification dépend du web tiers. Une page peut changer ou disparaître après la capture de la réponse, le comportement HTTP varie, et l’extraction du texte visible est imparfaite sur les pages fortement scriptées.
- La couverture des alias est fournie par le client. La détection déterministe passe à côté des noms qui n’ont jamais été configurés.
- La couverture dépend de la configuration. Les identifiants de moteur, les chemins de crawl activés, les marchés et la cadence façonnent tous l’échantillon. Ne comparez des périodes que lorsque la configuration était stable.
- Une citation n’est pas toute l’histoire. Une source peut façonner le contexte de la catégorie sans nommer la marque, aussi les équipes devraient-elles lire ensemble les URL sources vérifiées et le cadrage plus large de la réponse.
Recommandation pour les entreprises
Traitez les données de citation comme un analyste traiterait toute mesure échantillonnée : utilisez des exécutions répétées sur un jeu de prompts stable, uniquement des citations vérifiées, des marchés documentés et la transparence sur les plateformes configurées avant de tirer des conclusions. Ne présentez pas une seule réponse d’IA ni une seule URL non vérifiée comme preuve pour les achats. Associez cette couche au benchmarking de la visibilité dans l’IA des concurrents pour voir comment les citations vérifiées se traduisent en Share of Model face aux rivaux, et lisez en quoi l’AEO diffère du SEO traditionnel au moment de présenter ces métriques à des interlocuteurs habitués aux classements.