Respuesta rápida
AEO Goal realiza el seguimiento de las citas de IA ejecutando un conjunto de prompts estable y definido por el cliente contra los motores de respuesta de IA configurados, con una cadencia por prompt, registrando cada respuesta con sus URL de origen, detectando de forma determinista las menciones de la marca y de la competencia, filtrando las filas de proveedores marcadoras de posición y sintéticas, y verificando las URL citadas en dos fases antes de que influyan en las métricas visibles para el cliente. Las citas verificadas como falsas se excluyen del cálculo de Share of Model.
Esta página existe para que un analista escéptico pueda auditar las cifras. Describe lo que el producto realmente hace, en el mismo orden en que lo hace el pipeline, incluidas las partes que limitan la precisión. La página complementaria, la metodología de seguimiento de visibilidad de IA, cubre las métricas a nivel de mención; esta página cubre la capa de citas y URL de origen.

Qué cuenta como datos de citas
Una cita de IA es un caso registrado en el que un motor de respuesta muestra una URL de origen, una mención de marca o una mención de la competencia en respuesta a un prompt seguido. Una respuesta seguida produce una fila, y cada fila almacena campos delimitados al inquilino: el texto del prompt, la etiqueta de motor y modelo que produjo la respuesta, el contexto de mercado bajo el que se ejecutó el prompt, el texto completo de la respuesta, si la marca fue mencionada y cuántas veces, el sentimiento, la posición, las señales de calidad y cualquier URL de origen que el motor expusiera o que pudiera extraerse de la respuesta.
Dos distinciones importan para leer los datos con honestidad:
- Mencionado no es citado. Un motor puede nombrar la marca mientras construye su respuesta a partir de una página de terceros, y puede usar la página de una marca como evidencia sin nombrar la marca. Las filas registran ambas señales por separado, de modo que el producto de seguimiento de citas de IA pueda informarlas una junto a la otra.
- Expuesto no es universal. Algunos motores, como Perplexity, exponen los enlaces de citas directamente. Otros ofrecen texto de respuesta donde la influencia de las fuentes debe leerse a través de las URL y los patrones de mención. La etiqueta de motor en cada fila indica qué tipo de evidencia estás observando.
Las filas son datos de medición, no una garantía de que una plataforma de terceros vaya a seguir citando la misma fuente. Los motores revisan sus respuestas constantemente.
Cómo se construye el conjunto de prompts
Las métricas de citas solo son tan significativas como el conjunto de prompts que las sustenta, por lo que el conjunto de prompts está controlado por el cliente y versionado mediante un historial de edición normal, en lugar de muestrearse de forma opaca:
- Los prompts se definen por marca. Cada prompt seguido es una pregunta de estilo comprador vinculada a una marca concreta, con los nombres y alias de la marca y sus competidores nombrados adjuntos a la misma configuración de seguimiento. Las herramientas de investigación de prompts pueden sugerir prompts candidatos a partir de la categoría y el contenido de la marca, pero las sugerencias solo se convierten en prompts seguidos cuando un usuario las añade.
- Los prompts llevan contexto de mercado. Un prompt puede ejecutarse con contexto de país, idioma y localidad, y esos campos de mercado se conservan en cada fila resultante, de modo que los informes de citas puedan segmentarse por configuración regional. Los límites de plan controlan cuántos mercados puede configurar una cuenta.
- Los prompts son estables entre ediciones. El sistema vuelve a ejecutar el mismo texto de prompt en cada ciclo. Si un equipo edita un prompt, las filas posteriores reflejan el nuevo texto; las filas capturadas con el texto anterior permanecen en el historial. Los analistas que comparan periodos deberían confirmar que el conjunto de prompts no cambió a mitad de la ventana, porque un conjunto de prompts modificado es la causa no vinculada al motor más común de un salto en una métrica.
Ejecución por motor
AEO Goal incluye adaptadores de rastreo para ChatGPT, Claude, Perplexity, Gemini, Google AI Overview, Microsoft Copilot, Grok, Meta AI y DeepSeek. La cobertura implementada es más amplia que la cobertura activa: una plataforma solo produce filas cuando sus credenciales de proveedor están configuradas y su ruta de rastreo está habilitada. Cuando falta una clave o un proveedor falla, el adaptador devuelve una fila de relleno que se descarta antes de la persistencia, de modo que los proveedores no disponibles no producen filas en lugar de producir filas vacías.
La ejecución es programada, no en tiempo real. Cada prompt tiene su propia frecuencia de comprobación configurada, con cadencias admitidas desde cada hora hasta cada mes. En cada ciclo, cada prompt pendiente se ejecuta contra cada motor configurado, y los fallos se aíslan a nivel de prompt: un prompt fallido se reintenta en un ciclo posterior sin bloquear el resto de la cola. Esto importa para la auditoría porque significa que el recuento de filas por motor puede diferir legítimamente dentro de una ventana cuando un proveedor tuvo una interrupción o cuando se añadió un prompt a mitad de la ventana.
Cómo se detectan las menciones y las citas
La detección es determinista y auditable por diseño. Cada respuesta se compara con los nombres y alias de la marca y con los nombres de la competencia configurados en la configuración de seguimiento. El detector registra si la marca apareció, cuántas menciones se encontraron, qué competidores aparecieron y dónde apareció la marca: la posición en la lista cuando la respuesta está estructurada como lista, y la posición en la frase cuando es prosa. La detección requiere una coincidencia literal genuina en el texto de la respuesta; una respuesta que se limita a repetir el prompt o que afirma que la marca está ausente no cuenta como una mención favorable.
Esto no es, de forma intencionada, una resolución completa de entidades mediante PLN. No detectará una marca mal escrita ni un alias que nadie configuró, y lo dice aquí en lugar de fingir lo contrario, porque una regla determinista que un equipo puede inspeccionar es mejor que una difusa que no puede. Aportar alias completos en la configuración de seguimiento es la mitad de la calidad de la detección que corresponde al cliente.
Filtrado de respuestas marcadoras de posición y sintéticas
Dos clases de filas se mantienen fuera del cálculo visible para el cliente:
- Filas de relleno procedentes de credenciales ausentes o de llamadas a proveedores fallidas, descartadas antes de la persistencia.
- Filas sintéticas de reserva, como las reservas sintéticas de Google AI Overview utilizadas en rutas no productivas, excluidas del Share of Model visible para el cliente y de la agregación del rendimiento de citas.
El propósito es la honestidad ante los fallos: un proveedor no disponible debería reducir el tamaño de la muestra, no fabricar ceros ni rellenar la ventana con respuestas vacías.
Verificación de citas en dos fases
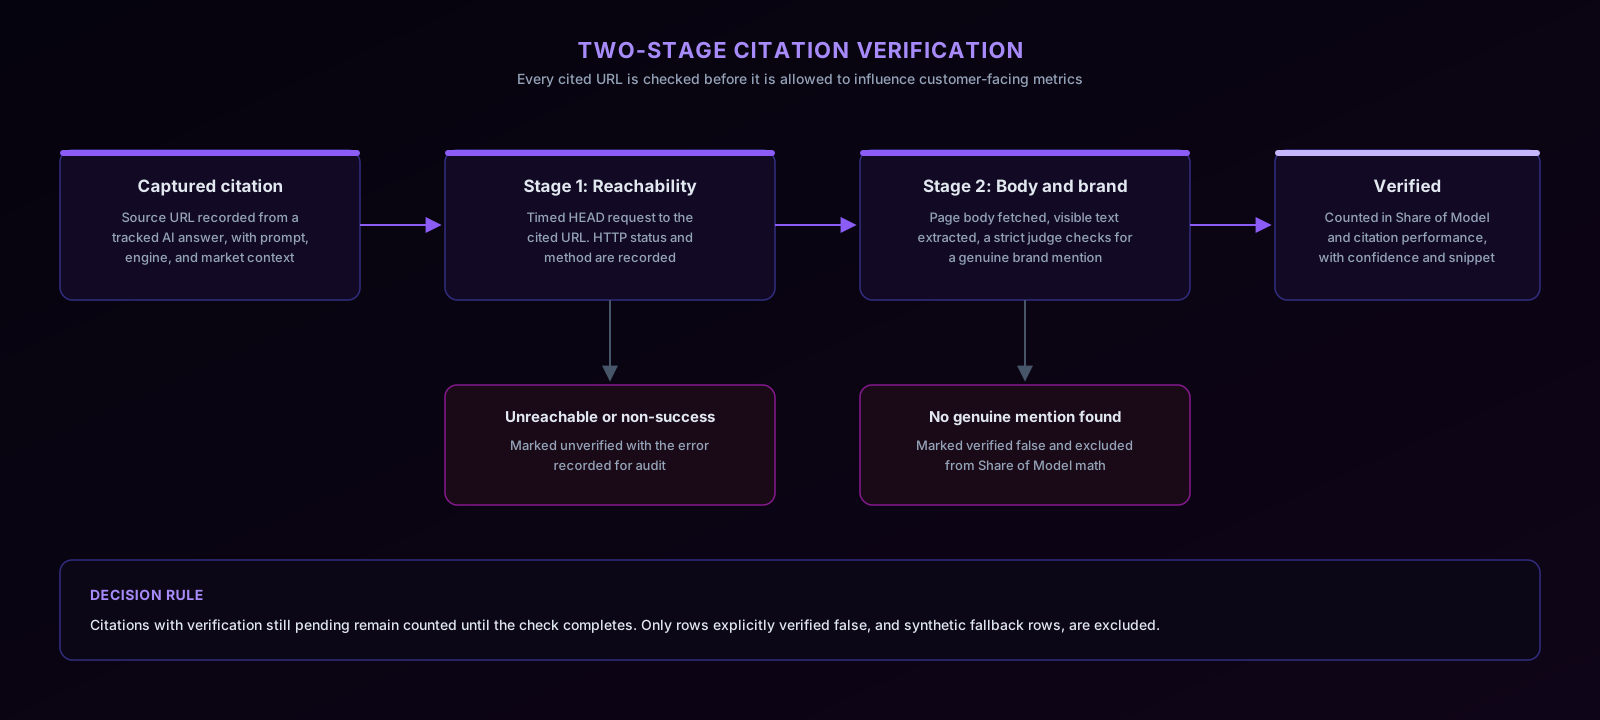
Los motores de respuesta a veces citan URL que no resuelven o páginas que nunca mencionan la marca. La verificación confirma que una URL citada es evidencia real antes de que influya en las métricas visibles para el cliente:
| Fase | Qué ocurre | Resultado del fallo |
|---|---|---|
| Accesibilidad | Una petición HEAD con límite de tiempo comprueba la URL citada. | Las URL sin éxito o inaccesibles se marcan como no verificadas, y se registra el error. |
| Comprobación de cuerpo y marca | Se descarga el cuerpo de la página, se extrae el texto visible y un juez estricto comprueba si la página menciona realmente la marca. | Las filas que fallan se marcan como verificadas falsas y se excluyen del cálculo de Share of Model. |
El verificador registra su método, el estado HTTP, si la página menciona la marca, una señal de confianza, un fragmento de apoyo cuando está disponible y un campo de error cuando la verificación falla, de modo que cada veredicto pueda inspeccionarse más tarde.
Reglas de inclusión de Share of Model
El Share of Model visible para el cliente cuenta las citas de la ventana de fechas seleccionada solo cuando la fila no es una reserva sintética y no está marcada explícitamente como verificada falsa. Las filas con la verificación aún pendiente permanecen en el cálculo hasta que finaliza la comprobación. Esa regla de decisión es deliberada: reducir a cero las citas recientes mientras el verificador se pone al día subestimaría la visibilidad real, mientras que contar citas confirmadas como falsas la sobreestimaría. La ventana de pendientes es el equilibrio aceptado, y es la razón por la que una cifra puede bajar ligeramente tras un escaneo, a medida que se resuelven las verificaciones tardías.
Señales de calidad y posición
La calidad de la cita es una señal ponderada construida a partir del estado de la mención, el sentimiento y la posición. Una marca mencionada pronto y de forma positiva aporta más que una mención tardía o neutra, y las no menciones aportan cero al Share of Model ponderado. La posición se registra de forma transparente como rango en la lista o posición en la frase, de modo que un equipo pueda auditar exactamente por qué se movió una cifra ponderada. Estas señales alimentan el panel de seguimiento de citas de IA y las comparativas de visibilidad de IA de la competencia.
Retención de datos
La eliminación de la cuenta utiliza un periodo de gracia de eliminación reversible de 30 días antes de que la eliminación definitiva se propague en cascada por los datos de usuario asociados. Esta página de metodología no afirma que las filas de prompts o respuestas caduquen automáticamente con un TTL más corto; la retención más allá del comportamiento de eliminación es un asunto contractual, no de marketing. Las prácticas de seguridad y tratamiento de datos están documentadas en la página de seguridad.
Versionado del método
La fecha lastUpdated de esta página es el marcador de versión del método. Cuando una regla de inclusión, una regla de detección o una fase de verificación cambian de un modo que podría mover las cifras visibles para el cliente, esta página se actualiza para describir el nuevo comportamiento, y los equipos que comparan rangos de tiempo largos deberían leer las reglas actuales frente a la ventana que están analizando. Las fórmulas descritas aquí se calculan a partir de las filas almacenadas en el momento de la lectura, por lo que los cambios de regla se aplican a cómo se agregan las filas, no reescribiendo el historial.
Limitaciones
Una página de metodología que oculta sus fuentes de error no es una página de metodología. Límites conocidos:
- Los motores de respuesta no son deterministas. El mismo prompt en el mismo motor puede producir respuestas distintas con minutos de diferencia. Las filas individuales son anécdotas; las tendencias sobre un conjunto de prompts estable son la señal.
- El muestreo está limitado por el conjunto de prompts. Las métricas describen los prompts seguidos, no el espacio completo de preguntas que hacen los compradores. Un conjunto de prompts que pasa por alto una pregunta clave del comprador también pasa por alto sus citas.
- La verificación depende de la web de terceros. Una página puede cambiar o desaparecer después de que se capturara la respuesta, el comportamiento HTTP varía y la extracción de texto visible es imperfecta en páginas con mucho scripting.
- La cobertura de alias la aporta el cliente. La detección determinista pasa por alto los nombres que nunca se configuraron.
- La cobertura depende de la configuración. Las credenciales de motor, las rutas de rastreo habilitadas, los mercados y la cadencia dan forma a la muestra. Compara periodos solo cuando la configuración fue estable.
- Una cita no es toda la historia. Una fuente puede dar forma al contexto de la categoría sin nombrar la marca, así que los equipos deberían leer conjuntamente las URL de origen verificadas y el encuadre más amplio de la respuesta.
Recomendación empresarial
Trata los datos de citas como un analista trataría cualquier medición muestreada: usa ejecuciones repetidas sobre un conjunto de prompts estable, solo citas verificadas, mercados documentados y transparencia sobre las plataformas configuradas antes de sacar conclusiones. No presentes una única respuesta de IA ni una sola URL sin verificar como prueba para compras. Combina esta capa con la comparativa de visibilidad de IA de la competencia para ver cómo se traducen las citas verificadas en Share of Model frente a los rivales, y lee en qué se diferencia AEO del SEO tradicional cuando presentes estas métricas a interlocutores acostumbrados a los rankings.