Le module où le programme devient responsable
Tout ce qui précède ce point a produit des changements : faits canoniques, correctifs de robots, pages restructurées, schema. Ce module est là où vous prouvez que quoi que ce soit a fonctionné, à vous-même et à quiconque paie le travail. Il existe parce que la visibilité dans l’IA a un problème de culture de mesure : des captures d’écran d’une réponse ChatGPT chanceuse présentées comme preuve, des métriques que personne n’a définies, et des rapports qui ne peuvent pas répondre à la seule question qu’un décideur a : gagnons-nous ou perdons-nous, et que faisons-nous ensuite ?
Définissez les métriques avant de les rapporter
Cinq métriques, définies précisément, car confondre les deux premières est l’erreur de reporting la plus courante du domaine :
| Métrique | Définition | La question à laquelle elle répond |
|---|---|---|
| Taux de mentions | Part des réponses échantillonnées pour un ensemble de prompts où la marque est nommée, tout court. | Les moteurs savent-ils que nous appartenons à cette conversation ? |
| Taux de citations | Part des réponses échantillonnées où une URL détenue apparaît comme source. | Sommes-nous une preuve, ou juste du vocabulaire ? |
| Share of Model | Les mentions de la marque en part de toutes les mentions de marques suivies sur un ensemble de prompts de catégorie, par moteur et agrégé. | De l’espace de recommandation de notre catégorie, quelle part est la nôtre par rapport à chaque concurrent ? |
| Recouvrement avec les concurrents | Quelles marques coapparaissent dans les mêmes réponses, et qui apparaît quand vous n’apparaissez pas. | Qui gagne les prompts que nous perdons, pour que les écarts deviennent des cibles. |
| Sentiment et cadrage | Comment la marque est décrite quand elle apparaît : recommandée, listée neutrement, ou nuancée. | Notre présence est-elle un atout, et l’histoire que les moteurs racontent sur nous est-elle exacte ? |
Mentionné-mais-jamais-cité et cité-mais-mal-cadré sont des maladies différentes aux remèdes différents, c’est pourquoi un unique « score de visibilité » cache plus qu’il ne révèle.
Discipline d’échantillonnage : la partie que tout le monde saute
Les réponses d’IA sont non déterministes. Le même prompt, sur le même moteur, le même jour, peut nommer des marques différentes, et les moteurs révisent leur comportement en continu. Cela a trois conséquences opérationnelles :
- Ne concluez jamais à partir d’une réponse. Une seule réponse est une anecdote. Les métriques viennent d’un échantillonnage répété d’un ensemble de prompts fixe dans le temps ; la méthodologie de visibilité dans l’IA documente comment cela fonctionne en pratique, et le même principe s’applique à la vérification manuelle.
- Les tendances l’emportent sur les niveaux. Un taux de citations signifie peu isolément ; un taux de citations passant de rare à courant au fil des semaines, l’ensemble de prompts restant fixe, est une preuve.
- Gardez le panel constant. Changer les prompts en cours de route détruit la comparabilité, de la même façon qu’échanger vos mots-clés suivis en milieu de trimestre le ferait. Versionnez l’ensemble de prompts : les ajouts démarrent leur propre base de référence.
La séparation par moteur compte pour la même raison : ChatGPT, Claude, Gemini et Perplexity récupèrent différemment et citent différemment, et un correctif qui fait bouger l’un peut ne pas faire bouger l’autre. Rapportez les moteurs côte à côte, pas fondus en une bouillie moyenne.
L’échelle de diagnostic
La mesure n’est utile que si chaque lecture dicte une action. Le cadre central du module associe chaque réponse échantillonnée à l’un de quatre états, chacun avec une cause racine et un correctif distincts, en s’appuyant sur tout ce que les modules précédents ont construit :
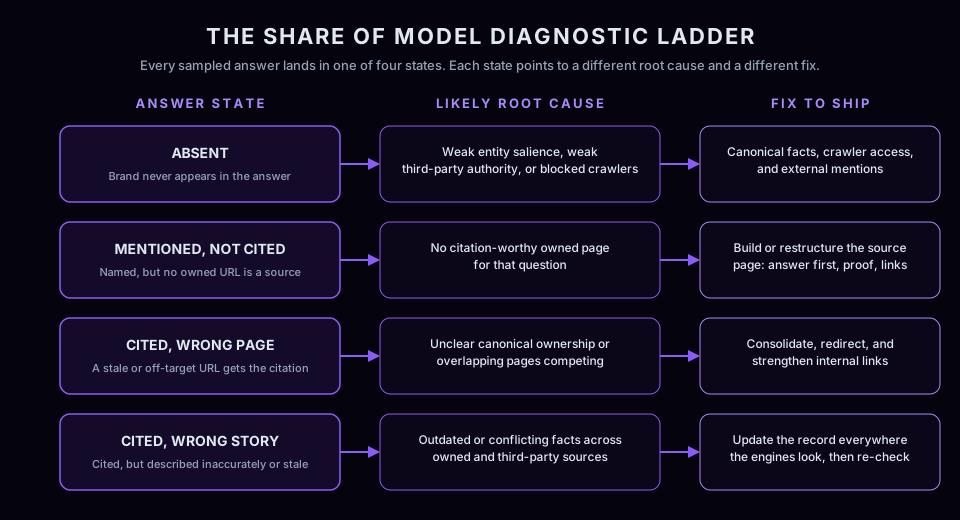
- Absent. Les moteurs ne vous placent pas dans la conversation. La cause racine est en amont : prominence des entités, accès des robots, ou autorité de tiers. Corriger le contenu d’une page que les moteurs ne récupèrent jamais, ou récupérer une marque qu’ils ne peuvent pas définir, ne fait rien.
- Mentionné, non cité. Les moteurs vous connaissent mais citent quelqu’un d’autre. C’est un problème de page source : aucune page détenue ne passe la barre d’extractibilité pour cette question. Le module des contenus dignes de citations est le correctif.
- Cité, mauvaise page. Un article de blog périmé surpasse votre page canonique. Problème de propriété : consolidez, redirigez et pointez les liens internes vers le propriétaire voulu.
- Cité, mauvaise histoire. Vous êtes présent mais décrit de façon inexacte ou périmée. Problème de narration : mettez à jour les faits partout où les moteurs regardent, détenu et tiers, puis rééchantillonnez.
L’échelle est aussi un outil de priorisation : un prompt à forte valeur en « mentionné, non cité » est généralement moins cher à gagner qu’un en « absent », car le travail d’entité est déjà fait.
Le rapport sur lequel un décideur peut agir
Le standard de reporting que ce module certifie : ensemble de prompts et échantillonnage énoncés dès le départ ; taux de mentions par moteur, taux de citations avec les URL de sources réelles, et Share of Model avec tendance ; recouvrement avec les concurrents nommant qui gagne les prompts que vous perdez ; un état de diagnostic et une prochaine action par prompt prioritaire ; et une section honnête sur les limites. Le paragraphe sur les limites n’est pas de la décoration : vous avez échantillonné un panel de prompts, vous n’avez pas observé la conversation privée de chaque utilisateur, et les moteurs peuvent changer de comportement sans préavis. L’énoncer bâtit la crédibilité qui rend le reste du rapport crédible. C’est la même structure que le suivi de la visibilité dans l’IA et l’analytique du Share of Model automatisent à travers les moteurs ; exécuté manuellement, c’est une feuille de calcul et un rituel mensuel, et la certification traite les deux comme des implémentations valables d’un seul standard.
Exemple travaillé
Une équipe livre une réécriture visant cinq prompts. Quatre semaines d’échantillonnage plus tard : taux de citations en hausse sur Perplexity et Gemini, plat sur ChatGPT ; taux de mentions inchangé partout. Lecture : la nouvelle page gagne la récupération là où la récupération est en direct et agressive, tandis que la force d’entité sous-jacente de la marque n’a pas bougé, et ChatGPT s’appuie sur des connaissances plus anciennes. La prochaine action vient directement de l’échelle : le travail de page est fait ; l’écart restant est du travail d’autorité et de cohérence, qui est exactement là où le module suivant reprend.
Ce qui se débloque après le paiement
Le module payant comprend le modèle de tableau de bord de reporting mettant en œuvre le standard ci-dessus, la feuille de travail de suivi de prompts pour l’échantillonnage manuel avec des panels de prompts versionnés, et le SOP de reporting du Share of Model pour produire le rapport mensuel selon une cadence fixe.
Devoir
Construisez un tableau de reporting à cinq prompts pour une marque : prompt, moteur, état de mention, URL citées, état de diagnostic de l’échelle, et prochaine action. Échantillonnez chaque prompt plus d’une fois avant d’écrire quoi que ce soit, et remarquez à quel point l’échantillonnage répété a changé votre première impression.
Précédent et suivant
Précédent : Flux de travail SEO assistés par IA avec QA humaine. Suivant : Autorité de tiers et relations presse numériques.