El módulo en el que el programa se vuelve medible
Todo lo anterior produjo cambios: hechos canónicos, correcciones para los rastreadores, páginas reestructuradas, schema. Este módulo es donde demuestras que algo de eso funcionó, ante ti mismo y ante quien paga por el trabajo. Existe porque la visibilidad en IA tiene un problema de cultura de medición: capturas de una respuesta afortunada de ChatGPT presentadas como evidencia, métricas que nadie definió e informes que no pueden responder a la única pregunta que le importa a un responsable: ¿estamos ganando o perdiendo, y qué hacemos a continuación?
Define las métricas antes de informar sobre ellas
Cinco métricas, definidas con precisión, porque confundir las dos primeras es el error de reporte más habitual del sector:
| Métrica | Definición | La pregunta que responde |
|---|---|---|
| Tasa de menciones | Proporción de respuestas muestreadas para un conjunto de prompts en las que se nombra a la marca de alguna forma. | ¿Saben los motores que pertenecemos a esta conversación? |
| Tasa de citas | Proporción de respuestas muestreadas en las que una URL propia aparece como fuente. | ¿Somos evidencia o solo vocabulario? |
| Share of Model | Las menciones de la marca como proporción de todas las menciones de marcas rastreadas en un conjunto de prompts de categoría, por motor y de forma combinada. | Del espacio de recomendación de nuestra categoría, ¿cuánto es nuestro frente al de cada competidor? |
| Solapamiento con competidores | Qué marcas coinciden en las mismas respuestas y quién aparece cuando tú no. | Quién gana los prompts que perdemos, para que los huecos se conviertan en objetivos. |
| Sentimiento y encuadre | Cómo se describe a la marca cuando aparece: recomendada, listada de forma neutra o con matices. | ¿Nuestra presencia es un activo y es acertada la historia que los motores cuentan sobre nosotros? |
Mencionada pero nunca citada y citada pero mal encuadrada son enfermedades distintas con curas distintas, y por eso una única “puntuación de visibilidad” oculta más de lo que revela.
Disciplina de muestreo: la parte que todo el mundo se salta
Las respuestas de IA no son deterministas. El mismo prompt, en el mismo motor, el mismo día, puede nombrar marcas diferentes, y los motores revisan su comportamiento de forma continua. Esto tiene tres consecuencias operativas:
- Nunca concluyas a partir de una sola respuesta. Una única respuesta es una anécdota. Las métricas provienen del muestreo repetido de un conjunto fijo de prompts a lo largo del tiempo; la metodología de seguimiento de visibilidad en IA documenta cómo funciona esto en la práctica, y el mismo principio se aplica a la comprobación manual.
- Las tendencias importan más que los niveles. Una tasa de citas significa poco de forma aislada; una tasa de citas que pasa de rara a frecuente a lo largo de las semanas, mientras el conjunto de prompts se mantuvo fijo, es evidencia.
- Mantén el panel constante. Cambiar los prompts a mitad de camino destruye la comparabilidad, igual que intercambiar tus keywords rastreadas a mitad de trimestre. Versiona el conjunto de prompts: las incorporaciones inician su propia línea base.
La separación por motor importa por la misma razón: ChatGPT, Claude, Gemini y Perplexity recuperan y citan de forma distinta, y una solución que mueve a uno puede no mover a otro. Informa de los motores uno junto a otro, no promediados hasta convertirlos en una masa indistinta.
La escalera diagnóstica
La medición solo es útil si cada lectura dicta una acción. El marco central del módulo asocia cada respuesta muestreada a uno de cuatro estados, cada uno con una causa raíz y una solución distintas, apoyándose en todo lo que construyeron los módulos anteriores:
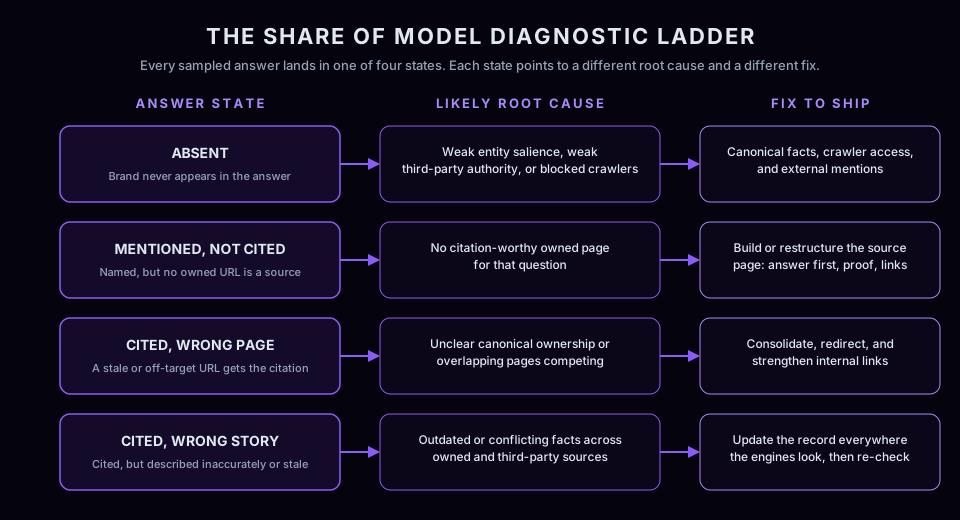
- Ausente. Los motores no te sitúan en la conversación. La causa raíz está aguas arriba: relevancia de entidad, acceso de los rastreadores o autoridad de terceros. Arreglar el contenido de una página que los motores nunca rastrean, o rastrear una marca que no pueden definir, no sirve de nada.
- Mencionada, no citada. Los motores te conocen pero citan a otro. Es un problema de página fuente: ninguna página propia supera el listón de extractabilidad para esa pregunta. El módulo de activos dignos de cita es la solución.
- Citada, página equivocada. Una entrada de blog obsoleta supera a tu página canónica. Problema de propiedad: consolida, redirige y apunta los enlaces internos hacia el propietario previsto.
- Citada, historia equivocada. Estás presente pero se te describe de forma inexacta u obsoleta. Problema de narrativa: actualiza los hechos en todos los lugares donde miran los motores, propios y de terceros, y vuelve a muestrear.
La escalera es también una herramienta de priorización: un prompt de alto valor en “mencionada, no citada” suele ser más barato de ganar que uno en “ausente”, porque el trabajo de entidad ya está hecho.
El informe sobre el que un responsable puede actuar
El estándar de reporte que este módulo certifica: conjunto de prompts y muestreo declarados desde el principio; tasa de menciones por motor, tasa de citas con las source URLs reales y Share of Model con su tendencia; solapamiento con competidores nombrando a quién gana los prompts que pierdes; un estado diagnóstico y una acción siguiente por cada prompt prioritario; y una sección honesta de límites. El párrafo de límites no es decoración: muestreaste un panel de prompts, no observaste la conversación privada de cada usuario y los motores pueden cambiar de comportamiento sin previo aviso. Declararlo genera la credibilidad que hace creíble el resto del informe. Esta es la misma estructura que AI visibility tracking y Share of Model analytics automatizan en todos los motores; hecha a mano, es una hoja de cálculo y un ritual mensual, y la certificación trata ambas como implementaciones válidas de un mismo estándar.
Ejemplo práctico
Un equipo publica una reescritura dirigida a cinco prompts. Cuatro semanas de muestreo después: la tasa de citas sube en Perplexity y Gemini, se mantiene plana en ChatGPT; la tasa de menciones no cambia en ningún sitio. Lectura: la nueva página está ganando la recuperación allí donde la recuperación es activa y agresiva, mientras que la fuerza de entidad subyacente de la marca no se ha movido, y ChatGPT se apoya en conocimiento más antiguo. La acción siguiente sale directamente de la escalera: el trabajo de página está hecho; el hueco que queda es trabajo de autoridad y consistencia, que es justo donde retoma el siguiente módulo.
Qué se desbloquea tras la compra
El módulo de pago incluye la plantilla de panel de informes que implementa el estándar anterior, la hoja de trabajo de seguimiento de prompts para el muestreo manual con paneles de prompts versionados y el procedimiento (SOP) de informes de Share of Model para producir el informe mensual con una cadencia fija.
Ejercicio
Construye una tabla de reporte de cinco prompts para una marca: prompt, motor, estado de mención, URLs citadas, estado diagnóstico según la escalera y acción siguiente. Muestrea cada prompt más de una vez antes de anotar nada y fíjate en cuánto cambió el muestreo repetido tu primera impresión.
Anterior y siguiente
Anterior: Flujos de trabajo de SEO asistido por IA con control de calidad humano. Siguiente: Autoridad de terceros y PR digital.