Pourquoi les programmes de croissance ont besoin d’une boucle, pas d’un audit
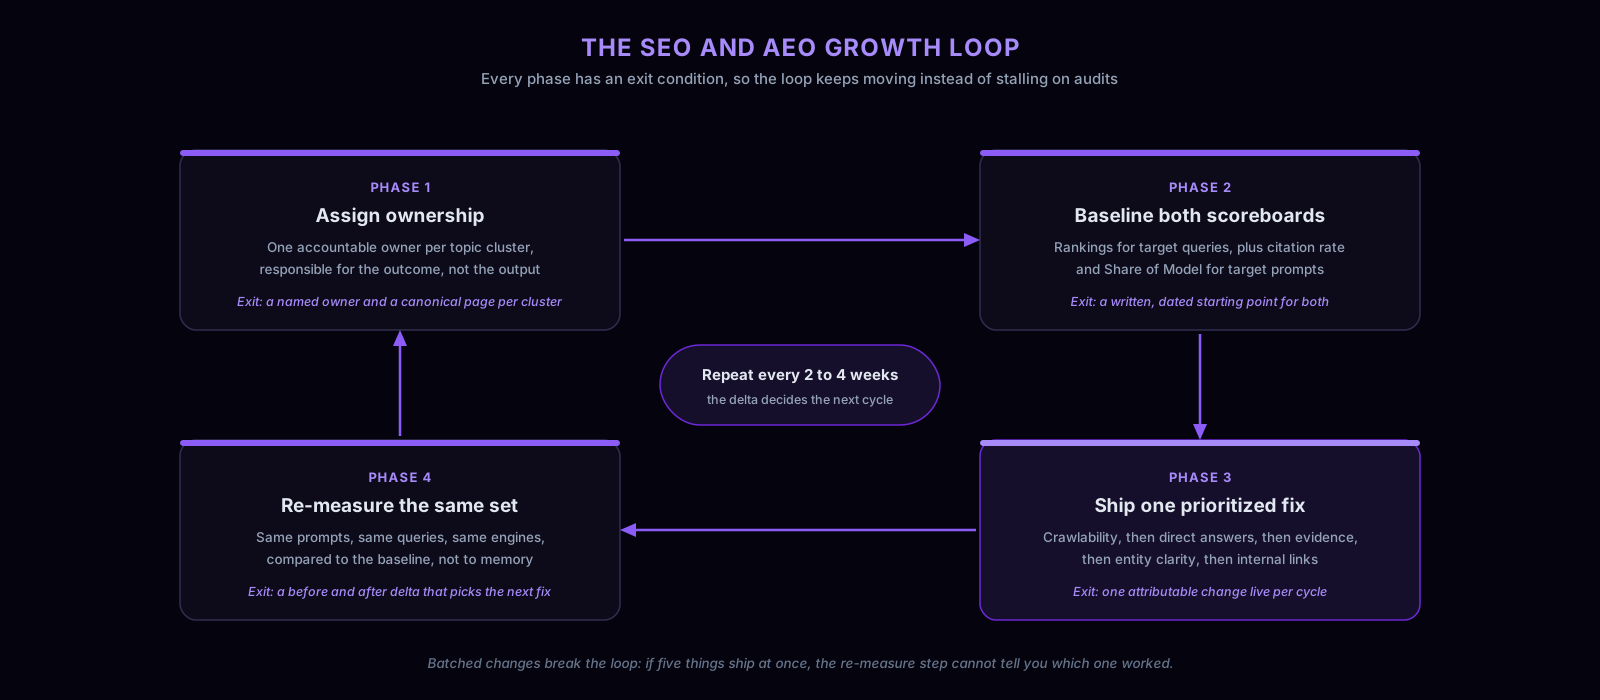
La plupart des programmes SEO meurent d’une de deux façons : en tant que gigantesque audit qui produit deux cents constats et aucun changement livré, ou en tant que tapis roulant de contenu qui publie chaque semaine et ne vérifie jamais si quoi que ce soit a bougé. Le cadre de cette page est conçu pour prévenir les deux. C’est une boucle à quatre phases, chacune avec une condition de sortie explicite, et son unité de progrès n’est ni « pages publiées » ni « problèmes trouvés » mais des deltas vérifiés : des changements qui ont été livrés, remesurés, et confirmés comme ayant fait bouger un chiffre ou non.
La deuxième chose qui le rend actuel plutôt qu’un playbook de 2019 : il suit deux tableaux de bord. Les positions en liens bleus comptent toujours car Google porte encore la majeure partie du volume de recherche. Mais une part croissante de la recherche d’achat se termine désormais à l’intérieur d’une réponse générée par ChatGPT, Gemini, Perplexity, Claude ou les AI Overviews de Google, et ces réponses nomment une poignée de sources au lieu d’en lister dix. Une page peut se positionner en première page et ne jamais être citée ; une page peut être citée quotidiennement tout en se positionnant en troisième page. Les deux signaux répondent à des leviers qui se recoupent mais diffèrent, donc un cadre qui ne mesure qu’un seul navigue à moitié aveugle. Si cette distinction est un territoire nouveau, lisez d’abord comment l’AEO diffère du SEO traditionnel.
| Phase | Question à laquelle elle répond | Condition de sortie |
|---|---|---|
| 1. Propriété | Qui est responsable du résultat de ce sujet ? | Un propriétaire nommé et une page canonique par grappe |
| 2. Base de référence | Où en sommes-nous aujourd’hui, sur les deux tableaux de bord ? | Un point de départ écrit et daté pour les positions et les citations |
| 3. Livraison | Quel changement unique fait le plus probablement bouger le chiffre ? | Un correctif attribuable en ligne par grappe par cycle |
| 4. Remesure | A-t-il fonctionné ? | Un delta avant-après qui choisit le prochain correctif |
Phase 1 : attribuer la propriété avant de toucher au contenu
Attribuez un propriétaire responsable par grappe thématique avant que toute rédaction ou correction ne commence, car la propriété diffuse est la raison la plus courante pour laquelle ces programmes calent. Quand « l’équipe » possède la visibilité dans l’IA, personne ne remarque qu’un concurrent a pris le contrôle des prompts de comparaison de la catégorie en mars. Quand une personne possède la grappe « définition de catégorie », cette prise de contrôle est son problème du mardi.
La propriété signifie ici posséder le résultat, pas la liste de tâches : les citations et les positions de cette grappe sont les chiffres du propriétaire. Concrètement, le propriétaire décide trois choses :
- La page canonique. Quelle URL unique est censée gagner ce sujet. Si la réponse est « trois articles de blog le couvrent plus ou moins », le premier correctif est la consolidation, et le propriétaire prend cette décision.
- L’ensemble de questions. Quelles requêtes et prompts la grappe doit répondre, de la question principale jusqu’aux suivis qu’un acheteur pose ensuite.
- La structure de support. Quelles pages lient vers la page canonique et avec quelles ancres, pour que l’autorité se concentre au lieu de se disperser.
Les frontières des grappes devraient suivre l’intention, pas les organigrammes : « définition de catégorie », « comparaison avec les alternatives », « guide pratique et implémentation », « tarif et évaluation » est une répartition typique pour un produit B2B. Trois à cinq grappes suffisent amplement pour commencer ; un programme qui attribue des propriétaires à vingt grappes le premier jour n’a attribué personne à rien.
Phase 2 : établir la base de référence des deux tableaux de bord avant de livrer quoi que ce soit
Établissez un point de départ mesuré et daté pour les positions et les citations en IA avant qu’un changement ne soit livré, car sans base de référence la phase de remesure produit des opinions au lieu de deltas. Cette phase est encadrée dans le temps : une à deux semaines, pas un trimestre. La base de référence n’a pas besoin d’être complète ; elle doit être reproductible, car vous relancerez exactement cette mesure en phase 4.
Capturez, par grappe, au minimum :
- L’ensemble de questions. Les requêtes et les cinq à quinze prompts conversationnels qui comptent, notés mot pour mot pour que la remesure utilise des entrées identiques.
- Le statut de citation par prompt, par moteur. Si votre marque apparaît dans la réponse générée, si votre URL est citée, à quelle position et avec quel sentiment. Une définition précise de ce qui compte se trouve dans ce qu’est une citation en IA.
- Qui gagne à la place. Les concurrents nommés et les URL citées quand vous êtes absent. Ce sont vos cibles et votre matériel de rétro-ingénierie.
- Les positions traditionnelles. La position pour les requêtes équivalentes, pour que le mouvement de positions et le mouvement de citations puissent être comparés plus tard.
- La préparation technique. Si les robots d’IA peuvent même atteindre la page canonique : règles robots.txt, rendu, données structurées. Un robot bloqué rend inutile chaque correctif de contenu en aval.
Des vérifications ponctuelles manuelles peuvent bâtir une première base de référence, mais elles ne passent pas à l’échelle au-delà d’une grappe et deviennent périmées en quelques semaines, car les réponses générées dérivent. C’est le travail qu’automatisent le suivi de la visibilité dans l’IA et le suivi des citations en IA : le même ensemble de prompts, exécuté contre ChatGPT, Claude, Gemini et Perplexity selon un calendrier, noté de la même façon à chaque fois.
Phase 3 : livrer un correctif priorisé par cycle
Livrez l’unique changement à plus fort impact par grappe par cycle, car l’attribution vaut plus que le débit. Si cinq choses sont livrées d’un coup et que les citations bougent, vous n’avez rien appris sur lequel des cinq a fonctionné, et le cycle suivant tourne à la devinette. Un changement, remesuré, produit une leçon vérifiée ; douze cycles par an produisent douze leçons sur ce qui gagne des citations sur votre marché spécifique, ce qu’aucun playbook générique ne peut donner.
Priorisez avec cette échelle, en vous arrêtant au premier barreau non satisfait, car chaque barreau est une précondition de ceux en dessous :
- Explorabilité. La page doit être atteignable et rendue par les robots de recherche et d’IA sans interaction. Une réponse parfaite derrière un user agent bloqué ou un mur JavaScript n’existe pas du point de vue du moteur.
- Réponses directes. Chaque section commence par une réponse d’une à deux phrases à sa question sous-jacente. Les moteurs extraient les passages autonomes ; les pages qui enterrent la réponse au quatrième paragraphe sont rarement citées.
- Preuves structurées. Définitions, tableaux de comparaison et étapes qu’un moteur peut extraire proprement, plus un balisage schema qui confirme de façon lisible par les machines ce à quoi la page répond.
- Clarté d’entité. Marque, produit et catégorie nommés de façon cohérente, sur cette page et sur chaque page qui la référence. Les moteurs ne citent pas les sources qu’ils ne peuvent pas identifier avec confiance.
- Liens internes. Des pages de support liant vers la page canonique avec des ancres descriptives, pour que l’autorité de la grappe se concentre sur l’URL censée gagner.
Exemple illustratif de l’échelle en action : la base de référence montre des concurrents cités pour « meilleurs outils de la catégorie X » sur deux moteurs tandis que vous êtes absent, et la vérification technique montre que votre page de comparaison s’explore bien. Le barreau 1 passe, le barreau 2 échoue : la page commence par trois paragraphes d’histoire de la catégorie. L’unique correctif du cycle est de la réécrire en answer-first avec un tableau de verdict extractible, pas de publier dix nouveaux articles. La discipline du cadre est exactement cela : la grande action tentante perd face à la petite action diagnostiquée.
Phase 4 : remesurer le même ensemble, et laisser le delta piloter
Relancez l’ensemble identique de prompts et de requêtes de la phase 2 et comparez à la base de référence écrite, pas à la mémoire, car la mémoire flatte. La comparaison donne l’un de trois résultats, chacun avec un prochain mouvement défini :
- A bougé comme espéré. Le schéma de correctif est validé pour votre marché. Renforcez-le : appliquez le même schéma à la grappe suivante, et enregistrez-le dans un journal courant de ce qui fonctionne.
- Aucun mouvement. Vérifiez d’abord les explications ennuyeuses : la page a-t-elle été réexplorée du tout, et le cycle a-t-il laissé assez de temps ? Si oui, l’hypothèse était fausse ; annulez ou remplacez le correctif et essayez le barreau suivant de l’échelle.
- A bougé dans le mauvais sens. Rare, mais cela arrive, et l’attraper en un cycle plutôt qu’en un trimestre est précisément pourquoi les changements sont livrés un à la fois.
La cadence compte ici. Deux à quatre semaines par cycle est la plage opérationnelle : plus court, et les moteurs ont rarement retraité votre changement, donc « aucun mouvement » est du bruit ; plus long, et une dérive sans rapport dans les réponses contamine l’attribution. Notez aussi que les réponses générées ne sont pas entièrement déterministes, donc jugez les deltas sur des exécutions répétées et des tendances plutôt qu’une seule capture d’écran avant-après. La façon dont les exécutions sont notées et agrégées est documentée dans la méthodologie de suivi des citations en IA.
Sur six mois, ce journal de deltas vérifiés devient le vrai actif du programme : un dossier défendable et spécifique au marché de quels schémas de contenu gagnent des citations pour vous, qu’aucun concurrent ne peut copier et qu’aucun fournisseur ne peut vendre.
Où se situe AEO Goal : exécuter la boucle au lieu de l’administrer
Chaque phase ci-dessus peut être exécutée avec des feuilles de calcul, et la phase de propriété le devrait, car aucun outil n’attribue la responsabilité. La charge de la boucle se concentre dans les phases 2 à 4 : exécuter les ensembles de prompts contre quatre moteurs selon un calendrier, diagnostiquer pourquoi une page n’est pas citée, choisir le correctif, et remesurer à l’identique. C’est la partie qu’AEO Goal automatise, et il est bâti comme un agent plutôt qu’un tableau de bord, ce qui compte spécifiquement pour ce cadre : l’unité dont la boucle a besoin n’est pas un graphique, c’est un correctif diagnostiqué avec une revérification.
En pratique : la base de référence provient du suivi des citations en IA et du suivi de la visibilité dans l’IA qui exécutent les prompts de vos grappes à travers ChatGPT, Claude, Gemini et Perplexity, aux côtés de la recherche de mots-clés, du suivi de positions quotidien et de l’autorité des backlinks pour le tableau de bord classique, le tout dans un seul espace de travail. L’échelle de la phase 3 est en fait ce que la file de correctifs implémente : chaque écart arrive diagnostiqué (robot bloqué, réponse directe manquante, schema faible, confusion d’entité) avec la remédiation concrète jointe, et les correctifs de forme contenu arrivent sous forme de briefs answer-first via la génération de contenu AEO. La phase 4 est le prochain scan programmé : mêmes prompts, même notation, delta rapporté, ce qui transforme la remesure d’un projet récurrent en un processus d’arrière-plan. Le propriétaire prend encore chaque décision de jugement ; l’outil supprime les parties de la boucle qui n’ont jamais relevé du jugement.
Modes d’échec qui cassent la boucle
- L’audit permanent. La phase 2 s’étend jusqu’à devenir le programme. Encadrez la base de référence dans le temps ; incomplète-mais-reproductible bat complète-mais-jamais-finie.
- Le regroupement sous pression. Un décideur veut tout corriger maintenant, cinq changements sont livrés, et l’attribution meurt. Tenez la ligne : un changement attribuable par grappe par cycle.
- Remesurer un ensemble différent. La liste de prompts croît et se déplace discrètement, de sorte que le cycle quatre ne peut pas être comparé au cycle un. Figez l’ensemble de référence ; ajoutez les nouveaux prompts comme un groupe séparé et nouvellement mis en référence.
- Suivre un seul tableau de bord. Les positions s’améliorent, les citations non, et personne ne le remarque pendant un trimestre parce que personne ne mesurait les réponses. Les deux tableaux de bord, à chaque cycle.
- Aucune condition de sortie. Les phases sans conditions de sortie deviennent des réunions permanentes. Si une phase ne peut pas énoncer ce que « terminé pour ce cycle » signifie, ce n’est pas une phase, c’est une habitude.