Ce que vous allez apprendre
À la fin de ce module, vous serez capable de :
- Auditer robots.txt pour les robots d’IA qui alimentent chaque moteur de réponse, et savoir quel agent contrôle quelle surface.
- Vérifier les canonicals, l’inclusion dans le sitemap et la visibilité de la réponse statique avec des commandes, pas des devinettes.
- Structurer les titres pour qu’un extracteur puisse extraire votre réponse proprement.
- Écrire un JSON-LD honnête et savoir quand laisser une page entièrement sans schema.
- Diagnostiquer le cas classique : une page qui se positionne dans Google mais n’apparaît jamais comme citation en IA.
Le module 3 vous a donné une carte de pages. Ce module vérifie que chaque URL qui s’y trouve peut physiquement concourir avant que vous n’y consacriez du temps de rédaction.
Pourquoi « se positionne bien » ne veut pas dire « éligible à la citation »
L’éligibilité Google et l’éligibilité aux moteurs de réponse se recoupent mais ne sont pas le même test. Les fonctionnalités d’IA de Google réutilisent l’éligibilité ordinaire de la recherche : si Googlebot peut vous explorer et vous indexer, vous pouvez apparaître dans AI Overviews.
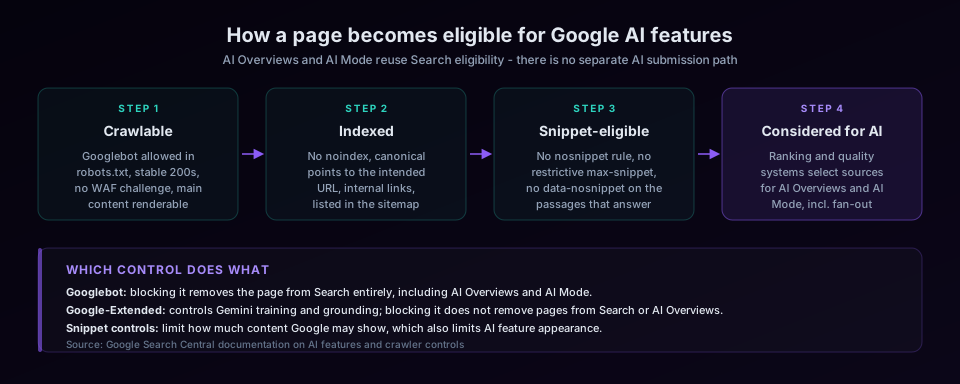
Les autres moteurs exécutent leurs propres robots avec leurs propres identités robots.txt, donc une page peut être parfaitement saine pour Google et invisible pour ChatGPT. Et chaque moteur ajoute une exigence d’extraction par-dessus l’exploration : la réponse doit exister sous forme de texte propre, statique et extractible. Cela vous donne trois classes d’échec indépendantes : l’accès (un robot est bloqué), la santé de l’index (mauvais canonical, noindex, absence du sitemap) et l’extractibilité (la réponse a besoin de JavaScript, d’une interaction ou d’une connexion pour exister). La vérification de préparation ci-dessous les parcourt dans l’ordre.
La vérification de préparation en sept points
1. Accès des robots d’IA. Chaque moteur s’annonce avec un user agent documenté, et une seule ligne de robots.txt peut silencieusement vous retirer de toute une surface de réponses. Les plus importants :
| User agent | Opérateur | Contrôle |
|---|---|---|
| Googlebot | Index de recherche, qui alimente aussi AI Overviews | |
| Google-Extended | Si votre contenu fonde Gemini | |
| GPTBot | OpenAI | Collecte de données d’entraînement |
| OAI-SearchBot | OpenAI | Réponses de recherche de ChatGPT |
| ClaudeBot | Anthropic | L’index web de Claude |
| PerplexityBot | Perplexity | L’index de Perplexity |
| Bingbot | Microsoft | Bing, qui alimente aussi Copilot |
OpenAI documente ses trois agents sur platform.openai.com/docs/bots ; la liste complète de Google est dans l’aperçu des robots. Vérifiez votre fichier pour chaque nom. L’échec classique est un blocage datant de 2023 de tous les agents d’IA que personne n’a réexaminé depuis.
2. Réponse et canonical. Faites un curl -I sur l’URL : un seul 200, pas de chaîne de redirection. Vérifiez ensuite que la balise canonical pointe vers la page elle-même (ou le parent voulu). Un canonical pointant ailleurs indique à chaque moteur « ne m’indexe pas, crédite plutôt cette autre URL », ce qui est correct pour de vrais doublons et catastrophique quand un gabarit l’applique par accident. Le guide de consolidation des doublons de Google explique la logique de sélection.
3. Inclusion dans le sitemap. Chaque page canonique de votre carte a sa place dans le sitemap XML ; les URL redirigées, en noindex et non canoniques non. Un sitemap plein d’URL parasites gaspille l’attention d’exploration sur des pages que vous ne voulez pas diffuser.
4. Visibilité de la réponse statique. Affichez la source (le HTML brut, pas le DOM rendu) et cherchez la première phrase de votre réponse. Si elle est absente, votre réponse n’existe qu’après l’exécution du JavaScript, et vous pariez que chaque robot exécute votre JS. Googlebot rend le JavaScript ; la plupart des robots d’IA récupèrent le HTML brut. Rendez côté serveur tout ce que vous voulez faire citer.
5. Structure des titres. L’extraction fonctionne sur les sections. Un H1 énonçant le sujet, puis des H2 formulés comme les questions que posent les acheteurs, chacun suivi immédiatement de sa réponse :
<h1>AI Citation Tracking</h1>

<h2>What is AI citation tracking?</h2>
<p>AI citation tracking records which URLs ChatGPT, Claude, Gemini,
and Perplexity cite when answering buyer questions, so teams can see
whether their pages or their competitors' pages are the source.</p>

<h2>How often should you re-check citations?</h2>
<p>...</p>
Un H2 en forme de question avec une réponse complète de deux phrases directement en dessous est l’unité la plus facile du web pour un extracteur. Enterrer la réponse quatre paragraphes sous son titre sacrifie cet avantage.
6. Données structurées qui correspondent au contenu visible. Le JSON-LD rend le sens de votre page lisible par les machines : ce qu’est l’entité, qui la publie, à quelles questions elle répond. Un bloc FAQ honnête ressemble à ceci :
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "What is AI citation tracking?",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "AI citation tracking records which URLs AI answer engines cite when answering buyer questions."
    }
  }]
}
</script>
La règle d’airain, tirée directement des recommandations de données structurées de Google : le balisage doit décrire un contenu visible sur la page. Le schema est une étiquette, pas un levier ; étiqueter un contenu que la page ne contient pas risque des actions manuelles et érode exactement la confiance machine que vous essayez de bâtir. Validez avec validator.schema.org et le test des résultats enrichis de Google. Voyez le glossaire des données structurées pour les définitions de types.
7. Liens internes. Déjà couverts mécaniquement au module 1 ; la question de préparation ici est la couverture. Chaque URL de votre carte de pages devrait être atteignable en trois clics et liée avec des ancres descriptives depuis au moins deux autres pages pertinentes.
Exemple travaillé : se positionne sur Google, invisible pour ChatGPT
Une équipe SaaS remarque que son guide d’intégration se positionne en première page pour son mot-clé mais n’apparaît jamais dans les réponses de recherche de ChatGPT, où un guide inférieur d’un concurrent est cité constamment. En parcourant les vérifications dans l’ordre :
curl -Irenvoie 200. Réussi.- robots.txt :
User-agent: OAI-SearchBot / Disallow: /se trouve dans un bloc ajouté lors d’un sprint « bloquer les scrapers d’IA » de 2023, sous un bloc allow-all pour*. Les règles d’agent spécifiques l’emportent sur le joker. Échec, et cela seul explique le symptôme. - Le canonical s’auto-référence. Réussi.
- Affichage de la source : les étapes du guide sont dans le HTML statique. Réussi.
- Titres : le H1 est le slogan de la marque et la question réelle est un H3 à mi-chemin. Faible, mérite d’être corrigé, mais secondaire.
Le correctif consiste à supprimer deux lignes de robots.txt plus un nettoyage des titres, pas la réécriture de contenu pour laquelle l’équipe avait budgété un sprint. C’est le gain de diagnostiquer dans l’ordre : la première vérification en échec est généralement toute l’histoire, et elle est généralement bon marché.
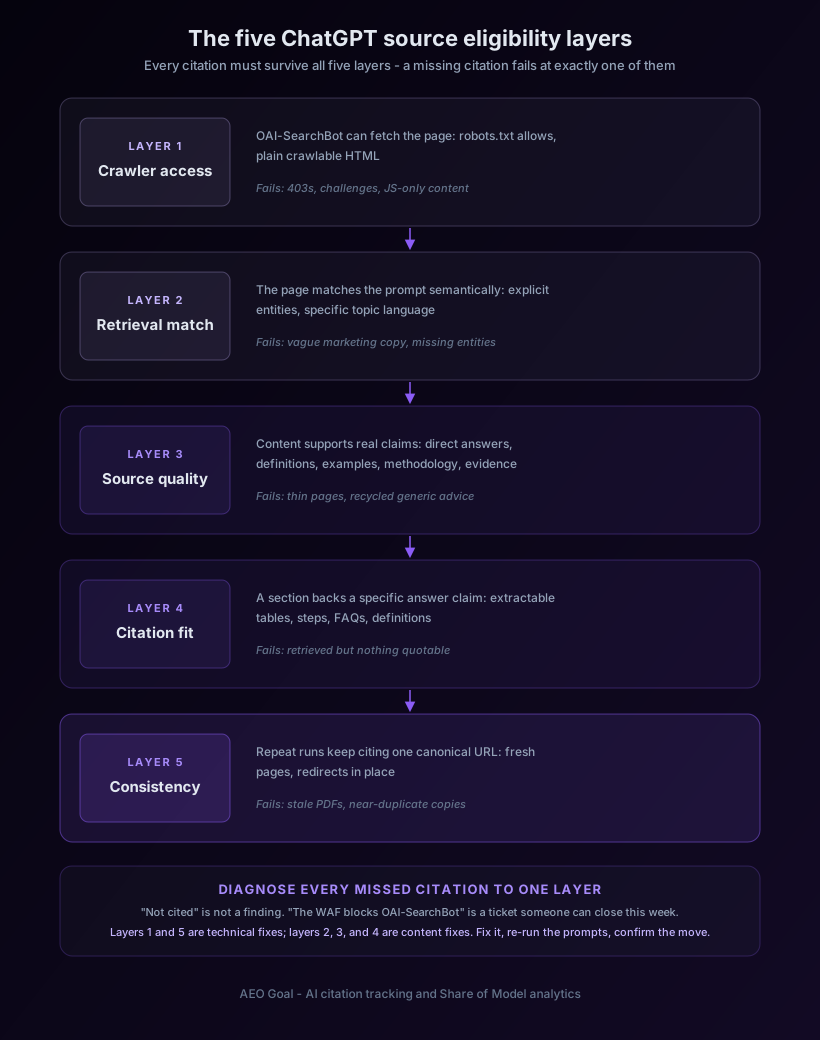
La version en cinq couches de ce diagnostic pour ChatGPT spécifiquement ressemble à ceci :
Exercice : auditez une page cartographiée
Prenez l’URL la plus importante commercialement de votre carte du module 3. Prévoyez une heure.
- Récupérez
https://yoursite.com/robots.txtet vérifiez-le par rapport aux sept user agents du tableau ci-dessus. Enregistrez tout blocage et s’il est intentionnel. - Exécutez
curl -Isur l’URL. Enregistrez le statut et tout saut de redirection. - Affichez la source. Confirmez que le canonical s’auto-référence, que la balise meta robots ne dit pas noindex, et que la première phrase de votre réponse voulue apparaît dans le HTML brut.
- Confirmez que l’URL est dans votre sitemap et inspectez-la dans Google Search Console.
- Copiez votre plan de titres (H1, H2) dans un document. Demandez : un inconnu pourrait-il reconstruire les questions de la page à partir des seuls H2 ? Réécrivez tout titre qui échoue.
- Si la page a un schema, collez-le dans validator.schema.org et vérifiez que chaque affirmation qu’il contient est visible sur la page. Si elle n’en a aucun, décidez si Article, FAQPage ou SoftwareApplication convient honnêtement, ou si la réponse honnête est aucun.
- Écrivez le résultat sous forme de note à trois colonnes : problème, impact, propriétaire. Tout ce qui relève des classes accès ou index l’emporte sur tout le reste.
Un outil d’audit SEO technique automatise les étapes 1 à 4 sur tout le site ; faites-le à la main une fois pour que la sortie de l’outil signifie quelque chose pour vous.
Erreurs courantes
- Bloquer les robots d’IA et oublier. Les deux lignes les plus coûteuses des fichiers robots.txt modernes. Auditez le fichier chaque trimestre et après chaque sprint de « durcissement de sécurité ».
- Le schema comme formule magique. Baliser un contenu qui n’est pas visible, ou empiler six types sur une page, ne fait rien qu’un extracteur récompense et risque des pénalités.
- Réponses rendues côté client. Si votre réponse a besoin de JavaScript pour exister, une partie de votre audience de machines ne la voit jamais.
- Pourrissement du sitemap. Des URL redirigées et supprimées qui traînent dans le sitemap pendant des années, diluant l’attention d’exploration.
- Réécrire le contenu pour corriger un échec technique. Si la vérification 1 ou 2 échoue, aucune amélioration de texte ne compte. L’ordre est tout.
Où AEO Goal automatise cela
Les sept vérifications ci-dessus sont exactement ce que le scan de visibilité gratuit d’AEO Goal exécute côté serveur contre votre domaine : robots.txt sur les agents d’IA, llms.txt, couverture du sitemap, validité du JSON-LD, métadonnées et prominence des entités, chaque constat associé à un correctif précis et classé par impact. La boucle d’agent compte le plus ici : après avoir livré le correctif de robots.txt ou de schema, le scan suivant le revérifie, de sorte qu’un problème corrigé reste corrigé de façon vérifiable au lieu de régresser silencieusement au prochain déploiement.
Récapitulatif et module suivant
Vous pouvez maintenant séparer les trois classes d’échec (accès, santé de l’index, extractibilité), toutes les auditer avec de vraies commandes, et structurer les titres et le schema pour que les machines puissent extraire vos réponses honnêtement. La plomberie est vérifiée.
Ce qui circule dans la plomberie, c’est le contenu, et le contenu est là où la plupart des programmes AEO échouent discrètement. Continuez avec Optimisation de contenu et briefs pour transformer chaque URL cartographiée et auditée en une page digne d’être citée.