Qué vas a aprender
Al terminar este módulo serás capaz de:
- Auditar robots.txt para los rastreadores de IA que alimentan cada motor de respuesta, y saber qué agente controla qué superficie.
- Verificar canónicas, inclusión en el sitemap y visibilidad de la respuesta estática con comandos, no con suposiciones.
- Estructurar los encabezados para que un extractor pueda extraer tu respuesta con limpieza.
- Escribir JSON-LD honesto y saber cuándo dejar una página sin schema por completo.
- Diagnosticar el caso clásico: una página que posiciona en Google pero nunca aparece como cita de IA.
El módulo 3 te dio un mapa de páginas. Este módulo verifica que cada URL de ese mapa puede competir físicamente antes de que inviertas tiempo de redacción en ella.
Por qué “posiciona bien” no significa “elegible para citas”
La elegibilidad en Google y la elegibilidad en los motores de respuesta se solapan, pero no son la misma prueba. Las funciones de IA de Google reutilizan la elegibilidad ordinaria de la Búsqueda: si Googlebot puede rastrearte e indexarte, puedes aparecer en Google AI Overviews.
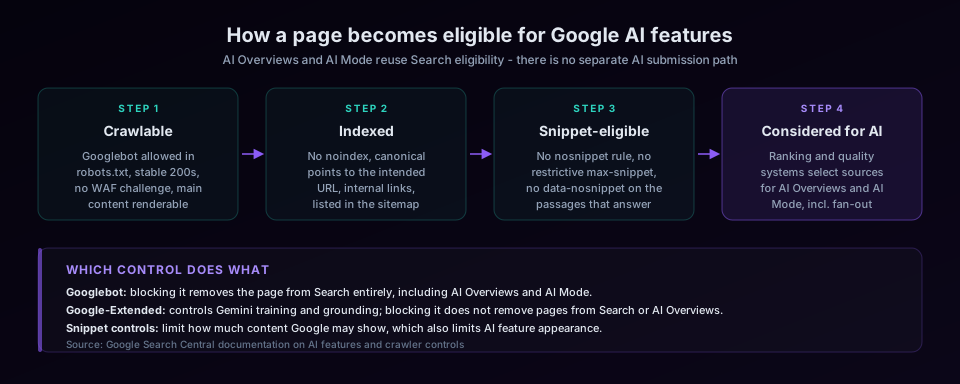
Otros motores ejecutan sus propios rastreadores con sus propias identidades en robots.txt, así que una página puede estar perfectamente sana para Google y ser invisible para ChatGPT. Y cada motor añade un requisito de extracción por encima del rastreo: la respuesta debe existir como texto limpio, estático y extraíble. Eso te deja tres clases de fallo independientes: acceso (un rastreador está bloqueado), salud de indexación (canónica incorrecta, noindex, ausencia en el sitemap) y extractibilidad (la respuesta necesita JavaScript, interacción o un inicio de sesión para existir). La comprobación de preparación de más abajo las recorre en orden.
La comprobación de preparación de siete puntos
1. Acceso de los rastreadores de IA. Cada motor se anuncia con un user agent documentado, y una sola línea de robots.txt puede eliminarte en silencio de toda una superficie de respuestas. Los que más importan:
| User agent | Operador | Controla |
|---|---|---|
| Googlebot | Índice de búsqueda, que también alimenta AI Overviews | |
| Google-Extended | Si tu contenido fundamenta a Gemini | |
| GPTBot | OpenAI | Recopilación de datos de entrenamiento |
| OAI-SearchBot | OpenAI | Respuestas de búsqueda de ChatGPT |
| ClaudeBot | Anthropic | Índice web de Claude |
| PerplexityBot | Perplexity | Índice de Perplexity |
| Bingbot | Microsoft | Bing, que también alimenta Copilot |
OpenAI documenta sus tres agentes en platform.openai.com/docs/bots; la lista completa de Google está en el resumen de rastreadores. Comprueba tu archivo con cada nombre. El fallo clásico es un bloqueo de 2023 de todos los agentes de IA que nadie ha vuelto a revisar desde entonces.
2. Respuesta y canónica. Ejecuta curl -I sobre la URL: un solo 200, sin cadena de redirecciones. Después comprueba que la etiqueta canónica apunta a la propia página (o al padre previsto). Una canónica que apunta a otro sitio le dice a cada motor “no me indexes, atribúyelo a esa otra URL”, lo cual es correcto para duplicados reales y catastrófico cuando una plantilla lo aplica por accidente. La guía de consolidación de duplicados de Google explica la lógica de selección.
3. Inclusión en el sitemap. Cada página canónica de tu mapa pertenece al sitemap XML; las URL redirigidas, con noindex y no canónicas no. Un sitemap lleno de URL basura desperdicia la atención de rastreo en páginas que no quieres servir.
4. Visibilidad de la respuesta estática. Consulta el código fuente (el HTML en bruto, no el DOM renderizado) y busca la primera frase de tu respuesta. Si no está, tu respuesta solo existe después de que se ejecute el JavaScript, y estás apostando a que todos los rastreadores ejecutan tu JS. Googlebot renderiza JavaScript; la mayoría de los rastreadores de IA obtienen el HTML en bruto. Renderiza en el servidor cualquier cosa que quieras que se cite.
5. Estructura de encabezados. La extracción funciona por secciones. Un solo H1 que enuncie el tema, luego H2 formulados como las preguntas que hacen los compradores, cada uno seguido inmediatamente por su respuesta:
<h1>AI Citation Tracking</h1>

<h2>What is AI citation tracking?</h2>
<p>AI citation tracking records which URLs ChatGPT, Claude, Gemini,
and Perplexity cite when answering buyer questions, so teams can see
whether their pages or their competitors' pages are the source.</p>

<h2>How often should you re-check citations?</h2>
<p>...</p>
Un H2 en forma de pregunta con una respuesta completa de dos frases justo debajo es la unidad más fácil de extraer que hay en la web. Enterrar la respuesta cuatro párrafos por debajo de su encabezado renuncia a esa ventaja.
6. Datos estructurados que coinciden con el contenido visible. El JSON-LD hace que el significado de tu página sea legible por máquinas: qué es la entidad, quién la publica, qué preguntas responde. Un bloque de FAQ honesto tiene este aspecto:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "What is AI citation tracking?",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "AI citation tracking records which URLs AI answer engines cite when answering buyer questions."
    }
  }]
}
</script>
La regla de hierro, directamente de las directrices de datos estructurados de Google: el marcado debe describir contenido visible en la página. El schema es una etiqueta, no una palanca; etiquetar contenido que la página no contiene arriesga acciones manuales y erosiona precisamente la confianza de las máquinas que intentas construir. Valida con validator.schema.org y la Prueba de resultados enriquecidos de Google. Consulta el glosario de datos estructurados para ver las definiciones de tipos.
7. Enlaces internos. Ya cubiertos mecánicamente en el módulo 1; la pregunta de preparación aquí es la cobertura. Cada URL de tu mapa de páginas debería ser accesible en tres clics y estar enlazada con anclas descriptivas desde al menos otras dos páginas relevantes.
Ejemplo trabajado: posiciona en Google, invisible para ChatGPT
Un equipo de SaaS observa que su guía de integración posiciona en la primera página para su palabra clave, pero nunca aparece en las respuestas de búsqueda de ChatGPT, donde la guía inferior de un competidor se cita constantemente. Recorriendo las comprobaciones en orden:
curl -Idevuelve 200. Correcto.- robots.txt:
User-agent: OAI-SearchBot / Disallow: /está en un bloque añadido durante un sprint de 2023 de “bloquear a los rastreadores de IA”, por debajo de un bloque de permiso total para*. Las reglas de agente específico anulan el comodín. Fallo, y esto por sí solo explica el síntoma. - La canónica se autorreferencia. Correcto.
- Código fuente: los pasos de la guía están en el HTML estático. Correcto.
- Encabezados: el H1 es el eslogan de la marca y la pregunta real es un H3 a mitad de página. Débil, vale la pena arreglarlo, pero secundario.
La solución es borrar dos líneas de robots.txt más una limpieza de encabezados, no la reescritura de contenido para la que el equipo había presupuestado un sprint. Esta es la recompensa de diagnosticar en orden: la primera comprobación que falla suele ser toda la historia, y suele ser barata.
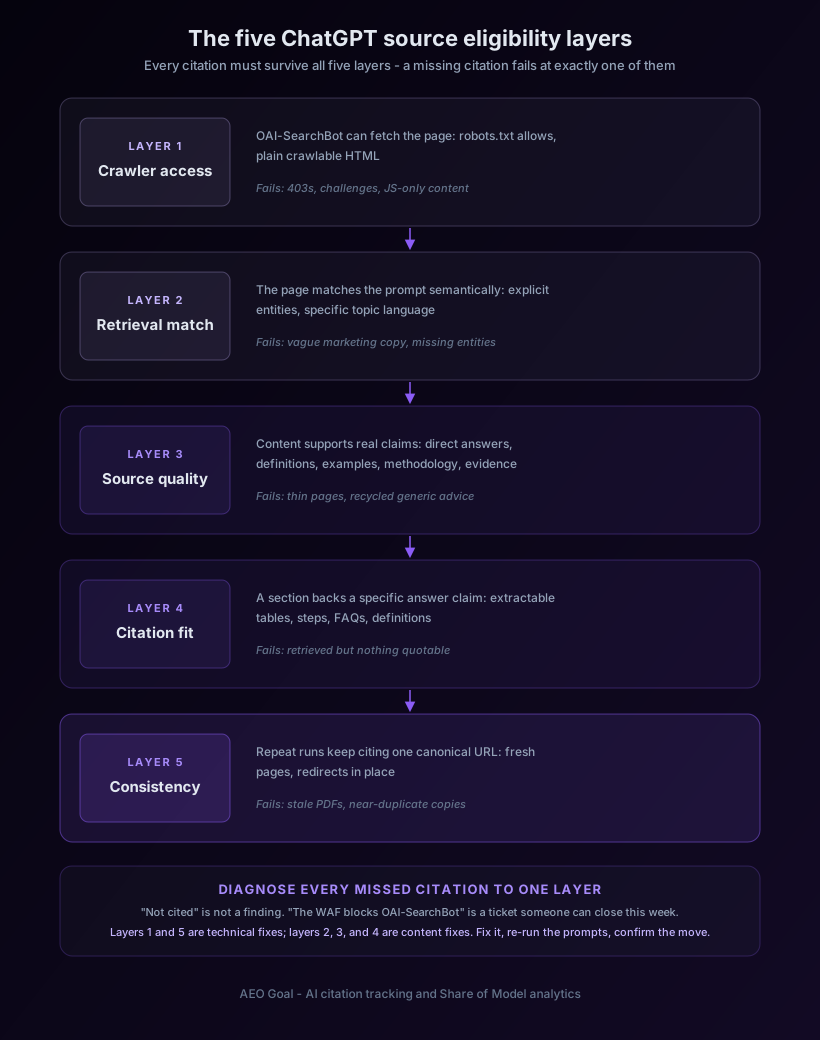
La versión de cinco capas de este diagnóstico, específica para ChatGPT, tiene este aspecto:
Ejercicio: audita una página del mapa
Toma la URL comercialmente más importante de tu mapa del módulo 3. Presupuesta una hora.
- Obtén
https://yoursite.com/robots.txty compáralo con los siete user agents de la tabla de arriba. Registra cualquier bloqueo y si es intencionado. - Ejecuta
curl -Isobre la URL. Registra el estado y cualquier salto de redirección. - Consulta el código fuente. Confirma que la canónica se autorreferencia, que la etiqueta meta robots no dice noindex y que la primera frase de la respuesta que pretendes dar aparece en el HTML en bruto.
- Confirma que la URL está en tu sitemap e inspecciónala en Google Search Console.
- Copia el esquema de tus encabezados (H1, H2) en un documento. Pregúntate: ¿podría un desconocido reconstruir las preguntas de la página solo a partir de los H2? Reescribe cualquier encabezado que no lo supere.
- Si la página tiene schema, pégalo en validator.schema.org y verifica que cada afirmación es visible en la página. Si no tiene ninguno, decide si Article, FAQPage o SoftwareApplication encaja honestamente, o si la respuesta honesta es ninguno.
- Escribe el resultado como una nota de tres columnas: problema, impacto, responsable. Cualquier cosa de las clases de acceso o de indexación tiene prioridad sobre todo lo demás.
Una herramienta de auditoría de SEO técnico automatiza los pasos 1 a 4 en todo el sitio; hazlo a mano una vez para que la salida de la herramienta signifique algo para ti.
Errores comunes
- Bloquear los rastreadores de IA y olvidarlo. Las dos líneas más caras de los archivos robots.txt modernos. Audita el archivo cada trimestre y después de cada sprint de “endurecimiento de seguridad”.
- El schema como hechizo mágico. Marcar contenido que no es visible, o apilar seis tipos en una página, no hace nada que un extractor premie y arriesga penalizaciones.
- Respuestas renderizadas en el cliente. Si tu respuesta necesita JavaScript para existir, parte de tu audiencia de máquinas nunca la ve.
- Sitemap podrido. URL redirigidas y borradas que llevan años en el sitemap, diluyendo la atención de rastreo.
- Reescribir contenido para arreglar un fallo técnico. Si la comprobación 1 o 2 falla, ninguna mejora de texto importa. El orden lo es todo.
Dónde lo automatiza AEO Goal
Las siete comprobaciones de arriba son exactamente lo que ejecuta el escaneo de visibilidad gratuito de AEO Goal del lado del servidor contra tu dominio: robots.txt en todos los agentes de IA, llms.txt, cobertura del sitemap, validez del JSON-LD, metadatos y saliencia de entidades, con cada hallazgo asociado a una solución concreta y ordenado por impacto. El bucle del agente es lo que más importa aquí: después de que despliegues la corrección de robots.txt o de schema, el siguiente escaneo la vuelve a comprobar, así que un problema resuelto sigue estando resuelto de forma verificable en lugar de regresar en silencio en el próximo despliegue.
Resumen y próximo módulo
Ahora puedes separar las tres clases de fallo (acceso, salud de indexación, extractibilidad), auditarlas todas con comandos reales y estructurar encabezados y schema para que las máquinas puedan extraer tus respuestas de forma honesta. La fontanería está verificada.
Lo que fluye por la fontanería es el contenido, y el contenido es donde la mayoría de los programas de AEO fallan en silencio. Continúa con Optimización de contenidos y briefs para convertir cada URL mapeada y auditada en una página que merezca ser citada.