Ce que vous allez apprendre
À la fin de ce module, vous serez capable de :
- Expliquer le pipeline en quatre étapes que traverse chaque page (explorer, rendre, indexer, diffuser) et identifier quelle étape échoue pour une URL donnée.
- Lire et rédiger un fichier robots.txt qui accueille les robots que vous voulez, y compris les robots d’IA qui alimentent ChatGPT, Claude, Gemini et Perplexity.
- Classer les requêtes par intention et attribuer à chaque grappe d’intention exactement une page canonique propriétaire.
- Réaliser un audit de fondation de 30 minutes sur votre propre site en n’utilisant rien d’autre qu’un navigateur et un terminal.
C’est le seul module du cours sans matériel spécifique à l’AEO, et c’est pourtant le plus important. Chaque leçon sur les moteurs de réponse qui suit suppose que le pipeline ci-dessous est sain.
Comment une page est réellement trouvée
Les moteurs de recherche ne « voient pas votre site web ». Ils exécutent un pipeline, et chaque étape peut échouer indépendamment :
- Explorer. Un robot comme Googlebot demande votre URL. Il ne le fait que s’il a découvert l’URL (via des liens ou votre sitemap) et que votre robots.txt autorise le chemin. Google documente ce comportement dans son introduction à robots.txt.
- Rendre. Le HTML récupéré est transformé en contenu. Le texte qui n’apparaît qu’après l’exécution du JavaScript, un clic ou une connexion risque de ne jamais être lu.
- Indexer. Le moteur stocke la page et, point crucial, choisit une URL canonique pour chaque ensemble de quasi-doublons. Si vous ne déclarez pas de canonical, Google en choisit un pour vous, et ce n’est pas toujours celui que vous vouliez.
- Diffuser. Le moteur fait correspondre la page indexée à une requête et décide de l’afficher, de la mettre en snippet ou, de plus en plus, de l’injecter dans une réponse générée par IA.
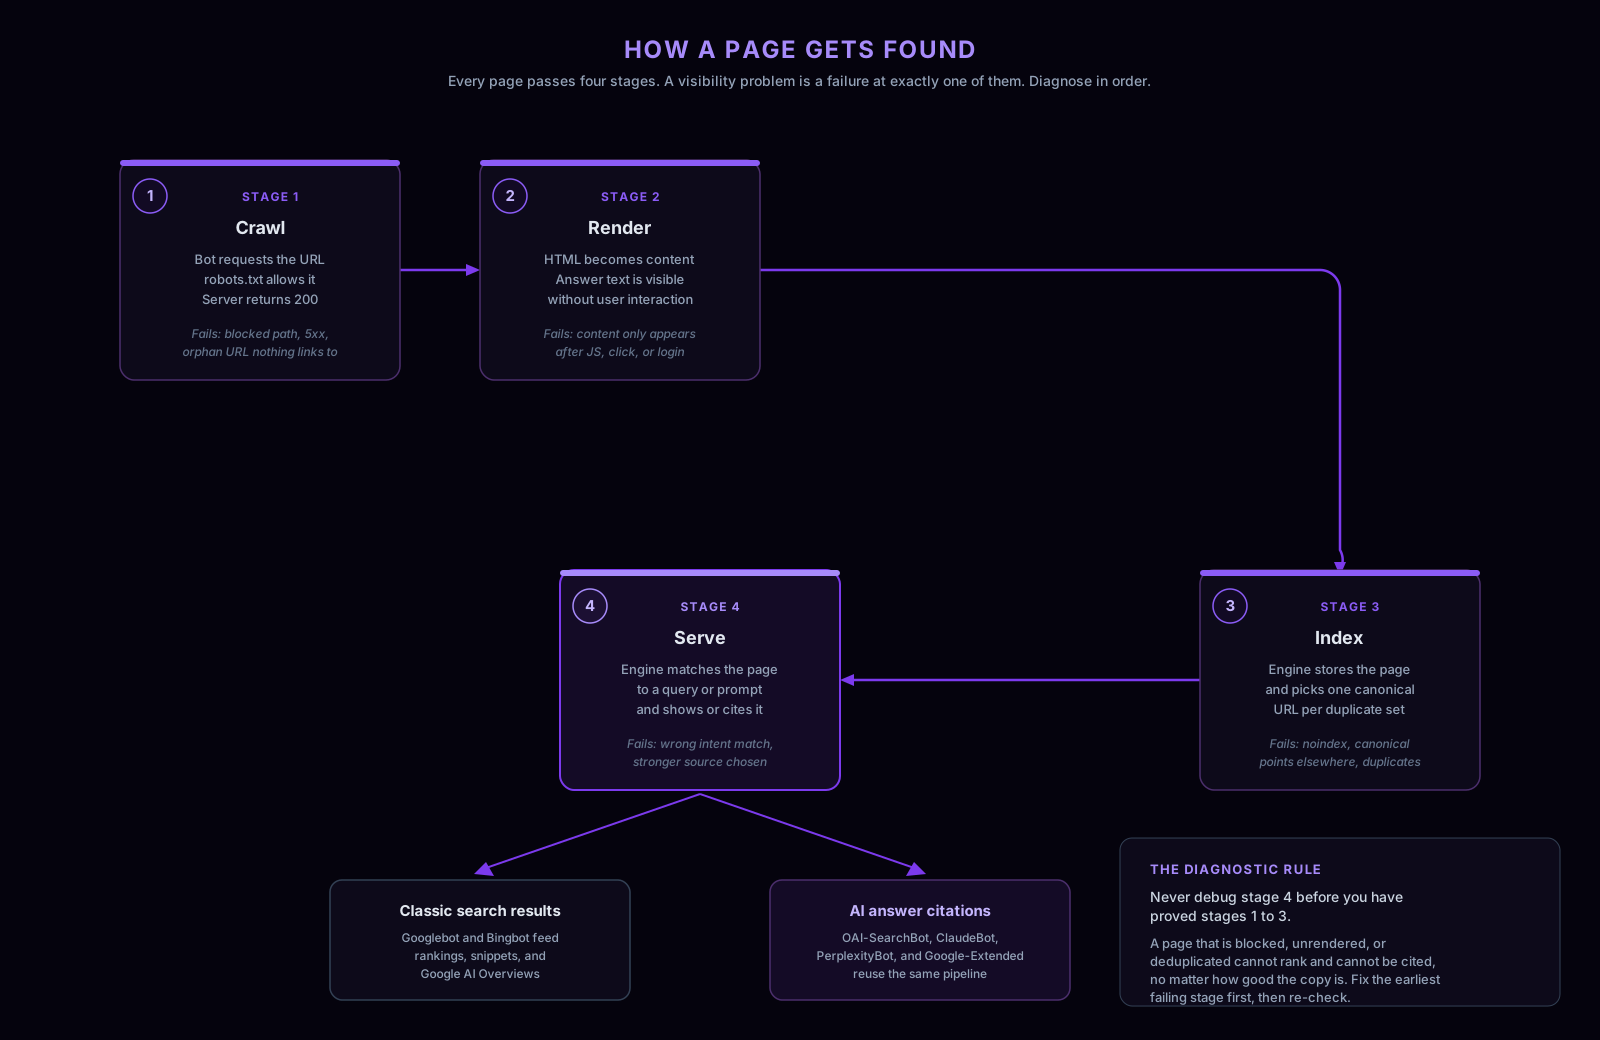
Le mécanisme compte parce qu’il vous donne une règle de diagnostic que vous utiliserez tout le reste de votre carrière : diagnostiquez dans l’ordre du pipeline. Une page qui renvoie un 500, se trouve derrière une règle Disallow, ou canonicalise vers une autre URL ne peut pas se positionner ni être citée, aussi brillant que soit le texte. Les équipes qui sautent cette règle réécrivent du contenu sain alors que le vrai problème tient à une ligne dans un fichier de config.
Voici la deuxième raison pour laquelle les fondations rapportent double en 2026 : les moteurs de réponse par IA réutilisent le même pipeline. OpenAI documente ses robots (GPTBot, OAI-SearchBot et ChatGPT-User), Anthropic exploite ClaudeBot, Perplexity exploite PerplexityBot, et Google utilise Google-Extended pour contrôler si le contenu fonde Gemini. Tous lisent robots.txt. Une page invisible pour les robots de recherche est généralement invisible pour les moteurs de réponse aussi, donc chaque correctif de fondation de ce module améliore les deux surfaces à la fois.
robots.txt : le fichier qui décide qui entre
robots.txt est un fichier texte brut à la racine de votre domaine. Chaque bloc de règles nomme un user agent et liste les chemins qu’il peut ou ne peut pas récupérer. Une valeur par défaut raisonnable pour un site marketing SaaS ressemble à ceci :
# https://example.com/robots.txt

# Tout le monde peut lire le site public
User-agent: *
Allow: /

# Mais personne n'a besoin de l'application privée ni de l'API
User-agent: *
Disallow: /app/
Disallow: /api/

Sitemap: https://example.com/sitemap.xml
Deux règles de décision :
- Bloquer par chemin, pas par bot. Bloquer
/app/pour tout le monde est un choix délibéré. BloquerUser-agent: GPTBotsur/est aussi un choix, mais faites-le consciemment : cela retire votre site des données d’entraînement de ChatGPT et, si vous bloquez aussi OAI-SearchBot, des réponses de recherche de ChatGPT. De nombreux sites ont bloqué tous les agents d’IA en 2023 avec un bloc deny-all copié-collé et n’ont jamais réexaminé cette décision. - robots.txt contrôle l’exploration, pas l’indexation. Une URL bloquée peut tout de même apparaître dans les résultats si d’autres sites la lient. Pour garder une page hors de l’index, utilisez plutôt une balise meta robots noindex sur une page explorable.
Bing publie sa propre documentation de robots, qui compte plus qu’avant : l’index de Bing alimente aussi Microsoft Copilot.
Intention de recherche et propriété des pages
Les moteurs ne font pas correspondre des chaînes de caractères, ils modélisent la tâche derrière la requête. Vous pouvez observer la classification directement : cherchez un terme et regardez ce qui se positionne. Si les résultats sont des définitions, l’intention est éducative. Si ce sont des pages produit, elle est commerciale. Si ce sont des listes de comparaison, le moteur a décidé que les gens veulent des options.
Cette observation vous donne la règle de propriété sur laquelle tout ce cours est bâti : une grappe d’intention, une page canonique. Le mécanisme derrière la règle est la consolidation des signaux. Quand deux de vos pages visent la même intention, trois mauvaises choses se produisent mécaniquement :
- Les liens externes et internes se divisent entre les deux URL, donc aucune n’accumule d’autorité.
- L’étape de déduplication du moteur peut les fusionner et choisir son propre canonical.
- Votre analytique se divise aussi, donc vous ne pouvez plus dire si le sujet fonctionne.
| Classe d’intention | Vous la reconnaissez parce que | Dirigez-la vers |
|---|---|---|
| Éducative (« qu’est-ce que l’optimisation pour les moteurs de réponse ») | Les résultats sont des définitions et des guides | Une page de définition comme Qu’est-ce que l’AEO |
| Commerciale (« logiciel de suivi de la visibilité dans l’IA ») | Les résultats sont des pages produit | Une seule page produit |
| Diagnostique (« SEO checker gratuit ») | Les résultats sont des outils interactifs | Une page d’outil comme le SEO analyzer |
| Comparaison (« meilleurs outils d’AI SEO ») | Les résultats sont des listes classées | Une seule page de comparaison |
| Support (« comment annuler X ») | Les résultats sont des docs et centres d’aide | Contenu d’aide, généralement en noindex, les termes de concurrents retirés |
Les liens internes font deux tâches
Les liens internes ne sont pas une garniture de navigation. Ils font deux tâches mécaniques. Premièrement, la découverte : les robots trouvent de nouvelles URL en suivant les liens, donc une page que rien ne lie (une « orpheline ») peut ne jamais entrer dans le pipeline, même si elle figure dans votre sitemap. Deuxièmement, le contexte : le texte d’ancrage est une étiquette. Un lien qui dit « audit SEO technique » indique à la fois à Google et à un système de récupération de LLM de quoi parle la page de destination ; un lien qui dit « cliquez ici » ne leur dit rien.
Deux règles opérationnelles : chaque page qui compte pour vous devrait être atteignable en trois clics depuis la page d’accueil, et chaque ancre devrait être une requête de recherche plausible pour sa destination.
Exemple travaillé : une fonctionnalité, cinq requêtes
Une entreprise SaaS B2B qui vend du suivi de citations recueille cinq expressions issues d’appels commerciaux et de recherche de mots-clés. Voici la décision de propriété pour chacune, avec le raisonnement explicité :
| Requête ou prompt | Ce que montre la SERP | Décision |
|---|---|---|
| « qu’est-ce que l’optimisation pour les moteurs de réponse » | Guides de définition | Éducative. Détenue par la page de définition. Ne créez pas un deuxième explicatif. |
| « logiciel de suivi de la visibilité dans l’IA » | Pages produit | Commerciale. Détenue par la page produit. Améliorez-la, ne la scindez jamais. |
| « SEO checker gratuit » | Outils interactifs | Diagnostique. Détenue par une page d’outil. Un article de blog ne peut pas gagner cette intention. |
| « meilleurs outils d’AI SEO » | Listes de comparaison classées | Comparaison. Détenue par une seule page de comparaison qui liste honnêtement les concurrents. |
| « bases du SEO pour fondateurs » | Cours et guides | Éducative, large. À intégrer dans le hub du cours plutôt qu’une nouvelle page mince. |
Remarquez ce qui ne s’est pas produit : personne n’a proposé cinq nouvelles pages. Quatre des cinq intentions avaient déjà un propriétaire. Le résultat d’un travail de fondation est généralement un plan de contenu plus court, pas plus long.
Exercice : l’audit de fondation de 30 minutes
Faites ceci sur votre propre site aujourd’hui. Vous avez besoin d’un navigateur et d’un terminal.
- Vérifiez la réponse. Exécutez
curl -I https://yoursite.com/your-page. Vous voulez un seul200, pas une chaîne de redirections et pas un404derrière une jolie page d’erreur. - Lisez votre robots.txt. Ouvrez
https://yoursite.com/robots.txt. Confirmez que le chemin de votre page n’est pas interdit, puis vérifiez spécifiquement les blocagesGPTBot,OAI-SearchBot,ClaudeBot,PerplexityBotetGoogle-Extendedque vous ne vous souvenez pas d’avoir ajoutés. - Vérifiez l’index. Dans Google Search Console, utilisez l’inspection d’URL sur la page. Elle vous dit directement si la page est indexée et quel canonical Google a sélectionné.
- Vérifiez le rendu. Utilisez « afficher la source de la page » (pas l’inspecteur des outils de développement) et cherchez la première phrase de votre contenu principal. Si elle n’est pas dans le HTML brut, elle dépend du JavaScript pour exister.
- Construisez la carte de propriété. Listez dix requêtes ou questions d’acheteurs pour un domaine produit, étiquetez chacune avec une classe d’intention du tableau ci-dessus, et attribuez une URL canonique à chacune. Marquez les collisions (deux pages revendiquant une intention) comme candidates à la fusion.
Si les étapes 1 à 4 passent et que l’étape 5 produit une carte propre, vous avez une fondation sur laquelle bâtir.
Erreurs courantes
- Publier une page par variante de mot-clé. « Outil AEO », « logiciel AEO » et « plateforme AEO » sont une seule intention. Trois pages signifient trois pages faibles.
- Diagnostiquer le contenu avant le pipeline. Réécrire le texte d’une page en noindex est la semaine gaspillée la plus courante en SEO.
- Un robots.txt deny-all périmé. Bloquer tous les user agents d’IA était une valeur par défaut défendable en 2023 ; aujourd’hui, cela vous retire silencieusement de la surface de découverte à la croissance la plus rapide.
- Un noindex resté de la préproduction. Il part en production plus souvent que personne ne l’admet. Vérifiez-le explicitement au lancement.
- Pages orphelines. Dans le sitemap mais liées de nulle part. Les robots les dépriorisent et les utilisateurs ne les trouvent jamais.
Où AEO Goal automatise cela
Tout dans l’exercice ci-dessus peut se faire à la main, et vous devriez le faire à la main une fois pour comprendre la mécanique. En production, AEO Goal exécute les mêmes vérifications qu’un scan gratuit côté serveur : accès robots.txt pour les robots de recherche et d’IA, llms.txt, couverture du sitemap, données structurées et métadonnées. La différence avec une liste de vérification est la boucle : chaque constat est livré avec un correctif concret, et le scan suivant revérifie si le correctif a été appliqué au lieu de vous laisser avec un document d’audit périmé.
Récapitulatif et module suivant
Vous disposez maintenant des deux outils dont dépend chaque module ultérieur : le diagnostic du pipeline (explorer, rendre, indexer, diffuser, toujours dans cet ordre) et la carte de propriété (une intention, une URL canonique). Le guide de démarrage SEO de Google est la référence externe canonique si vous voulez approfondir une seule étape.
Le module 2 change la question. Au lieu de « les moteurs peuvent-ils trouver et positionner cette page », il demande « quand un système d’IA répond à la question d’un acheteur, nous mentionne-t-il, nous cite-t-il et nous décrit-il correctement ? » Continuez avec Bases de l’optimisation pour les moteurs de réponse.