Lo que aprenderás
Al terminar este módulo serás capaz de:
- Explicar el pipeline de cuatro etapas por el que pasa cada página (rastreo, renderizado, indexación y entrega) e identificar qué etapa está fallando para una URL concreta.
- Leer y escribir un archivo robots.txt que dé la bienvenida a los rastreadores que quieres, incluidos los rastreadores de IA que alimentan a ChatGPT, Claude, Gemini y Perplexity.
- Clasificar las consultas por intención y asignar a cada clúster de intención exactamente una página canónica propietaria.
- Ejecutar una auditoría de fundamentos de 30 minutos en tu propio sitio usando solo un navegador y una terminal.
Este es el único módulo del curso sin material específico de AEO y, aun así, es el más importante. Cada lección sobre motores de respuestas que sigue da por hecho que el pipeline de abajo está sano.
Cómo se encuentra realmente una página
Los motores de búsqueda no “ven tu sitio web”. Ejecutan un pipeline, y cada etapa puede fallar de forma independiente:
- Rastreo. Un bot como Googlebot solicita tu URL. Solo lo hace si ha descubierto la URL (a través de enlaces o de tu sitemap) y tu robots.txt permite la ruta. Google documenta este comportamiento en su introducción a robots.txt.
- Renderizado. El HTML obtenido se convierte en contenido. El texto que solo aparece tras la ejecución de JavaScript, un clic o un inicio de sesión corre el riesgo de que nunca se lea.
- Indexación. El motor almacena la página y, algo crucial, elige una única URL canónica para cada conjunto de casi-duplicados. Si no declaras una canónica, Google elige una por ti, y no siempre es la que querías.
- Entrega. El motor coteja la página indexada con una consulta y decide si mostrarla, resumirla en un snippet o, cada vez más, incorporarla a una respuesta generada por IA.
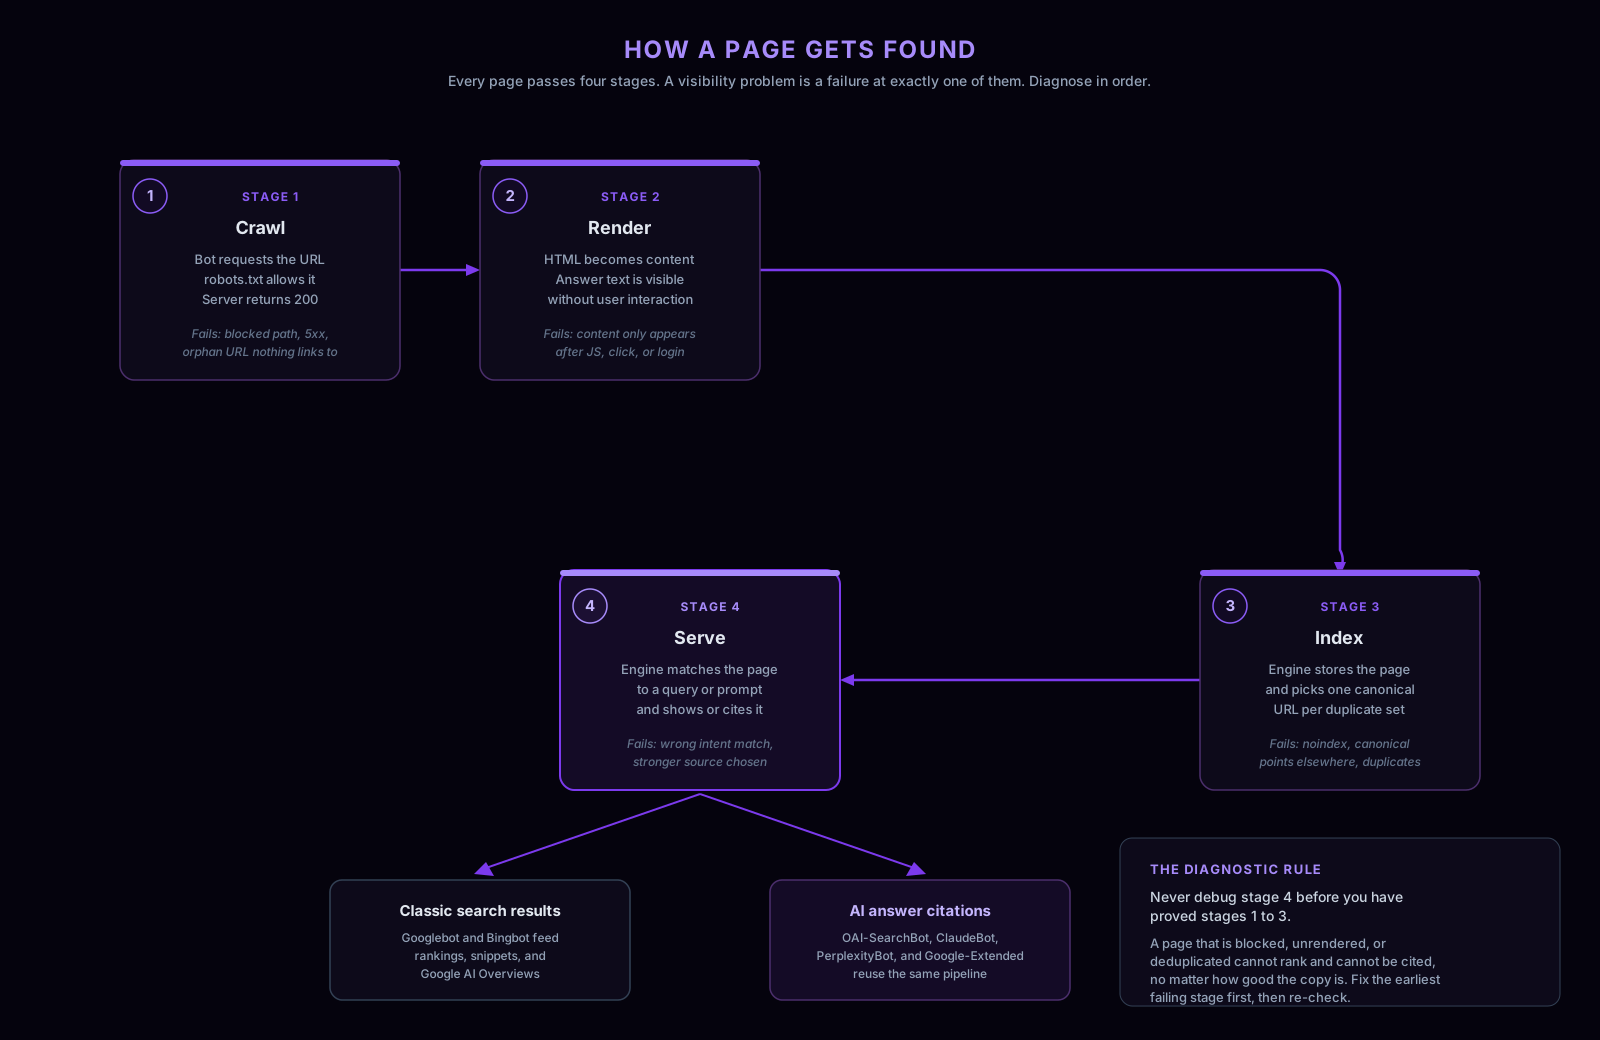
El mecanismo importa porque te da una regla de diagnóstico que usarás el resto de tu carrera: diagnostica en el orden del pipeline. Una página que devuelve un 500, que está detrás de una regla Disallow o que canonicaliza hacia otra URL no puede posicionar ni ser citada, por brillante que sea el texto. Los equipos que se saltan esta regla reescriben contenido sano mientras el problema real es una línea en un archivo de configuración.
Aquí está la segunda razón por la que los fundamentos rinden el doble en 2026: los motores de respuestas de IA reutilizan el mismo pipeline. OpenAI documenta sus rastreadores (GPTBot, OAI-SearchBot y ChatGPT-User), Anthropic ejecuta ClaudeBot, Perplexity ejecuta PerplexityBot y Google usa Google-Extended para controlar si el contenido sirve de base a Gemini. Todos ellos leen el robots.txt. Una página invisible para los rastreadores de búsqueda suele ser invisible también para los motores de respuestas, así que cada corrección de fundamentos de este módulo mejora ambas superficies a la vez.
robots.txt: el archivo que decide quién entra
robots.txt es un archivo de texto plano en la raíz de tu dominio. Cada bloque de reglas nombra un user agent y enumera las rutas que puede o no puede solicitar. Un valor por defecto razonable para un sitio de marketing de un SaaS tiene este aspecto:
# https://example.com/robots.txt

# Everyone may read the public site
User-agent: *
Allow: /

# But nobody needs the private app or API
User-agent: *
Disallow: /app/
Disallow: /api/

Sitemap: https://example.com/sitemap.xml
Dos reglas de decisión:
- Bloquea por ruta, no por bot. Bloquear
/app/para todo el mundo es una decisión deliberada. BloquearUser-agent: GPTBoten/también es una decisión, pero tómala de forma consciente: elimina tu sitio de los datos de entrenamiento de ChatGPT y, si además bloqueas OAI-SearchBot, de las respuestas de búsqueda de ChatGPT. Muchos sitios bloquearon todos los agentes de IA en 2023 con un bloque de denegación total copiado y pegado, y nunca revisaron la decisión. - robots.txt controla el rastreo, no la indexación. Una URL bloqueada todavía puede aparecer en los resultados si otros sitios la enlazan. Para mantener una página fuera del índice, usa una etiqueta meta robots noindex en una página rastreable en su lugar.
Bing publica su propia documentación de rastreadores, que importa más que antes: el índice de Bing también alimenta a Microsoft Copilot.
Intención de búsqueda y propiedad de la página
Los motores no cotejan cadenas de texto, modelan la tarea que hay detrás de la consulta. Puedes observar la clasificación directamente: busca un término y mira qué posiciona. Si los resultados son definiciones, la intención es educativa. Si son páginas de producto, es comercial. Si son listas comparativas, el motor ha decidido que la gente quiere opciones.
Esa observación te da la regla de propiedad sobre la que está construido todo este curso: un clúster de intención, una página canónica. El mecanismo detrás de la regla es la consolidación de señales. Cuando dos de tus páginas apuntan a la misma intención, ocurren tres cosas malas de forma mecánica:
- Los enlaces externos e internos se reparten entre las dos URLs, así que ninguna acumula autoridad.
- El paso de deduplicación del motor puede fusionarlas y elegir su propia canónica.
- Tus analíticas también se reparten, así que ya no puedes saber si el tema está funcionando.
| Clase de intención | La reconoces porque | Enrútala a |
|---|---|---|
| Educativa (“qué es la optimización para motores de respuestas”) | Los resultados son definiciones y guías | Una página de definición como Qué es AEO |
| Comercial (“software de seguimiento de visibilidad en IA”) | Los resultados son páginas de producto | Una única página de producto |
| Diagnóstica (“comprobador de SEO gratis”) | Los resultados son herramientas interactivas | Una página de herramienta como el analizador de SEO |
| Comparativa (“mejores herramientas de AI SEO”) | Los resultados son listas rankeadas | Una única página comparativa |
| Soporte (“cómo cancelar X”) | Los resultados son documentación y centros de ayuda | Contenido de ayuda, normalmente con los términos de competidores retirados y noindexados |
Los enlaces internos hacen dos trabajos
Los enlaces internos no son adorno de navegación. Hacen dos trabajos mecánicos. Primero, descubrimiento: los rastreadores encuentran nuevas URLs siguiendo enlaces, así que una página que nadie enlaza (una “huérfana”) puede que nunca entre en el pipeline, aunque esté en tu sitemap. Segundo, contexto: el texto ancla es una etiqueta. Un enlace que dice “auditoría de SEO técnico” les dice tanto a Google como a un sistema de recuperación LLM de qué trata la página de destino; un enlace que dice “haz clic aquí” no les dice nada.
Dos reglas prácticas: cada página que te importe debería ser alcanzable en tres clics desde la página de inicio, y cada texto ancla debería ser una consulta de búsqueda verosímil para su destino.
Ejemplo práctico: una función, cinco consultas
Una empresa de SaaS B2B que vende seguimiento de citas recopila cinco frases de llamadas de ventas y de la investigación de palabras clave. Aquí está la decisión de propiedad para cada una, con el razonamiento detallado:
| Consulta o prompt | Lo que muestra el SERP | Decisión |
|---|---|---|
| “qué es la optimización para motores de respuestas” | Guías de definición | Educativa. La posee la página de definición. No crees un segundo explicativo. |
| “software de seguimiento de visibilidad en IA” | Páginas de producto | Comercial. La posee la página de producto. Mejórala, nunca la bifurques. |
| “comprobador de SEO gratis” | Herramientas interactivas | Diagnóstica. La posee una página de herramienta. Una entrada de blog no puede ganar esta intención. |
| “mejores herramientas de AI SEO” | Listas comparativas rankeadas | Comparativa. La posee una única página comparativa que lista a los competidores con honestidad. |
| “fundamentos de SEO para fundadores” | Cursos y guías | Educativa, amplia. Intégrala en el hub del curso en lugar de en una nueva página fina. |
Fíjate en lo que no ocurrió: nadie propuso cinco páginas nuevas. Cuatro de las cinco intenciones ya tenían propietaria. El resultado del trabajo de fundamentos suele ser un plan de contenidos más corto, no más largo.
Ejercicio: la auditoría de fundamentos de 30 minutos
Haz esto hoy en tu propio sitio. Necesitas un navegador y una terminal.
- Comprueba la respuesta. Ejecuta
curl -I https://yoursite.com/your-page. Quieres un único200, no una cadena de redirecciones ni un404detrás de una página de error bonita. - Lee tu robots.txt. Abre
https://yoursite.com/robots.txt. Confirma que la ruta de tu página no está bloqueada y luego busca específicamente bloqueos deGPTBot,OAI-SearchBot,ClaudeBot,PerplexityBotyGoogle-Extendedque no recuerdes haber añadido. - Comprueba el índice. En Google Search Console, usa la Inspección de URL sobre la página. Te dice directamente si la página está indexada y qué canónica seleccionó Google.
- Comprueba el renderizado. Usa “ver código fuente de la página” (no el inspector de las herramientas de desarrollo) y busca la primera frase de tu contenido principal. Si no está en el HTML en bruto, depende de JavaScript para existir.
- Construye el mapa de propiedad. Enumera diez consultas o preguntas de compradores para un área de producto, etiqueta cada una con una clase de intención de la tabla de arriba y asigna una única URL canónica a cada una. Marca las colisiones (dos páginas reclamando una misma intención) como candidatas a fusión.
Si los pasos 1 a 4 pasan y el paso 5 produce un mapa limpio, tienes una base sobre la que merece la pena construir.
Errores habituales
- Publicar una página por variante de palabra clave. “herramienta de AEO”, “software de AEO” y “plataforma de AEO” son una sola intención. Tres páginas significa tres páginas débiles.
- Diagnosticar el contenido antes que el pipeline. Reescribir texto en una página noindexada es la semana perdida más habitual en SEO.
- Un robots.txt de denegación total obsoleto. Bloquear todos los user agents de IA era un valor por defecto defendible en 2023; hoy te elimina en silencio de la superficie de descubrimiento que más rápido crece.
- Un noindex olvidado de staging. Llega a producción más a menudo de lo que nadie admite. Compruébalo explícitamente en el lanzamiento.
- Páginas huérfanas. En el sitemap pero sin enlaces desde ninguna parte. Los rastreadores las despriorizan y los usuarios nunca las encuentran.
Dónde AEO Goal automatiza esto
Todo lo del ejercicio de arriba se puede hacer a mano, y deberías hacerlo a mano una vez para entender la mecánica. En producción, AEO Goal ejecuta las mismas comprobaciones como un escaneo gratuito del lado del servidor: acceso al robots.txt para los rastreadores de búsqueda y de IA, llms.txt, cobertura del sitemap, datos estructurados y metadatos. La diferencia frente a una lista de comprobación es el bucle: cada hallazgo llega con una corrección concreta, y el siguiente escaneo vuelve a comprobar si la corrección se aplicó en lugar de dejarte con un documento de auditoría obsoleto.
Repaso y siguiente módulo
Ahora tienes las dos herramientas de las que depende cada módulo posterior: el diagnóstico del pipeline (rastreo, renderizado, indexación, entrega, siempre en ese orden) y el mapa de propiedad (una intención, una URL canónica). La guía de inicio de SEO de Google es la referencia externa canónica si quieres profundizar en cualquier etapa concreta.
El Módulo 2 cambia la pregunta. En lugar de “¿pueden los motores encontrar y posicionar esta página?”, pregunta “cuando un sistema de IA responde a la pregunta de un comprador, ¿nos menciona, nos cita y nos describe correctamente?”. Continúa con Fundamentos de la optimización para motores de respuestas.