Le correctif le moins cher de l’AEO
L’accès des robots est le module le moins glamour de cette certification et celui au rendement le plus élevé par heure. Chaque amélioration d’entité, chaque réécriture answer-first, chaque bloc de schema vaut exactement zéro sur une page qu’un système d’IA ne peut pas récupérer. Les échecs d’accès sont aussi silencieux : rien sur la page n’a l’air cassé, le trafic de Google classique peut être correct, et le seul symptôme est que les réponses d’IA ne vous citent jamais. Ce module vous apprend à écarter l’accès en premier, avec des preuves, avant de dépenser la moindre heure de contenu.
Le modèle d’accès à quatre couches
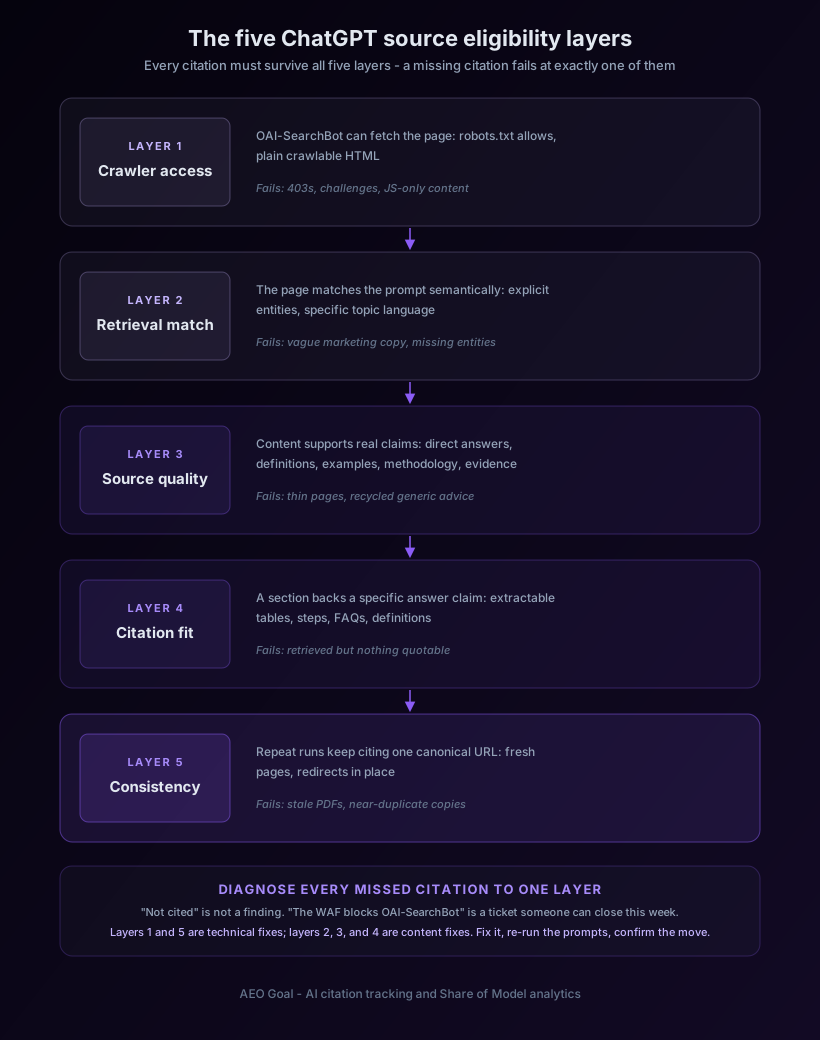
Une citation doit survivre à quatre couches, dans l’ordre. Une citation manquante causée par l’accès échoue à exactement l’une d’elles, et le diagnostic diffère à chaque couche.
| Couche | Question | Où elle se casse |
|---|---|---|
| Découverte | Le système peut-il trouver l’URL tout court ? | Absente du sitemap, aucun lien interne, routes orphelines, mauvais canonical. |
| Récupération | Une requête du robot renvoie-t-elle le contenu ? | Disallow dans robots.txt, 403 de WAF ou de protection anti-bots, blocages géographiques, murs de connexion. |
| Extraction | La réponse est-elle présente dans le HTML récupéré ? | Rendu uniquement en JavaScript, contenu injecté côté client, réponse enterrée dans le texte standard. |
| Éligibilité | Le contenu extrait est-il utilisable comme source ? | Aucune réponse directe, aucune date, canonicals contradictoires, pages dupliquées se concurrençant. |
La discipline que ce module ancre : vérifiez les couches dans l’ordre et n’inférez jamais une couche supérieure à partir d’une inférieure. Le fait qu’une page soit dans le sitemap ne dit rien sur le fait qu’un robot obtienne un 200. Un 200 ne dit rien sur le fait que la réponse survive à l’extraction.
Robots d’entraînement vs robots de récupération
Le fait le plus lourd de conséquences de ce module : les grands fournisseurs d’IA exploitent différents robots pour différentes tâches, et en bloquer un n’en bloque pas un autre. Le GPTBot d’OpenAI recueille des données d’entraînement, tandis que son robot de recherche récupère des pages pour fonder les réponses en direct ; Anthropic, Perplexity et Google font des distinctions similaires, les surfaces d’IA de Google s’appuyant sur l’indexation ordinaire de Googlebot tandis qu’un jeton distinct régit les autres usages génératifs. Les noms et les politiques changent avec le temps ; les catégories non.
Cette division produit deux erreurs coûteuses et opposées :
- Le blocage global de 2023. De nombreux sites ont ajouté des règles bloquant tous les user agents d’IA pendant les premiers débats sur les données d’entraînement et ne les ont jamais réexaminées. Ces règles bloquent maintenant aussi les robots de récupération qui citeraient le site dans les réponses en direct. Le site paie une taxe de visibilité continue pour une décision de politique que personne ne se souvient d’avoir prise.
- Le faux sentiment de contrôle. Les équipes bloquent un robot d’entraînement et croient s’être retirées des réponses d’IA, ou autorisent un robot et croient être entièrement accessibles. Ni l’un ni l’autre ne suit. L’accès doit être audité par user agent, par tâche, par rapport à la documentation actuelle du fournisseur, car les fournisseurs ajoutent et renomment des robots régulièrement.
La règle de décision : décidez votre politique de données d’entraînement et votre politique de visibilité dans les réponses séparément, écrivez les deux, et auditez robots.txt par rapport aux listes de user agents publiées actuelles selon une cadence, pas une seule fois.
Les échecs que les audits robots.txt ne voient jamais
Une vérification de robots.txt est nécessaire et follement insuffisante. L’inventaire des échecs du module :
- 403 de WAF et de protection anti-bots. L’atténuation des bots par les CDN défie ou bloque fréquemment les robots d’IA par défaut, à une couche que robots.txt ne voit jamais. La page semble autorisée sur le papier et renvoie un 403 en pratique. La preuve se trouve dans les journaux du serveur ou du CDN : filtrez les user agents d’IA et lisez les codes de statut qu’ils ont réellement reçus.
- Contenu uniquement en JavaScript. La plupart des récupérateurs d’IA lisent le HTML brut et n’exécutent pas le JavaScript. Si le paragraphe de réponse est rendu côté client, le document récupéré est une coquille vide. Le test prend dix secondes : récupérez l’URL avec un client HTTP simple et cherchez votre phrase clé dans la réponse.
- Réponses lentes ou instables. La récupération en direct se produit au moment de répondre avec des budgets serrés. Une page qui met plusieurs secondes à répondre perd face à une page plus rapide portant la même information.
- Lacunes de découverte. Une page exclue du sitemap avec des liens internes faibles peut rester atteignable pour les utilisateurs et invisible pour les systèmes qui découvrent via ces chemins.
llms.txt, honnêtement
llms.txt est une convention émergente : un index en texte brut de vos pages canoniques et de ce qu’elles couvrent, placé à la racine du site pour que les systèmes d’IA le lisent. Cadrage honnête, sur lequel le module insiste : ce n’est pas un standard que chaque moteur consomme, et ce n’est pas un levier de classement ou de citation. Il coûte quelques minutes, ne peut pas nuire, et donne aux systèmes qui le lisent une carte propre de vos URL canoniques. Livrez-le, gardez-le exact, et n’en attendez rien de magique. Le scan gratuit d’AEO Goal vérifie robots.txt sur seize user agents d’IA plus la présence de llms.txt dans le cadre de sa vérification d’accès, ce qui est un moyen rapide d’établir une base de référence pour un domaine avant le travail manuel sur les journaux.
Exemple travaillé
Un site de documentation se demande pourquoi ChatGPT ne le cite jamais malgré un excellent contenu. robots.txt a l’air propre pour les moteurs de recherche. L’audit trouve une règle datant de 2023 bloquant les robots d’OpenAI en bloc, et les journaux du CDN montrent le robot de Perplexity recevant des défis de protection anti-bots. Deux correctifs, zéro changement de contenu : mettre à jour robots.txt pour refléter une décision de politique réelle sur l’entraînement vs la récupération, et mettre en liste d’autorisation les robots d’IA vérifiés dans le CDN. La revérification quelques semaines plus tard s’exécute contre le même ensemble de prompts, car c’est la seule preuve qui compte.
Ce qui se débloque après le paiement
Le module payant comprend le SOP d’accès des robots (l’audit complet dans l’ordre d’exécution, du sitemap aux journaux), la liste de vérification robots.txt par rapport à une liste maintenue de user agents d’IA, la liste de vérification llms.txt, et la feuille de validation pour enregistrer les preuves par agent et par couche afin que l’audit soit reproductible et défendable.
Devoir
Choisissez une page qui devrait être citée pour un prompt réel. Vérifiez les quatre couches avec des preuves : présence dans le sitemap, une récupération réelle en tant que user agent d’IA, la phrase de réponse clé présente dans le HTML brut, et un canonical propre. Notez quelle couche vous n’avez pas pu vérifier et pourquoi. Utilisez l’outil d’audit SEO technique ou le générateur de robots.txt si vous avez besoin d’un échafaudage.
Précédent et suivant
Précédent : Prominence des entités et autorité de marque. Suivant : Mise en correspondance avancée mots-clés vers prompts.