El arreglo más barato del AEO
El acceso de los rastreadores es el módulo menos vistoso de esta certificación y el que ofrece mayor retorno por hora. Cada mejora de entidad, cada reescritura orientada a la respuesta, cada bloque de esquema vale exactamente cero en una página que un sistema de IA no puede obtener. Los fallos de acceso, además, son silenciosos: nada en la página parece roto, el tráfico del Google clásico puede ir bien y el único síntoma es que las respuestas de IA nunca te citan. Este módulo te enseña a descartar el acceso primero, con evidencias, antes de invertir una sola hora en contenido.
El modelo de acceso de cuatro capas
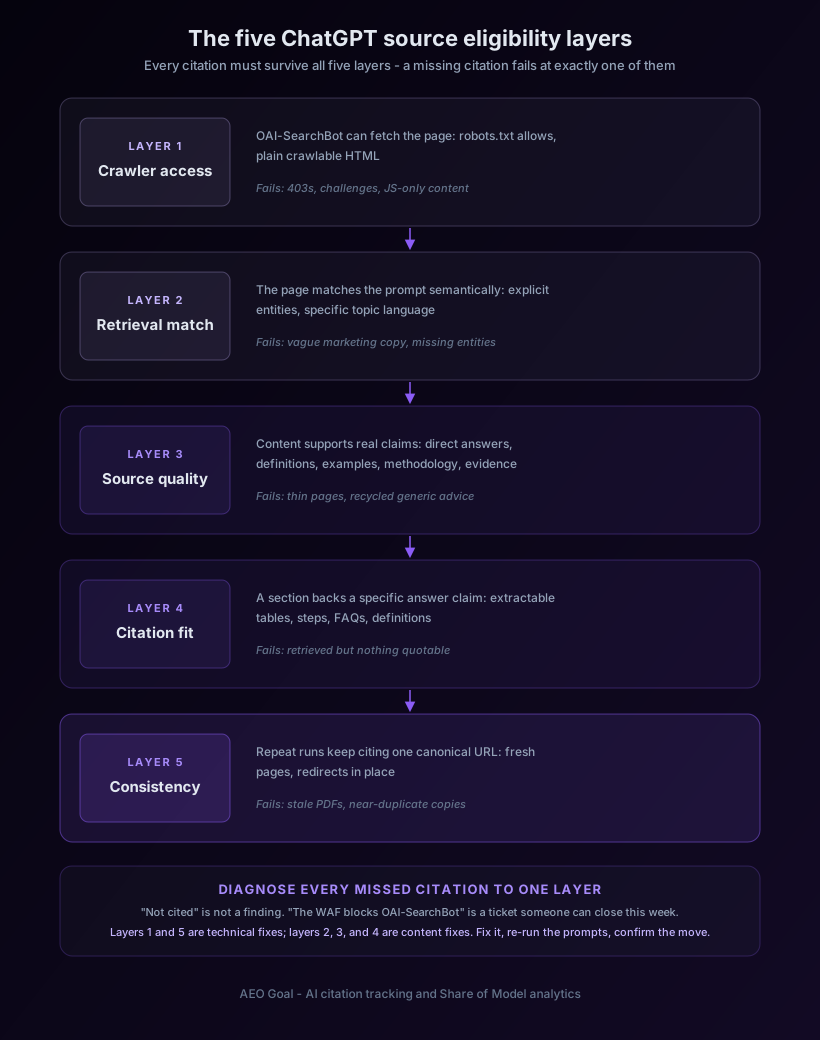
Una cita tiene que superar cuatro capas en orden. Una cita ausente causada por el acceso falla en exactamente una de ellas, y el diagnóstico difiere en cada una.
| Capa | Pregunta | Dónde se rompe |
|---|---|---|
| Descubrimiento | ¿Puede el sistema encontrar la URL siquiera? | Ausente del sitemap, sin enlaces internos, rutas huérfanas, canonical incorrecto. |
| Obtención | ¿Una petición del rastreador devuelve el contenido? | Disallow en robots.txt, 403 de WAF o de protección antibots, bloqueos geográficos, muros de inicio de sesión. |
| Extracción | ¿Está la respuesta presente en el HTML obtenido? | Renderizado solo en JavaScript, contenido inyectado en el cliente, respuesta enterrada entre elementos de relleno. |
| Elegibilidad | ¿El contenido extraído es utilizable como fuente? | Sin respuesta directa, sin fechas, canonical en conflicto, páginas duplicadas que compiten entre sí. |
La disciplina que este módulo entrena: verifica las capas en orden y nunca infieras una capa superior a partir de una inferior. Que una página esté en el sitemap no dice nada sobre si un rastreador obtiene un 200. Un 200 no dice nada sobre si la respuesta sobrevive a la extracción.
Rastreadores de entrenamiento frente a rastreadores de recuperación
El hecho más determinante de este módulo: los principales proveedores de IA ejecutan distintos rastreadores para distintas tareas, y bloquear uno no bloquea el otro. El GPTBot de OpenAI recopila datos de entrenamiento, mientras que su rastreador de búsqueda obtiene páginas para fundamentar respuestas en directo; Anthropic, Perplexity y Google hacen distinciones similares, y las superficies de IA de Google se nutren de la indexación habitual de Googlebot mientras que un token independiente rige otros usos generativos. Los nombres y las políticas cambian con el tiempo; las categorías no.
Esta división produce dos errores costosos y opuestos:
- El bloqueo generalizado de 2023. Muchos sitios añadieron reglas que bloqueaban todos los agentes de usuario de IA durante los primeros debates sobre los datos de entrenamiento y nunca las revisaron. Esas reglas ahora también bloquean a los rastreadores de recuperación que citarían al sitio en respuestas en directo. El sitio paga un impuesto de visibilidad permanente por una decisión de política que nadie recuerda haber tomado.
- La falsa sensación de control. Los equipos bloquean un rastreador de entrenamiento y creen que se han excluido de las respuestas de IA, o permiten uno y creen que son totalmente accesibles. Ninguna de las dos cosas se sigue. El acceso debe auditarse por agente de usuario, por tarea, frente a la documentación vigente del proveedor, porque los proveedores añaden y renombran rastreadores con regularidad.
La regla de decisión: decide tu política de datos de entrenamiento y tu política de visibilidad en respuestas por separado, ponlas ambas por escrito y audita robots.txt frente a las listas de agentes de usuario publicadas y vigentes de forma periódica, no una sola vez.
Los fallos que las auditorías de robots.txt nunca ven
Una comprobación de robots.txt es necesaria y tremendamente insuficiente. El inventario de fallos del módulo:
- 403 de WAF y de protección antibots. La mitigación de bots del CDN a menudo desafía o bloquea a los rastreadores de IA por defecto, en una capa que robots.txt nunca ve. La página parece permitida sobre el papel y devuelve un 403 en la práctica. La evidencia vive en los registros del servidor o del CDN: filtra por los agentes de usuario de IA y lee los códigos de estado que realmente recibieron.
- Contenido solo en JavaScript. La mayoría de los recuperadores de IA leen el HTML en bruto y no ejecutan JavaScript. Si el párrafo de la respuesta se renderiza en el cliente, el documento obtenido es un cascarón vacío. La prueba lleva diez segundos: obtén la URL con un cliente HTTP sencillo y busca tu frase clave en la respuesta.
- Respuestas lentas o inestables. La recuperación en directo ocurre en el momento de la respuesta con presupuestos ajustados. Una página que tarda muchos segundos en responder pierde frente a una página más rápida que lleva la misma información.
- Lagunas de descubrimiento. Una página excluida del sitemap y con enlaces internos escasos puede seguir siendo accesible para los usuarios e invisible para los sistemas que descubren a través de esas rutas.
llms.txt, con honestidad
llms.txt es una convención emergente: un índice en texto plano de tus páginas canónicas y de lo que cubren, colocado en la raíz del sitio para que los sistemas de IA lo lean. El planteamiento honesto, en el que el módulo insiste: no es un estándar que consuman todos los motores, y no es una palanca de posicionamiento ni de citación. Cuesta minutos, no puede hacer daño y ofrece a los sistemas que sí lo leen un mapa limpio de tus URL canónicas. Publícalo, mantenlo actualizado y no esperes nada mágico de él. El análisis gratuito de AEO Goal comprueba robots.txt en dieciséis agentes de usuario de IA más la presencia de llms.txt como parte de su verificación de acceso, lo que constituye una forma rápida de tomar una referencia base de un dominio antes del trabajo manual con los registros.
Ejemplo práctico
Un sitio de documentación se pregunta por qué ChatGPT nunca lo cita a pesar de tener un contenido excelente. robots.txt parece limpio para los motores de búsqueda. La auditoría encuentra una regla de la era de 2023 que bloquea por completo a los rastreadores de OpenAI, y los registros del CDN muestran que el rastreador de Perplexity recibe desafíos de protección antibots. Dos arreglos, cero cambios de contenido: actualizar robots.txt para reflejar una decisión de política real sobre entrenamiento frente a recuperación, e incluir en la lista de permitidos a los rastreadores de IA verificados en el CDN. La reverificación, semanas después, se ejecuta contra el mismo conjunto de prompts, porque esa es la única evidencia que importa.
Qué se desbloquea tras la compra
El módulo de pago incluye el procedimiento (SOP) de acceso de rastreadores (la auditoría completa en orden de ejecución, del sitemap a los registros), la lista de comprobación de robots.txt frente a una lista mantenida de agentes de usuario de IA, la lista de comprobación de llms.txt y la hoja de validación para registrar la evidencia por agente y por capa, de modo que la auditoría sea repetible y defendible.
Tarea
Elige una página que debería citarse para un prompt real. Verifica las cuatro capas con evidencias: presencia en el sitemap, una obtención real como agente de usuario de IA, la frase clave de la respuesta presente en el HTML en bruto y un canonical limpio. Anota qué capa no pudiste verificar y por qué. Usa la herramienta de auditoría de SEO técnico o el generador de robots.txt si necesitas una estructura de partida.
Anterior y siguiente
Anterior: Relevancia de entidades y autoridad de marca. Siguiente: Asignación avanzada de palabras clave a prompts.