Réponse rapide
AEO Goal mesure la visibilité dans l’IA en exécutant un jeu de prompts stable et défini par le client sur les moteurs de réponse d’IA configurés, selon une cadence par prompt, en détectant de façon déterministe les mentions de la marque et des concurrents par rapport aux noms et alias configurés, en excluant les lignes d’espace réservé et synthétiques, et en calculant le Share of Model comme les mentions de la marque divisées par le total des réponses suivies. Les rapports ajoutent une variante pondérée par la qualité, un intervalle de confiance de Wilson à 95% et un delta par rapport à la période précédente pour que les équipes ne réagissent pas de façon excessive aux oscillations d’une seule réponse.
Cette page est rédigée pour qu’un analyste puisse retracer n’importe quel chiffre principal jusqu’aux lignes stockées et le recalculer. Elle couvre la couche des mentions de la mesure ; la couche des URL sources, y compris la façon dont les URL citées sont vérifiées avant d’être comptées, se trouve dans la méthodologie de suivi des citations dans l’IA.
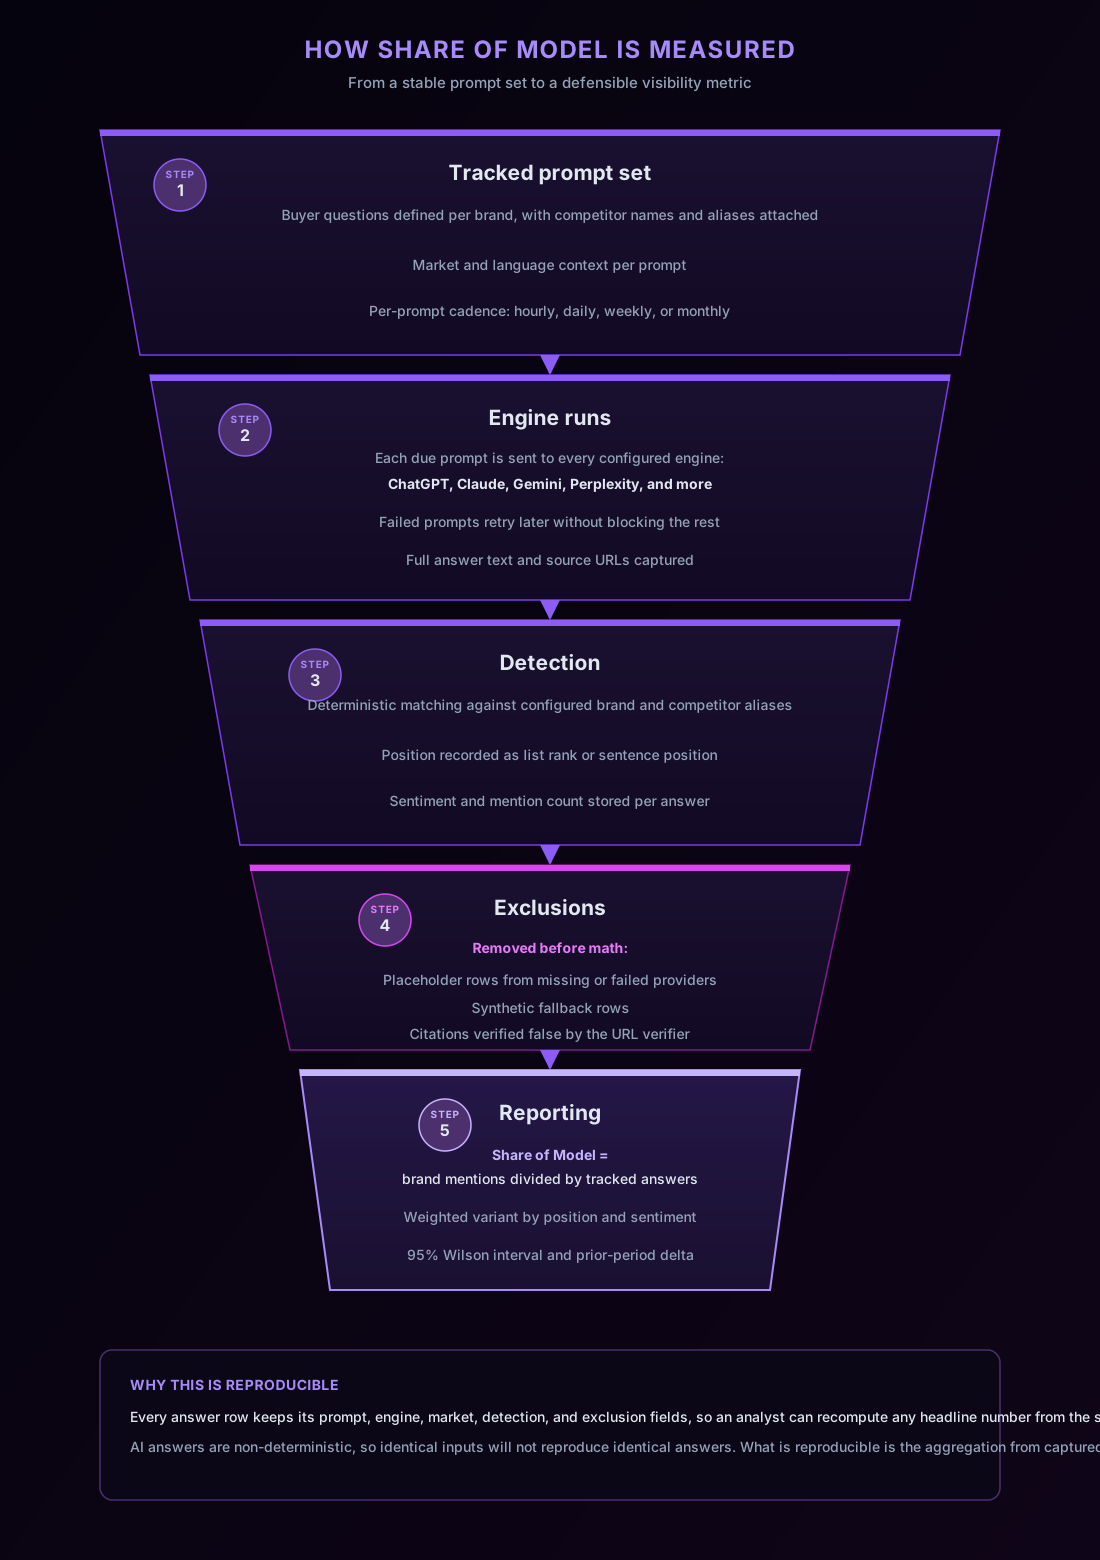
Comment le jeu de prompts est construit
Chaque métrique de visibilité est conditionnée par le jeu de prompts, c’est pourquoi le jeu de prompts est explicite et contrôlé par le client plutôt qu’un échantillon opaque :
- Les prompts sont des questions d’acheteur, définies par marque. Un prompt suivi est une question qu’un acheteur poserait à un moteur de réponse, rattachée à une marque avec les noms, alias et concurrents nommés de cette marque. Les outils de recherche de prompts peuvent proposer des candidats à partir de la catégorie, des concurrents et du contenu de la marque, mais rien n’est suivi tant qu’un utilisateur ne l’a pas ajouté.
- Les prompts portent un contexte de marché. Les paramètres de pays, de langue et de localité peuvent être appliqués par prompt, et les champs de marché sont persistés avec chaque ligne de résultats pour que la visibilité puisse être segmentée par localisation. Les allocations de marché varient selon le plan et sont détaillées sur la page de tarifs.
- La stabilité est le levier de contrôle de l’analyste. Le même texte de prompt est réexécuté à chaque cycle. Modifier les prompts en milieu de fenêtre change l’échantillon, et c’est cela, et non le comportement du moteur, qui est la cause la plus fréquente d’un saut surprenant. Ne comparez des périodes qu’entre un jeu de prompts stable.
Couverture des plateformes
AEO Goal inclut des adaptateurs de crawl pour ChatGPT, Claude, Perplexity, Gemini, Google AI Overview, Microsoft Copilot, Grok, Meta AI et DeepSeek. Ce sont des chemins de plateforme pris en charge par le code ; la couverture en direct d’un compte donné est toujours le sous-ensemble avec des identifiants configurés et des chemins de crawl activés, et les rapports publics devraient conserver cette distinction.
Lorsqu’une clé de fournisseur est absente ou qu’un appel échoue, l’adaptateur renvoie une ligne de remplissage qui est écartée avant la persistance. Les lignes synthétiques de repli, comme les replis synthétiques de Google AI Overview, sont exclues du Share of Model et du calcul des performances de citation visibles par le client. Un échec réduit donc la taille de l’échantillon au lieu d’injecter des réponses vides, ce qui est la direction honnête vers laquelle l’erreur doit pointer.
Cadence de crawl
La visibilité est mesurée selon une planification, pas en temps réel. Chaque prompt suivi a sa propre fréquence de vérification configurée, avec des cadences prises en charge de l’heure au mois, et les flux de travail récurrents payants s’exécutent sur des chemins de planification distincts de ceux des flux d’essai et d’onboarding. Les échecs sont isolés par prompt : un prompt en échec est réessayé lors d’un cycle ultérieur, de sorte qu’une panne d’un fournisseur ne bloque pas le reste de la file d’un client.
Pour l’audit, l’implication est que le nombre de lignes par moteur à l’intérieur d’une fenêtre peut légitimement différer. Une panne de fournisseur, l’ajout d’un prompt en milieu de fenêtre ou un changement de cadence modifient tous le dénominateur, et chacun est visible dans les lignes stockées.
Détection de la marque et des concurrents
La détection est déterministe et auditable. Chaque réponse capturée est comparée aux noms et alias de la marque et aux noms des concurrents configurés dans la configuration de suivi. Le détecteur enregistre si la marque est apparue, le nombre de mentions, quels concurrents sont apparus, le sentiment et la position : rang dans la liste lorsque la réponse est une liste structurée, position dans la phrase lorsqu’il s’agit de prose. Une correspondance littérale authentique est requise ; une réponse qui se contente de reprendre le prompt ou qui indique explicitement que la marque est absente ne compte pas comme une mention favorable.
Ce n’est délibérément pas une résolution complète d’entités par TAL ni une désambiguïsation de marques déposées. Une faute de frappe ou un alias non configuré passeront inaperçus, et compléter la liste des alias dans la configuration de suivi est la moitié de la qualité de détection qui revient au client. Le compromis est intentionnel : une règle qu’une équipe peut inspecter et reproduire vaut mieux qu’un verdict de modèle qu’elle ne peut pas.
La formule du Share of Model
Le Share of Model est le pourcentage de réponses d’IA suivies qui mentionnent la marque :
| Métrique | Calcul |
|---|---|
| Mentions de la marque | Nombre de réponses suivies où la marque a été détectée. |
| Total des requêtes | Nombre de réponses suivies dans la fenêtre sélectionnée après exclusions. |
| Share of Model | (mentions de la marque / total des requêtes) * 100. |
| Share of Model pondéré | Moyenne pondérée par la qualité où les non-mentions contribuent pour zéro et les réponses avec mention sont pondérées selon la position de la citation et le sentiment. |
À titre d’exemple travaillé avec des chiffres illustratifs : si une fenêtre contient 200 réponses suivies après exclusions et que la marque a été détectée dans 50 d’entre elles, le Share of Model est de 25%. Si la plupart de ces mentions étaient tardives dans la réponse ou de ton neutre, la variante pondérée se situe en dessous de 25%, car la pondération récompense un placement précoce et positif et attribue zéro aux non-mentions.
Les exclusions dans le dénominateur sont celles définies ci-dessus et dans la méthodologie des citations : les lignes de remplissage ne sont jamais persistées, les replis synthétiques sont exclus, et les citations explicitement vérifiées fausses sont retirées tandis que les vérifications en attente restent comptabilisées jusqu’à leur résolution.
Intervalles de confiance et mouvement
Les rapports peuvent inclure un intervalle de confiance de Wilson à 95% autour du Share of Model et un delta par rapport à la fenêtre de durée égale immédiatement précédente. L’intervalle de Wilson est utilisé parce qu’il se comporte de façon sensée avec de petites tailles d’échantillon et près de 0% ou 100%, ce qui est exactement là où se situent les données de visibilité au niveau du prompt.
La règle de lecture est simple : un mouvement à l’intérieur de l’intervalle est indiscernable du bruit d’échantillonnage ; un mouvement au-delà, soutenu sur plusieurs cycles, est une tendance. Les petits jeux de prompts produisent des intervalles larges, ce qui est la façon honnête de dire que dix prompts ne peuvent pas soutenir une conclusion au niveau du point de pourcentage. Les équipes qui ont besoin d’intervalles plus resserrés devraient ajouter des prompts ou allonger les fenêtres plutôt que de lire dans le chiffre plus de précision que n’en contient l’échantillon.
Gestion du marché et de la localisation
Les prompts suivis s’exécutent avec un contexte de marché persisté, de sorte que la visibilité peut être segmentée par localisation à une granularité nationale, régionale ou de ville, avec des paramètres de pays et de langue. La tâche de crawl applique le contexte de marché au prompt et écrit les champs de marché sur les lignes résultantes ; la segmentation au moment de la lecture est un filtre sur ces champs, pas une nouvelle estimation. Les limites de plan déterminent le nombre de marchés qu’un compte peut configurer.
Données incluses dans les rapports
Chaque ligne de réponse suivie porte les champs nécessaires pour recalculer n’importe quel agrégat :
| Champ | Objet |
|---|---|
| Plateforme d’IA | Le moteur de réponse ou le chemin de crawl qui a produit la réponse. |
| Version du modèle | L’étiquette de version du modèle ou du crawler enregistrée avec la réponse. |
| Marque mentionnée | Si la marque suivie est apparue, et le nombre de mentions. |
| Concurrents mentionnés | Quels concurrents configurés sont apparus dans la réponse. |
| Position de la citation | Rang dans la liste ou position dans la phrase où la marque est apparue. |
| Score de sentiment et de qualité | Signaux utilisés pour pondérer la qualité de la réponse. |
| Champs de marché | Contexte de localisation persisté pour la segmentation au niveau du marché. |
| URL sources | URL citées ou extraites de la réponse, lorsqu’elles sont disponibles. |
Comme les lignes sont délimitées au locataire et autodescriptives, un analyste disposant d’un export peut reconstruire le Share of Model, la variante pondérée et le chevauchement des concurrents pour n’importe quelle fenêtre et n’importe quel filtre, ce qui est le test pratique d’une méthode reproductible.
Versionnage de la méthode
La date lastUpdated sur cette page est le marqueur de version de la méthode. Lorsqu’une formule, une règle de détection ou une règle d’exclusion change d’une manière susceptible de modifier les chiffres rapportés, cette page est mise à jour pour décrire le nouveau comportement. Les agrégats sont calculés à partir des lignes stockées au moment de la lecture, de sorte qu’un changement de règle modifie la façon dont l’historique est agrégé, et non les lignes capturées elles-mêmes ; les analystes qui comparent de longues plages devraient lire les règles actuelles au regard de leur fenêtre.
Limites
Dit clairement, car une méthodologie de visibilité qui admet la variance est plus utile qu’une méthodologie qui promet la certitude :
- Non-déterminisme. Le même prompt sur le même moteur peut renvoyer des réponses différentes à quelques minutes d’intervalle. Les réponses individuelles sont des anecdotes ; la méthode est conçue pour les tendances sur des jeux de prompts stables.
- Limites d’échantillonnage. Les métriques décrivent les prompts suivis, pas tout ce que demandent les acheteurs. Des intervalles de Wilson larges sur de petits jeux sont le système qui vous dit que l’échantillon est mince.
- Aucun contrôle sur les moteurs. AEO Goal ne garantit ni classements, ni citations, ni inclusion dans les réponses. Les plateformes d’IA tierces contrôlent leurs propres réponses et les modifient sans préavis.
- La couverture est configuration. Les identifiants, les chemins de crawl activés, les marchés et la cadence façonnent tous l’échantillon. Les comparaisons entre périodes ne sont valides qu’à configuration stable.
- Détection bornée par les alias. La correspondance déterministe passe à côté des noms qui n’ont jamais été configurés.
- Prudence avec Google AI Overview. Les lignes réelles capturées comptent ; les lignes de repli local synthétiques sont exclues du calcul visible par le client et ne doivent jamais être lues comme une mesure.
Recommandation pour les entreprises
Traitez la visibilité dans l’IA comme une mesure de tendance, pas comme un verdict d’une seule réponse. Utilisez des jeux de prompts stables, des marchés documentés, une cadence reproductible, la transparence sur les plateformes configurées, des citations vérifiées et des intervalles de confiance avant de prendre des décisions de stratégie ou d’achat. Lisez la méthodologie de suivi des citations dans l’IA pour savoir comment les sources citées sont vérifiées, la page produit de suivi de la visibilité dans l’IA pour voir comment ces métriques émergent dans le produit, et AEO face au SEO traditionnel pour cadrer le Share of Model auprès des parties prenantes habituées aux classements de mots-clés.